Início › Dados de pesquisa › Quanto tempo duram SSDs e HDs? Taxas de falha (2026)
Dados de pesquisa
Quanto tempo duram SSDs e HDs? Estatísticas de vida útil e de taxa de falha
Quanto duram SSDs e HDs e com que frequência falham: o 1,36% ao ano da Backblaze, estudos de campo, TBW, unidades externas e os mitos, com fontes.
Principais estatísticas de vida útil de HDs e SSDs
- Os HDs dos data centers de uma empresa de nuvem falharam a uma taxa anualizada de 1,36% em 2025, em 344.196 unidades (2026).
- Os HDs foram substituídos a 3,01% ao ano em sete grandes sistemas, contra 0,58% a 0,88% nas suas fichas técnicas (2007).
- 0,22% dos SSDs corporativos nos clientes de um fabricante de sistemas de armazenamento foram substituídos por ano, de 2017 a 2019 (2020).
- Quase 98% das falhas de SSD num data center ocorreram antes que metade dos ciclos de gravação nominais tivesse sido usada (2019).
- As unidades de boot SSD falharam a 0,92% ao ano no quinto ano, contra 3,55% dos HDs da mesma idade (2022).
- 38% dos SSDs que falharam em grandes data centers não mostraram antes nenhum de quatro sinais de alerta do SMART (2016).
- Um SSD Samsung 850 Pro de 256 GB gravou cerca de 9,1 PB antes de falhar, 60 vezes a sua classificação (2017).
- As remessas mundiais de HDs somaram 124,3 milhões de unidades em 2025, cerca de um quinto dos 651 milhões de 2010 (2026).
Fontes: Backblaze (2026, 2022); Carnegie Mellon University; USENIX, Proceedings of the 18th USENIX Conference on File and Storage Technologies; ACM / IEEE, Proceedings of the International Conference; ACM, Proceedings of the 9th ACM International Systems and Storage Conference; heise online / c't magazin; Forbes
Quanto tempo dura um SSD, com que frequência os HDs falham e qual dura mais? As respostas que costumam ser dadas, de três a cinco anos para um HD e de cinco a dez para um SSD, não têm nenhum estudo por trás. Esta página reúne o que foi medido: as contagens de falhas que a Backblaze publica para as unidades dos seus data centers desde 2013, os estudos de campo do Google, da Carnegie Mellon, da Microsoft, da NetApp e da Alibaba, os registros de varejistas e de laboratórios de recuperação, as classificações dos fabricantes e os testes que gravaram em unidades até elas morrerem, cada um com sua medida, sua data e sua fonte. Ela também diz onde nada foi medido, como no caso das unidades externas e dos PCs domésticos.
Com que frequência os HDs falham?
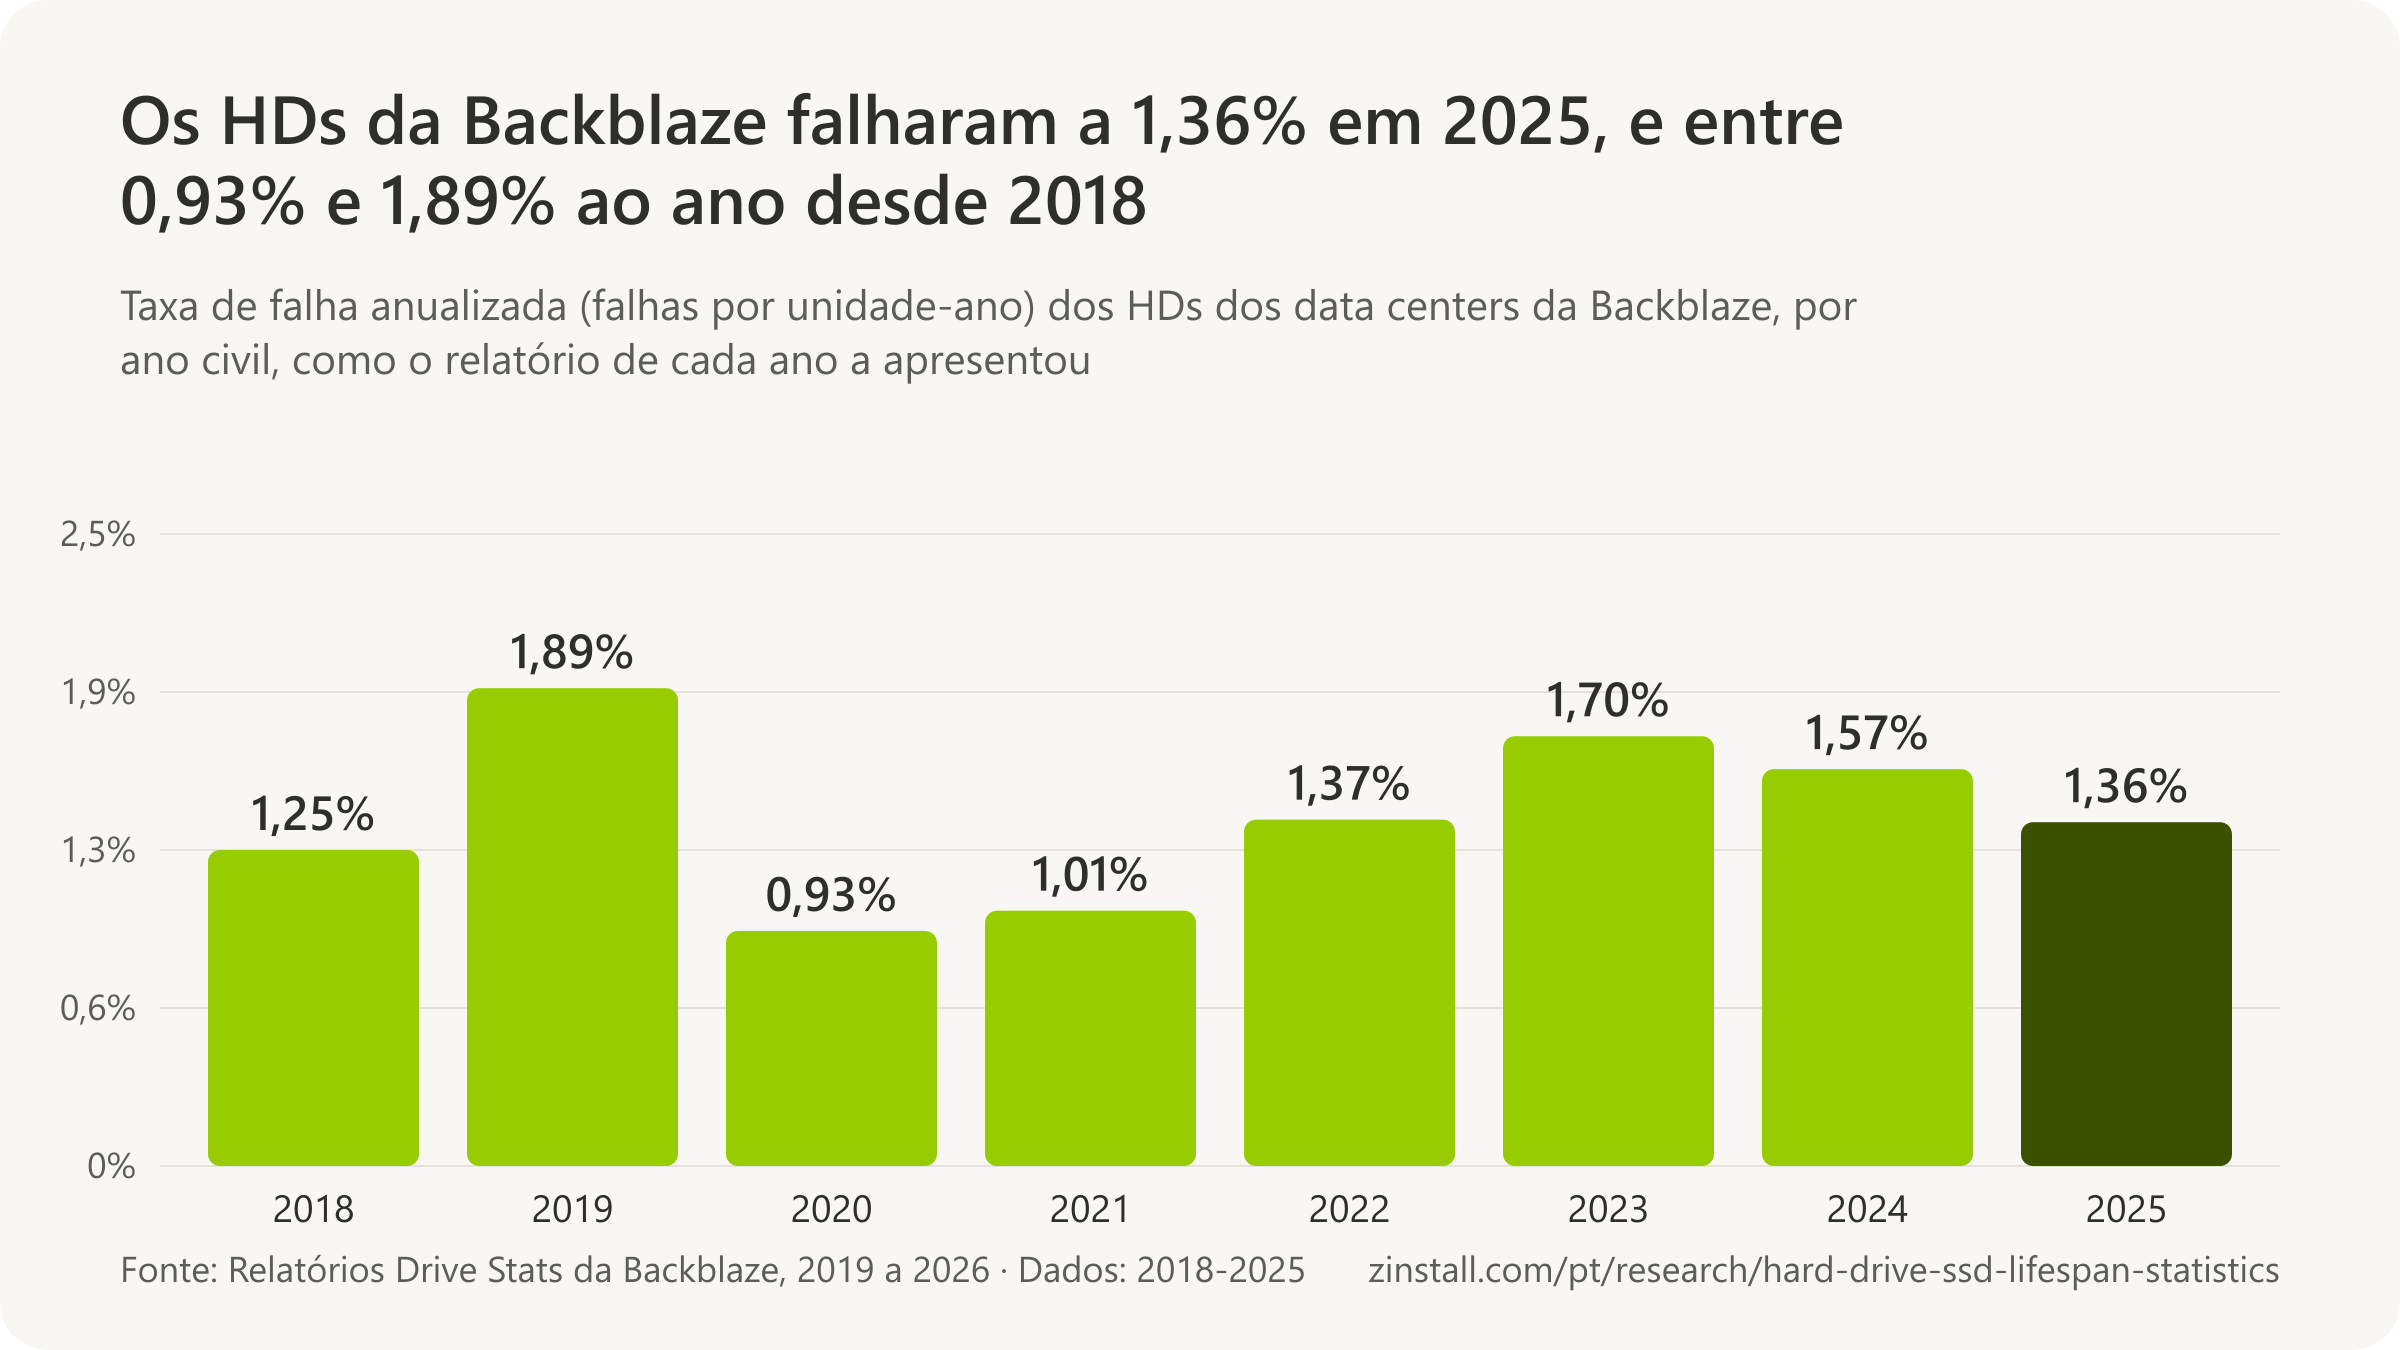
Os HDs dos data centers de uma empresa de nuvem falharam a uma taxa anualizada de 1,36% em 2025, em 344.196 unidades (Backblaze, 2026).

- Os HDs foram substituídos a 3,01% ao ano em sete grandes sistemas, contra 0,58% a 0,88% nas suas fichas técnicas (Carnegie Mellon University, 2007).
- 3,16% dos HDs falharam por ano em nove data centers da Microsoft, de 1,5% a 5,4% conforme o local.
- Cerca de 0,78% dos HDs falharam por ano nos 15 maiores modelos dos data centers da Alibaba Cloud.
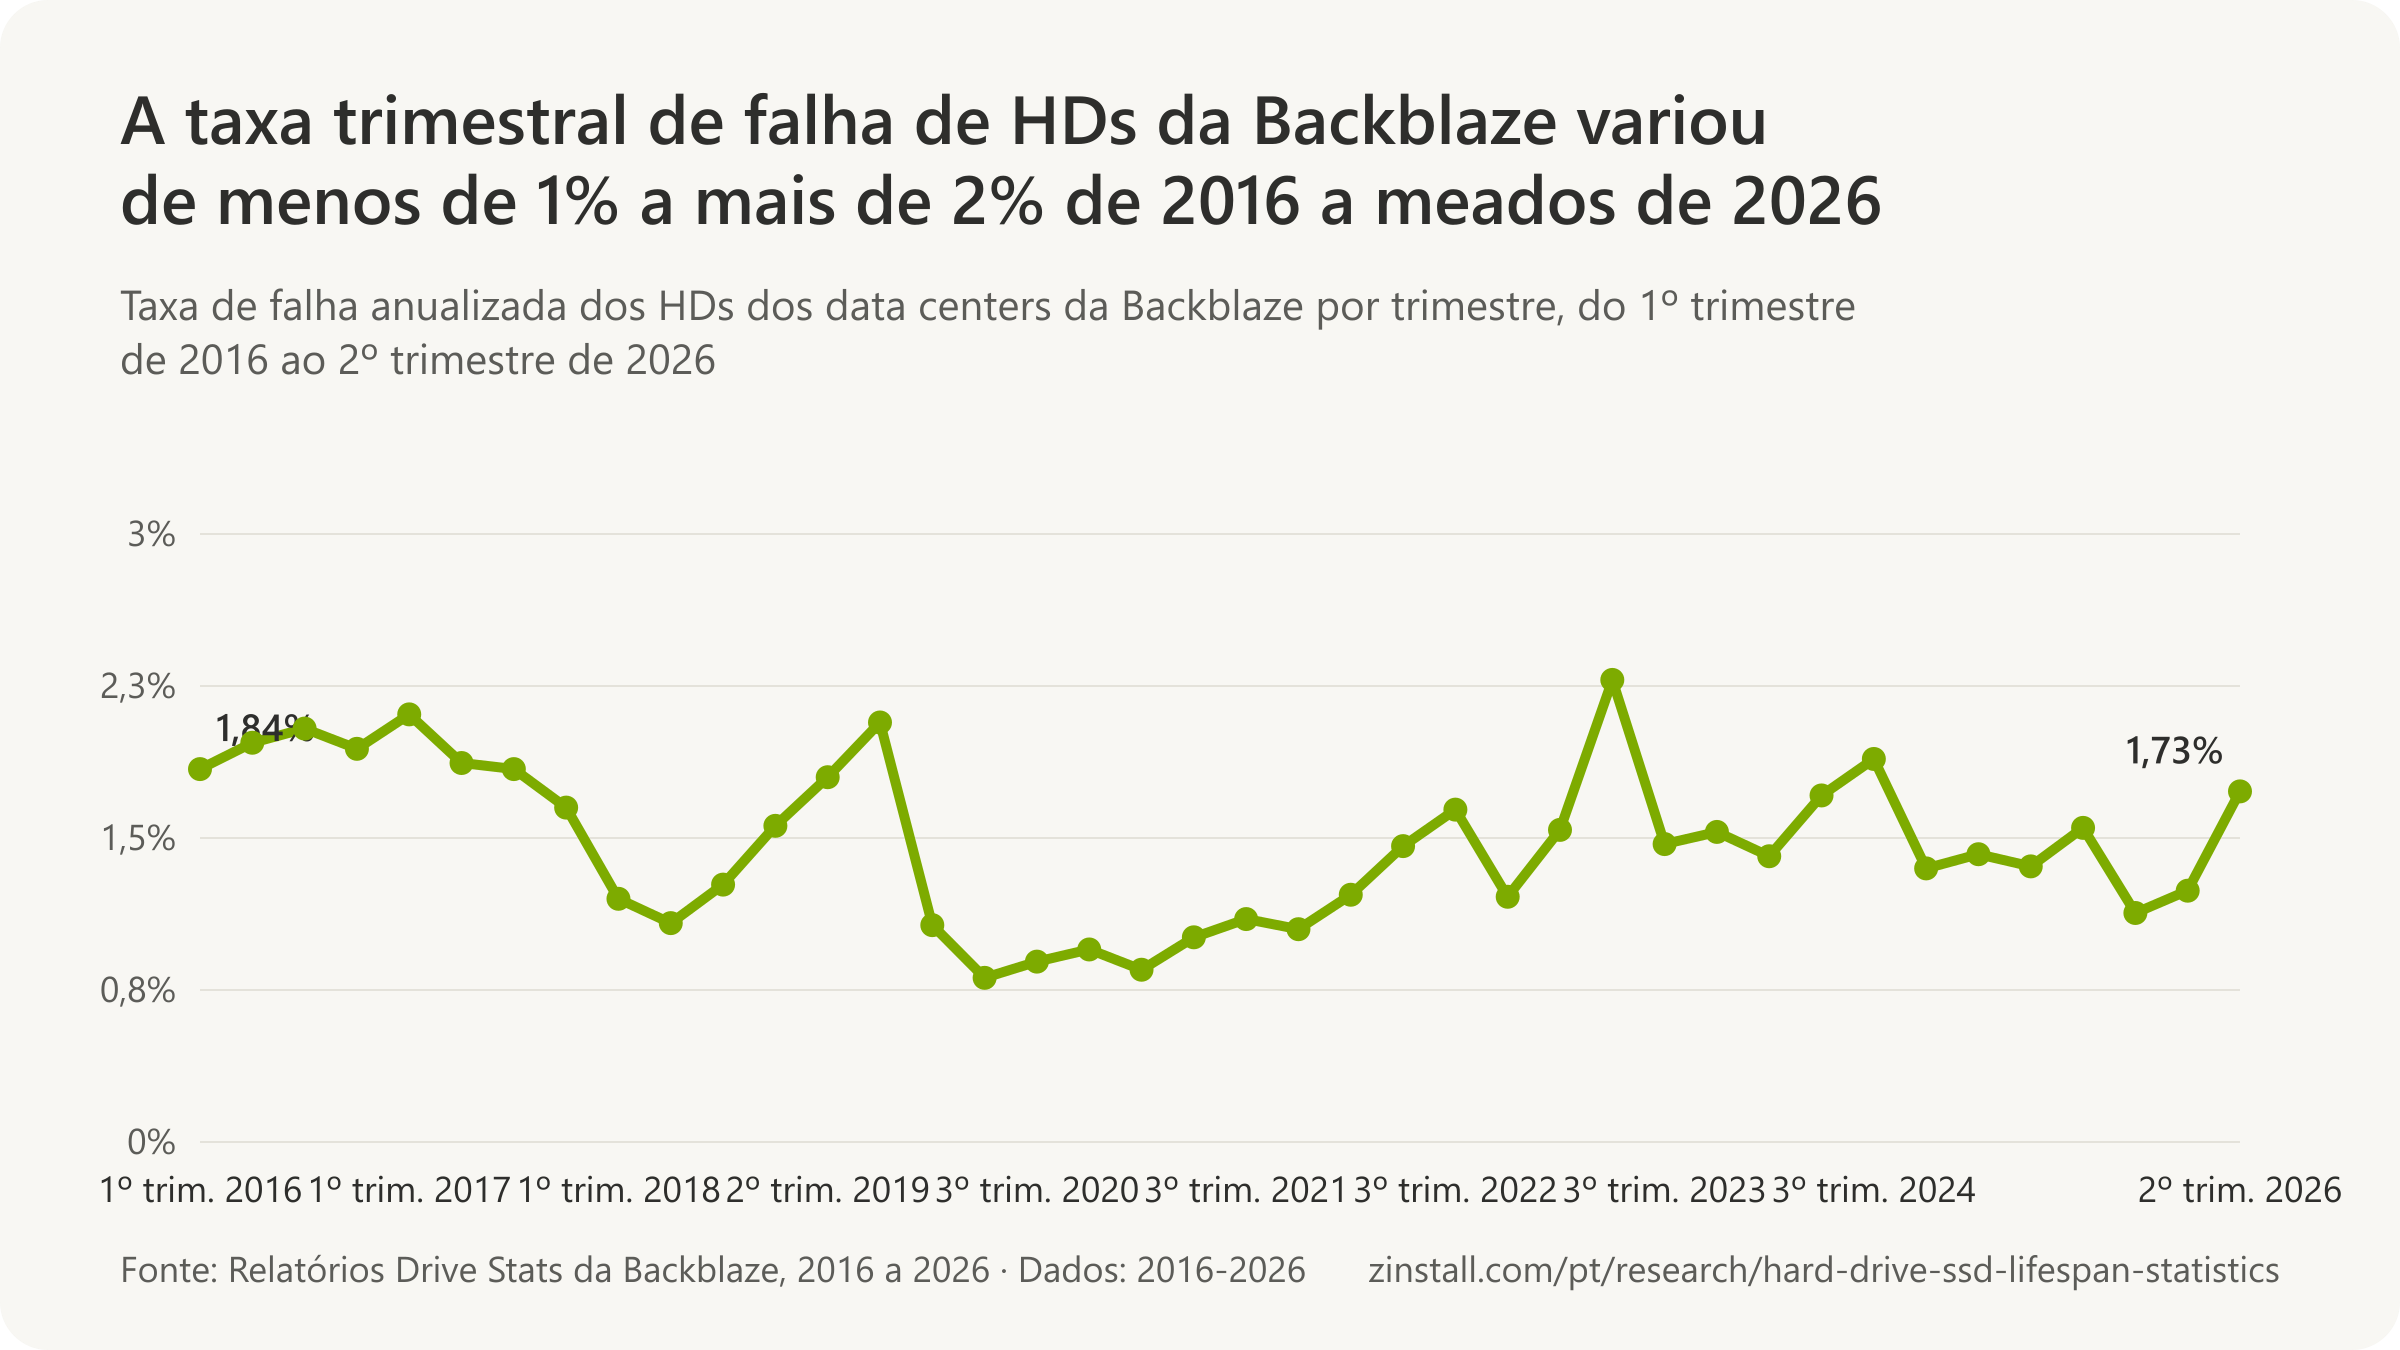
- Os HDs de uma empresa de nuvem falharam a uma taxa anualizada de 1,73% no segundo trimestre de 2026, o trimestre mais recente que ela publicou.
- 53,0% das falhas que a Backblaze registrou no 3º trimestre de 2024 foram unidades retiradas antes da hora porque mostravam sinais de falha.
| Parque, medida e ano | Taxa |
|---|---|
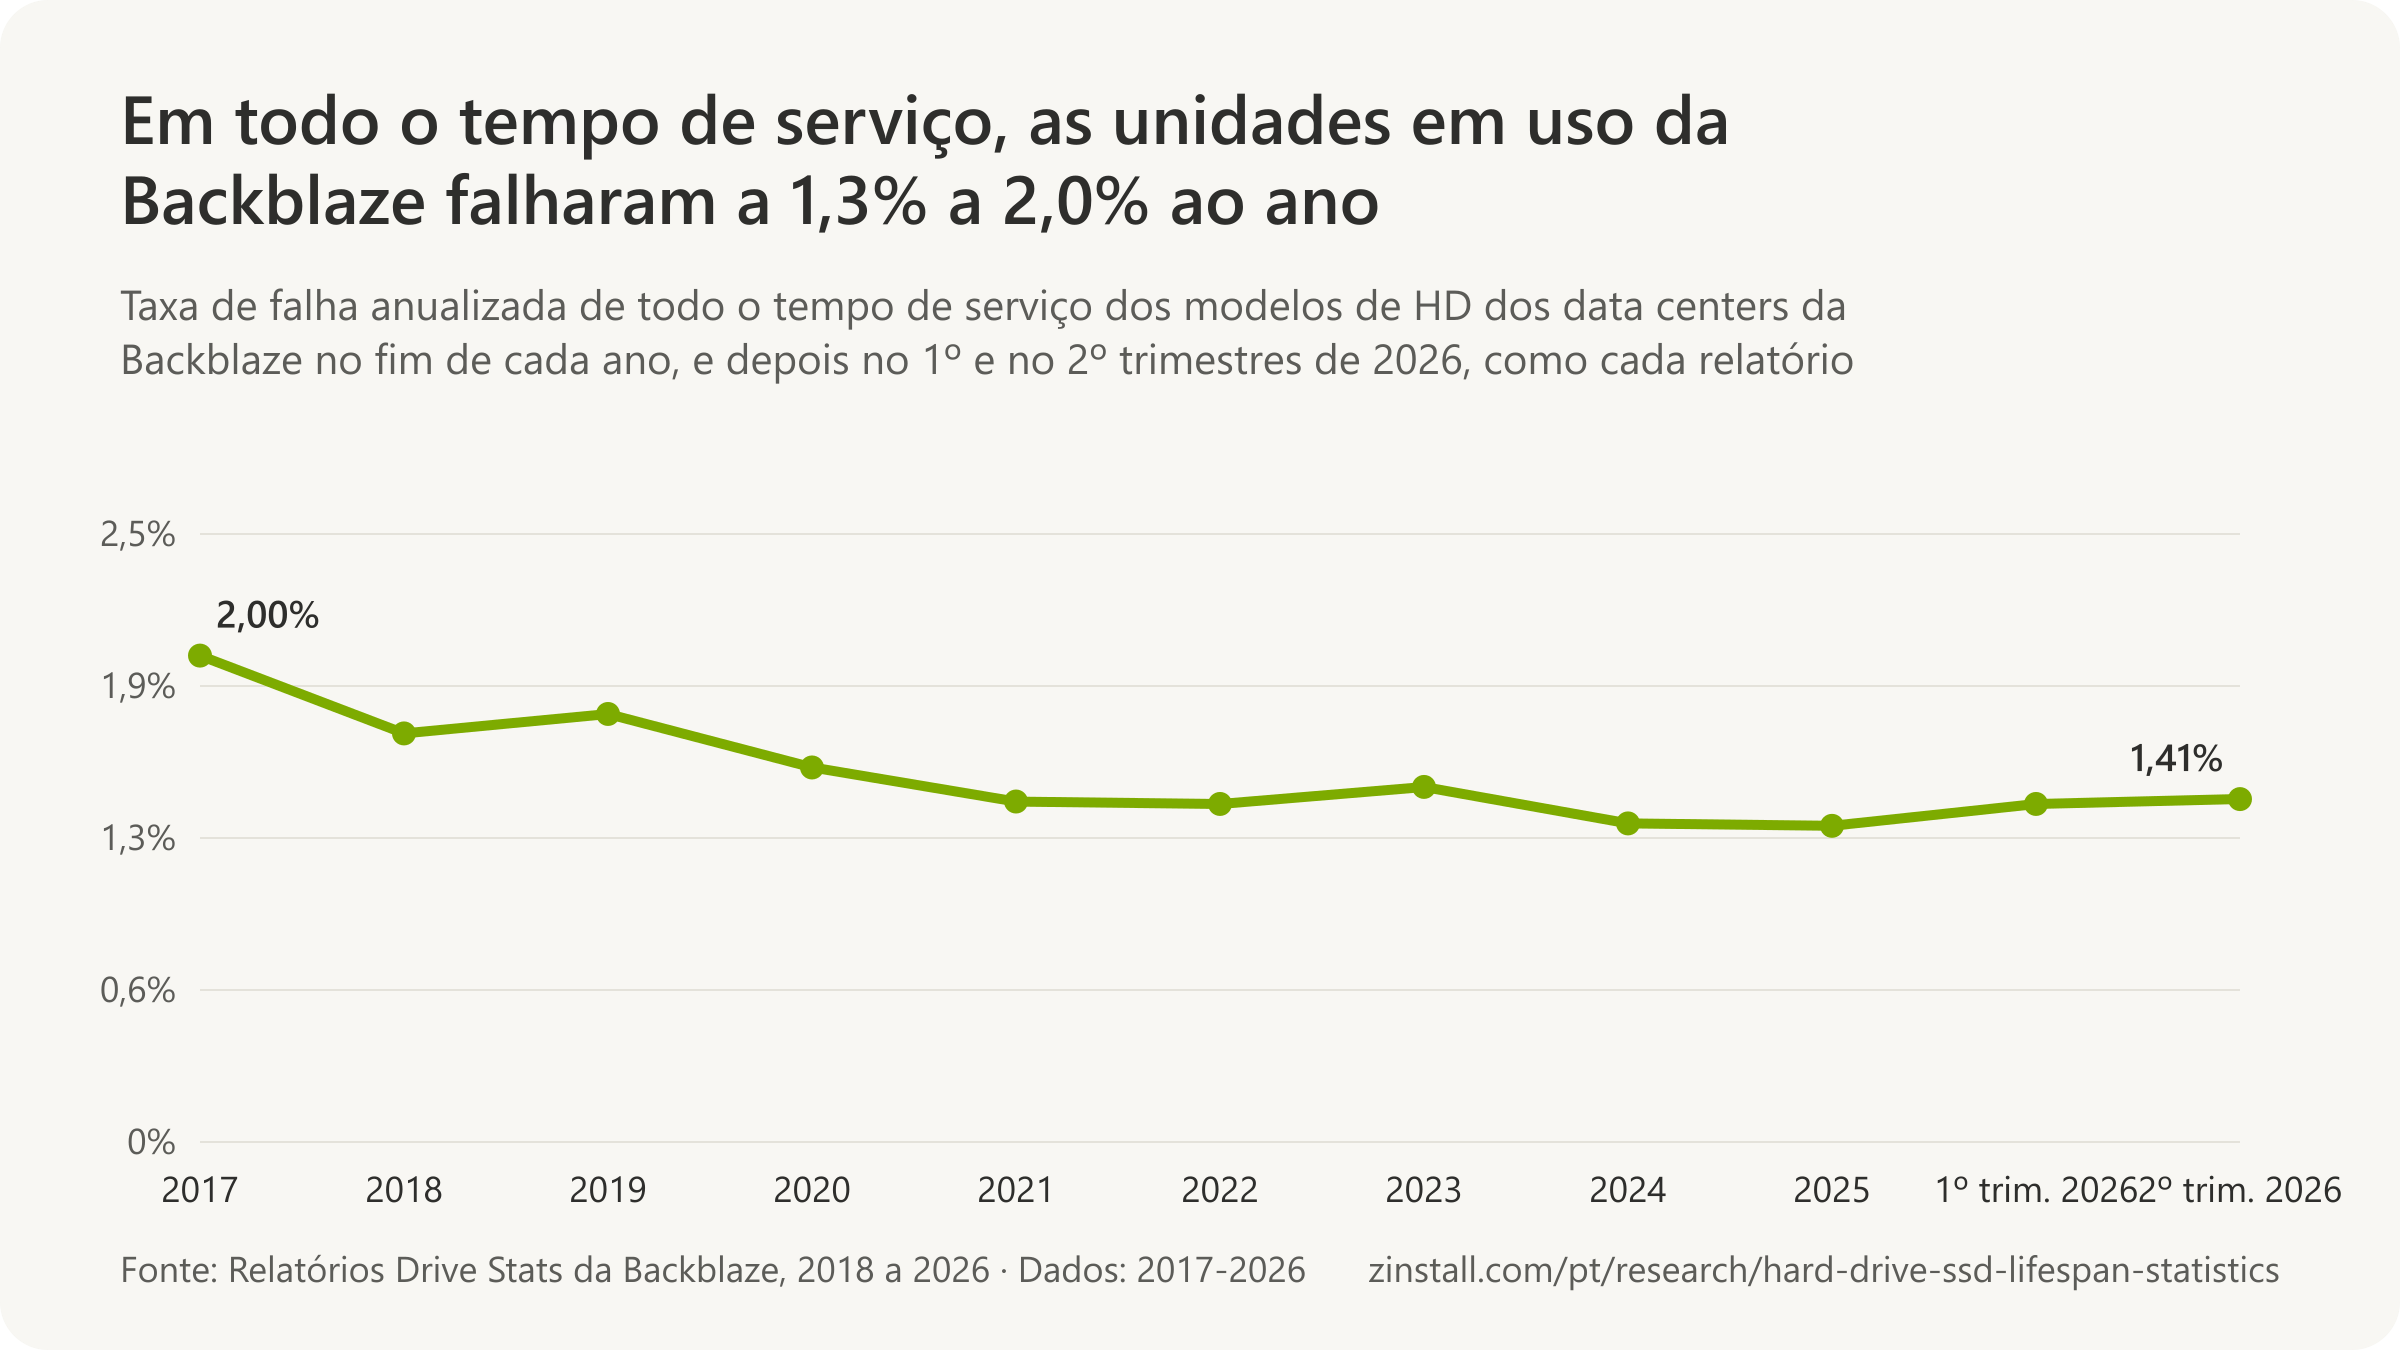
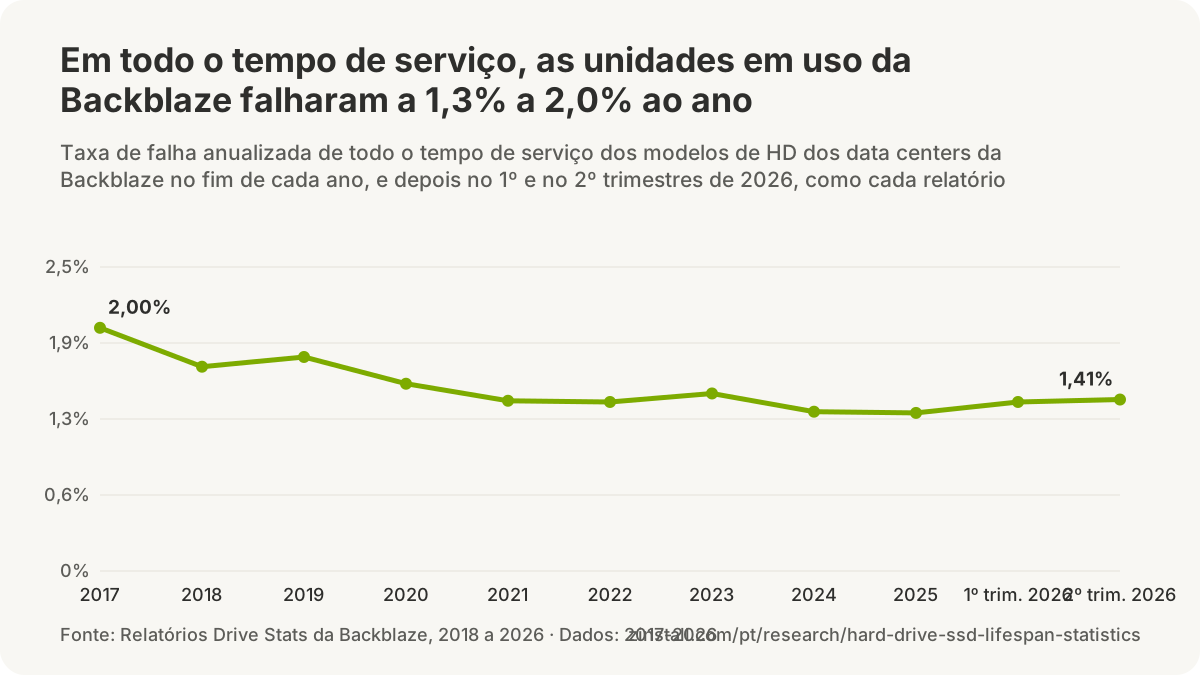
| Backblaze: taxa de todo o tempo de serviço das unidades em uso, meados de 2026 | 1,41% |
| Backblaze: sua primeira contagem em todo o parque, 2013 | 4,2% |
| Carnegie Mellon: um cluster de supercomputador ao longo de cinco anos | 3,4% |
| Carnegie Mellon: o pior sistema que ela estudou | até 13% |
| Servidores de nuvem da Microsoft: unidades substituídas por ano, 2010 | 2,7% |
| Microsoft Azure: unidades que passam a apresentar defeito por dia, 2018 | 3 em cada 10.000 por dia |
| Sistemas de backup da NetApp: unidades SATA, 2008 | 1,9% |
| 380.000 unidades em 64 locais de data center, 2020 | 1,36% |
| Dois grandes serviços web: unidades SCSI substituídas por ano, 2005 | 6,0% |
| Alibaba Cloud: os 15 maiores modelos de unidade, 2019 | menos de 1% (10 de 15 modelos) |
Fontes: Backblaze (2013-2026); Carnegie Mellon University; Rutgers University, GoDaddy and Microsoft; The Chinese University of Hong Kong and Alibaba; Microsoft Research (2010, 2005); Microsoft Research and Microsoft Azure, with the University of Newcastle and Nankai University; University of Illinois at Urbana-Champaign and NetApp; Wayne State University and Northeastern University
Guias relacionados: Mensagem “Windows detected a hard disk problem” · Um HD com setores defeituosos · Faça backup do PC inteiro
Mais estatísticas (67)
A resposta medida vem de grandes parques: os data centers da Backblaze, que têm todas as falhas de unidade publicadas desde 2013, e os estudos do Google, da Carnegie Mellon, da Microsoft, da NetApp e da Alibaba. Na maioria deles, a chance anual de um HD falhar é de poucos por cento, e bem acima das taxas das fichas técnicas dos fabricantes. Uma taxa descreve uma população: ela não diz quando uma unidade vai falhar.
Os data centers da Backblaze, todos os anos desde 2013

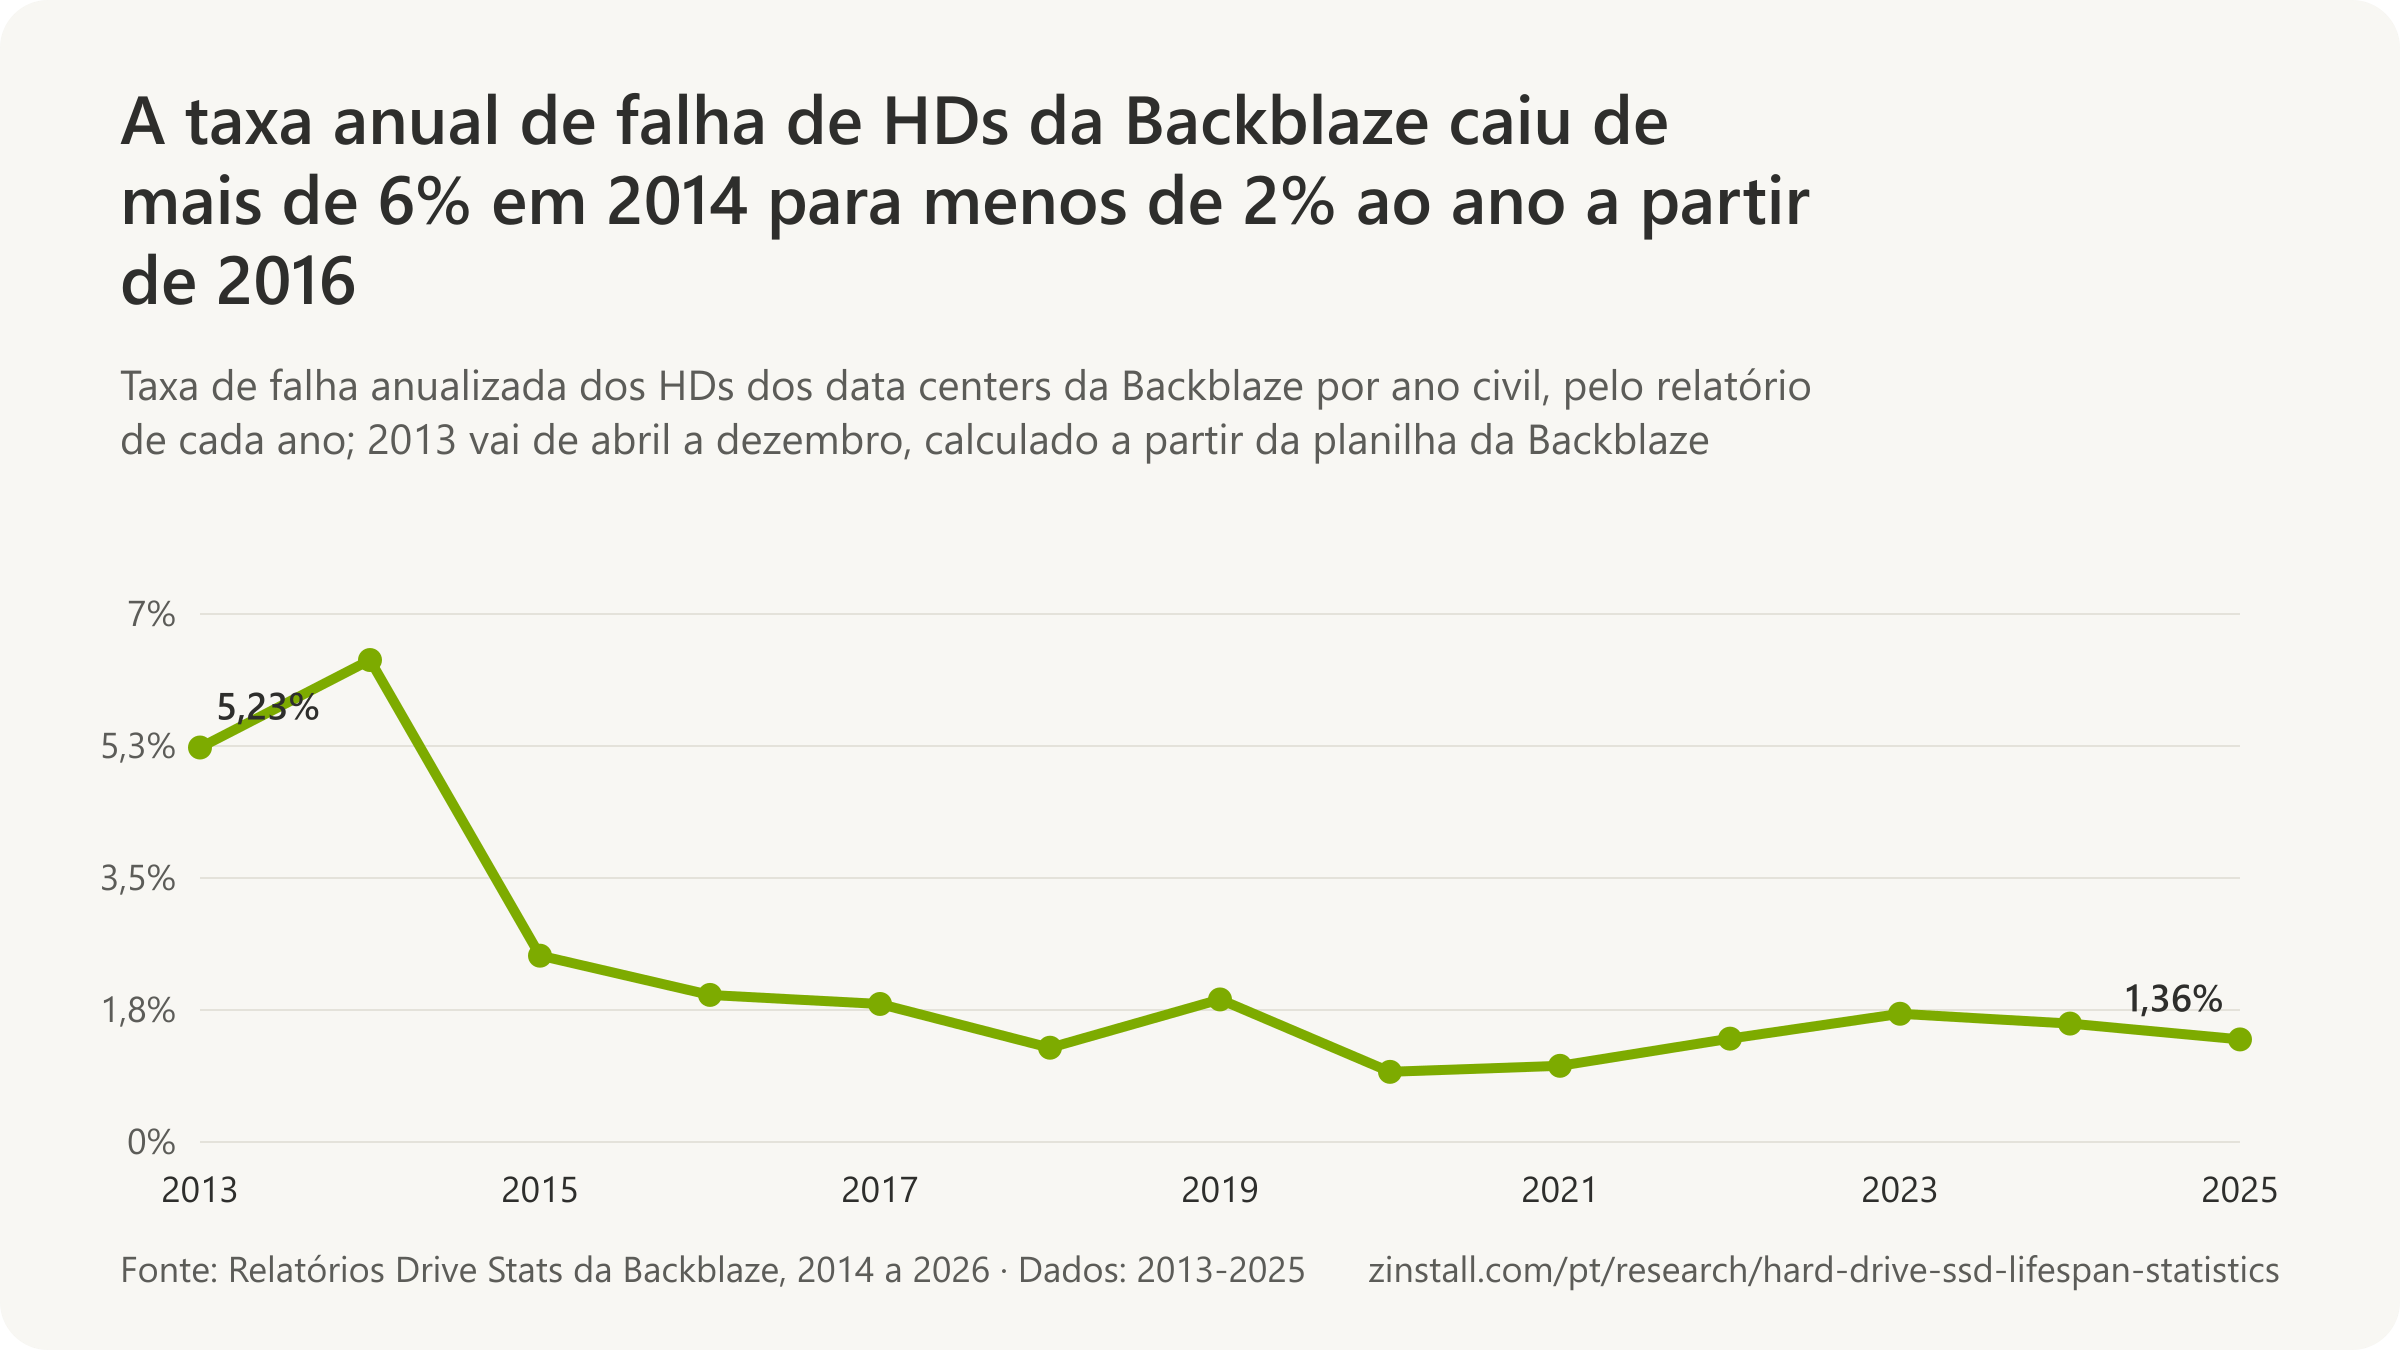
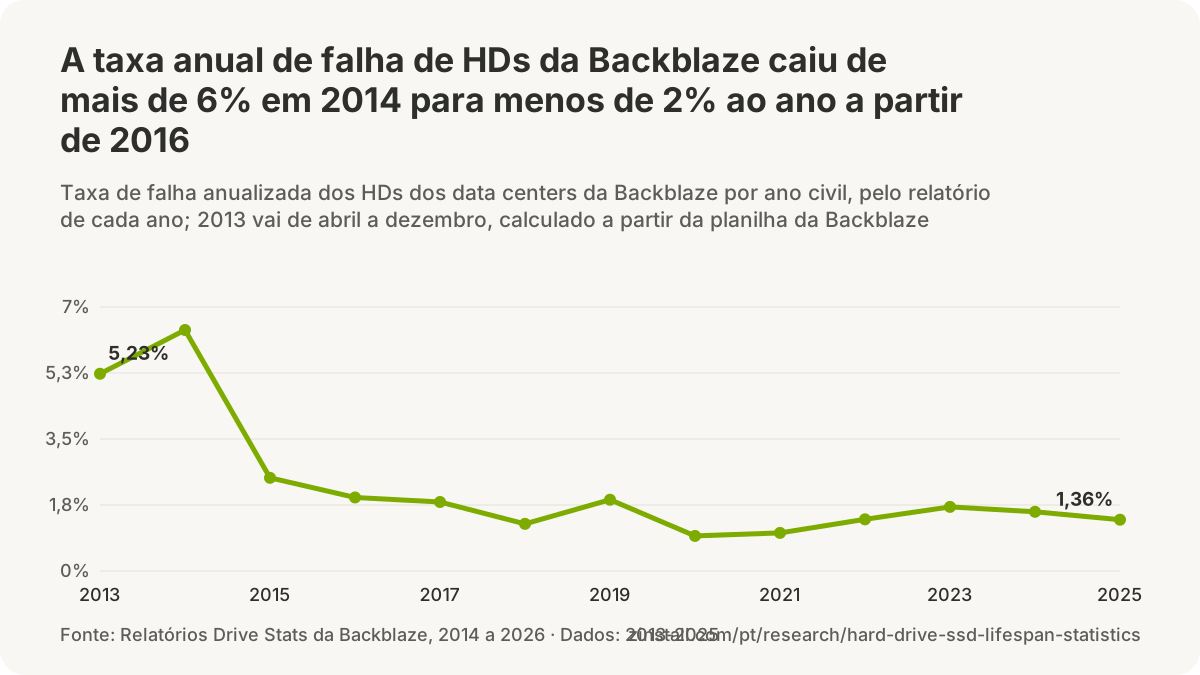
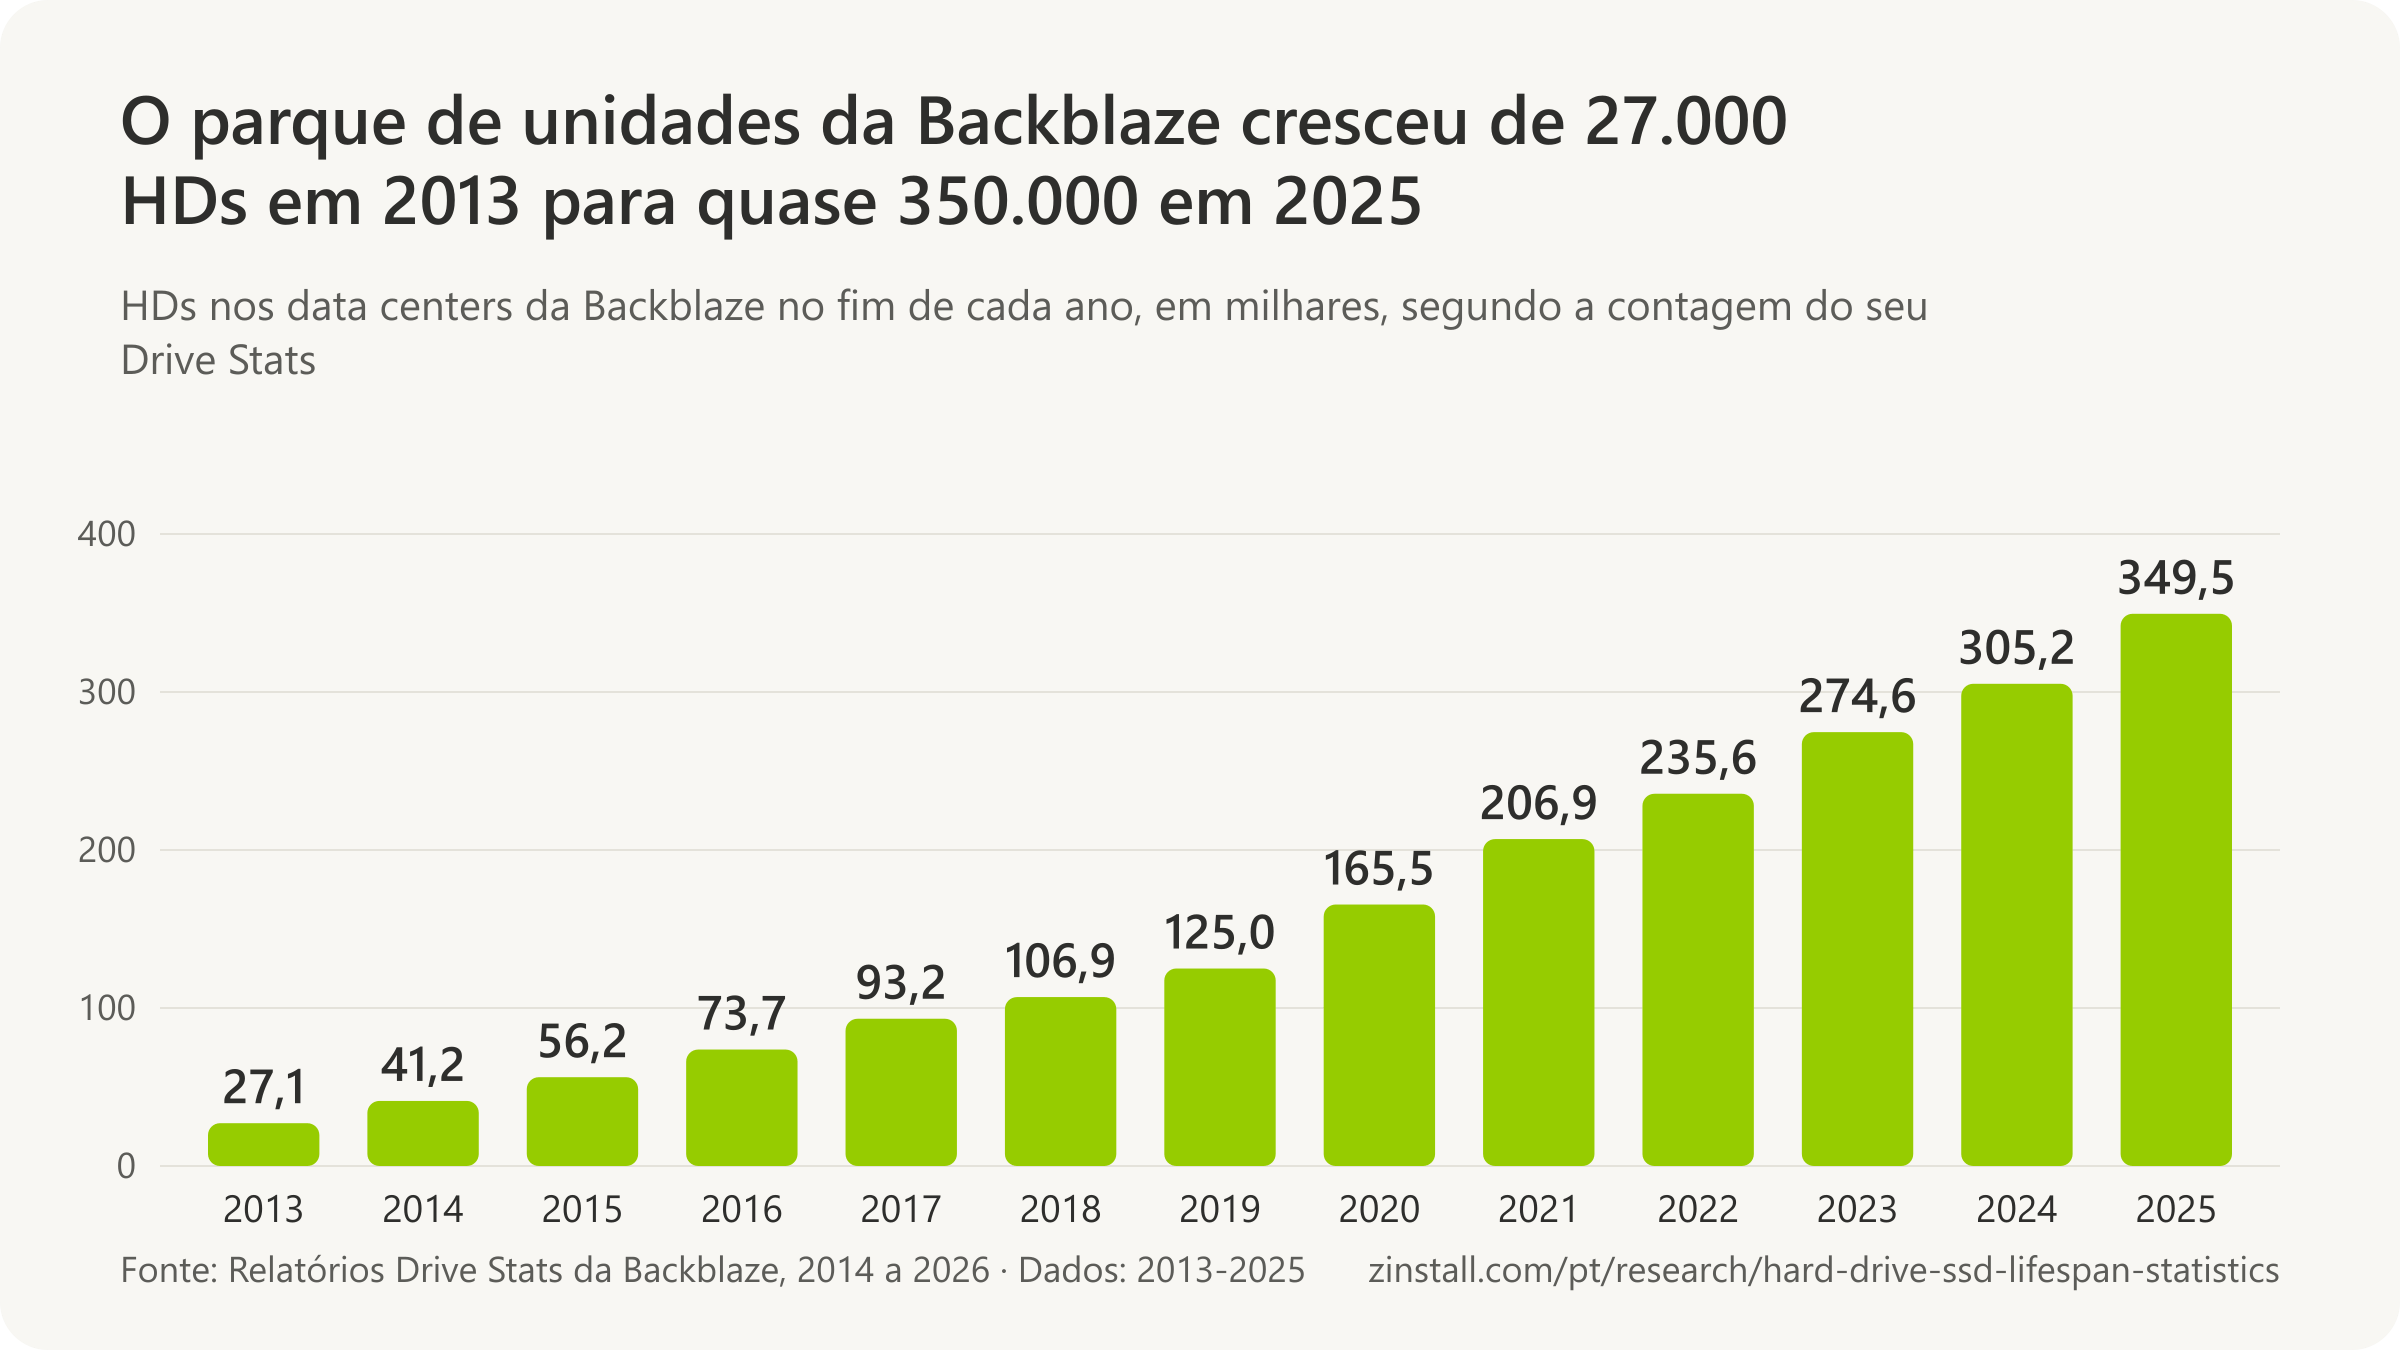
- 2,35% dos HDs do data center da Backblaze falharam em 2015, em base anualizada, contando só as 45.566 unidades de modelos ainda em serviço no fim de 2017 (Backblaze, 2018).
- 2,00% dos HDs do data center da Backblaze falharam em 2016, em base anualizada, contando só as 66.252 unidades de modelos ainda em serviço no fim de 2017 (Backblaze, 2018).
- 1,77% dos HDs dos data centers da Backblaze falharam em 2017, em base anualizada, conforme reproduzido no seu relatório de 2018 para 90.523 unidades (Backblaze, 2019).
- 1,83% é a taxa de falha anualizada de 2019 como o relatório de 2021 da Backblaze a escreveu, contra 1,89% no próprio relatório de 2019 (Backblaze, 2022).
- 1,55% é a taxa de falha anualizada de 2024 como o texto do relatório de 2025 da Backblaze a apresenta, contra 1,57% no relatório de 2024 e no próprio gráfico do relatório de 2025 (Backblaze, 2026).
- 1,62% é a taxa de falha anualizada de todo o tempo de serviço no fim de 2019 como o relatório de 2021 da Backblaze a apresenta, contra 1,76% na própria tabela de todo o tempo de serviço do relatório de 2019 (Backblaze, 2022).
- 3,36% ao ano foi a taxa de falha anualizada de todos os 85.467 HDs que a Backblaze usou de abril de 2013 ao fim de 2016, 5.380 falhas em 58.375.646 dias-unidade, incluindo os modelos aposentados (Backblaze, 2017).
- 6.795 HDs falharam nos data centers da Backblaze entre abril de 2013 e o fim de 2017, uma média de 3,94 por dia, pela contagem da Backblaze (Backblaze, 2018).
- Um HD falhou mais ou menos a cada duas horas e cinco minutos nos data centers da Backblaze em 2023, 4.189 falhas no ano (Backblaze, 2024).


O parque da Backblaze

- 3.112 horas foram gastas substituindo HDs nos data centers da Backblaze em 2025, cerca de 0,74 hora por unidade (Backblaze, 2025).
- 53.337 unidades foram instaladas nos data centers da Backblaze em 2024, cerca de 26 por hora de trabalho dos técnicos (Backblaze, 2025).
- Mais de quatro exabytes de armazenamento rodavam nos HDs da Backblaze em meados de 2025, pela descrição da própria Backblaze (Backblaze, 2025).
- 388 milhões de registros diários de unidades compõem o conjunto de dados público Drive Stats da Backblaze em 2026, que cresce mais de 240.000 registros por dia (Backblaze, 2026).
Estudos de campo: Google, Carnegie Mellon, Microsoft, NetApp, Alibaba e outros
- 3,01% dos HDs foram substituídos a cada ano, em média, em sete grandes sistemas de produção, contra taxas de falha de 0,58% a 0,88% nas fichas técnicas, entre cerca de 100.000 unidades com menos de cinco anos (Carnegie Mellon University, 2007).
- Até 13% dos HDs foram substituídos por ano em alguns sistemas, enquanto taxas anuais de substituição de 2% a 4% eram comuns, em cerca de 100.000 unidades em locais de computação e de serviços de internet (Carnegie Mellon University, 2007).
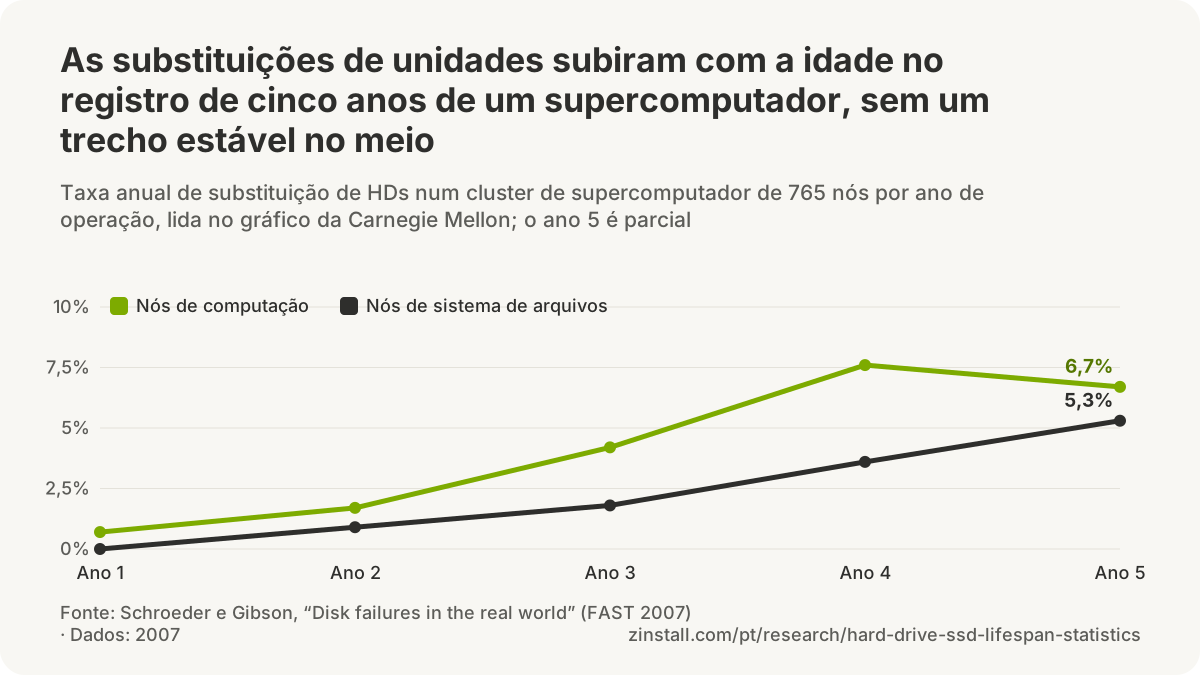
- 3,4% dos HDs foram substituídos por ano ao longo dos cinco anos de vida de um cluster de supercomputador de 765 nós, contra uma taxa de 0,88% na ficha técnica (Carnegie Mellon University, 2007).
- 3,3% dos HDs SATA foram substituídos por ano, contra 3,7% das unidades SCSI de 15K rpm no mesmo supercomputador, então as unidades SATA, mais baratas, não se saíram pior (Carnegie Mellon University, 2007).
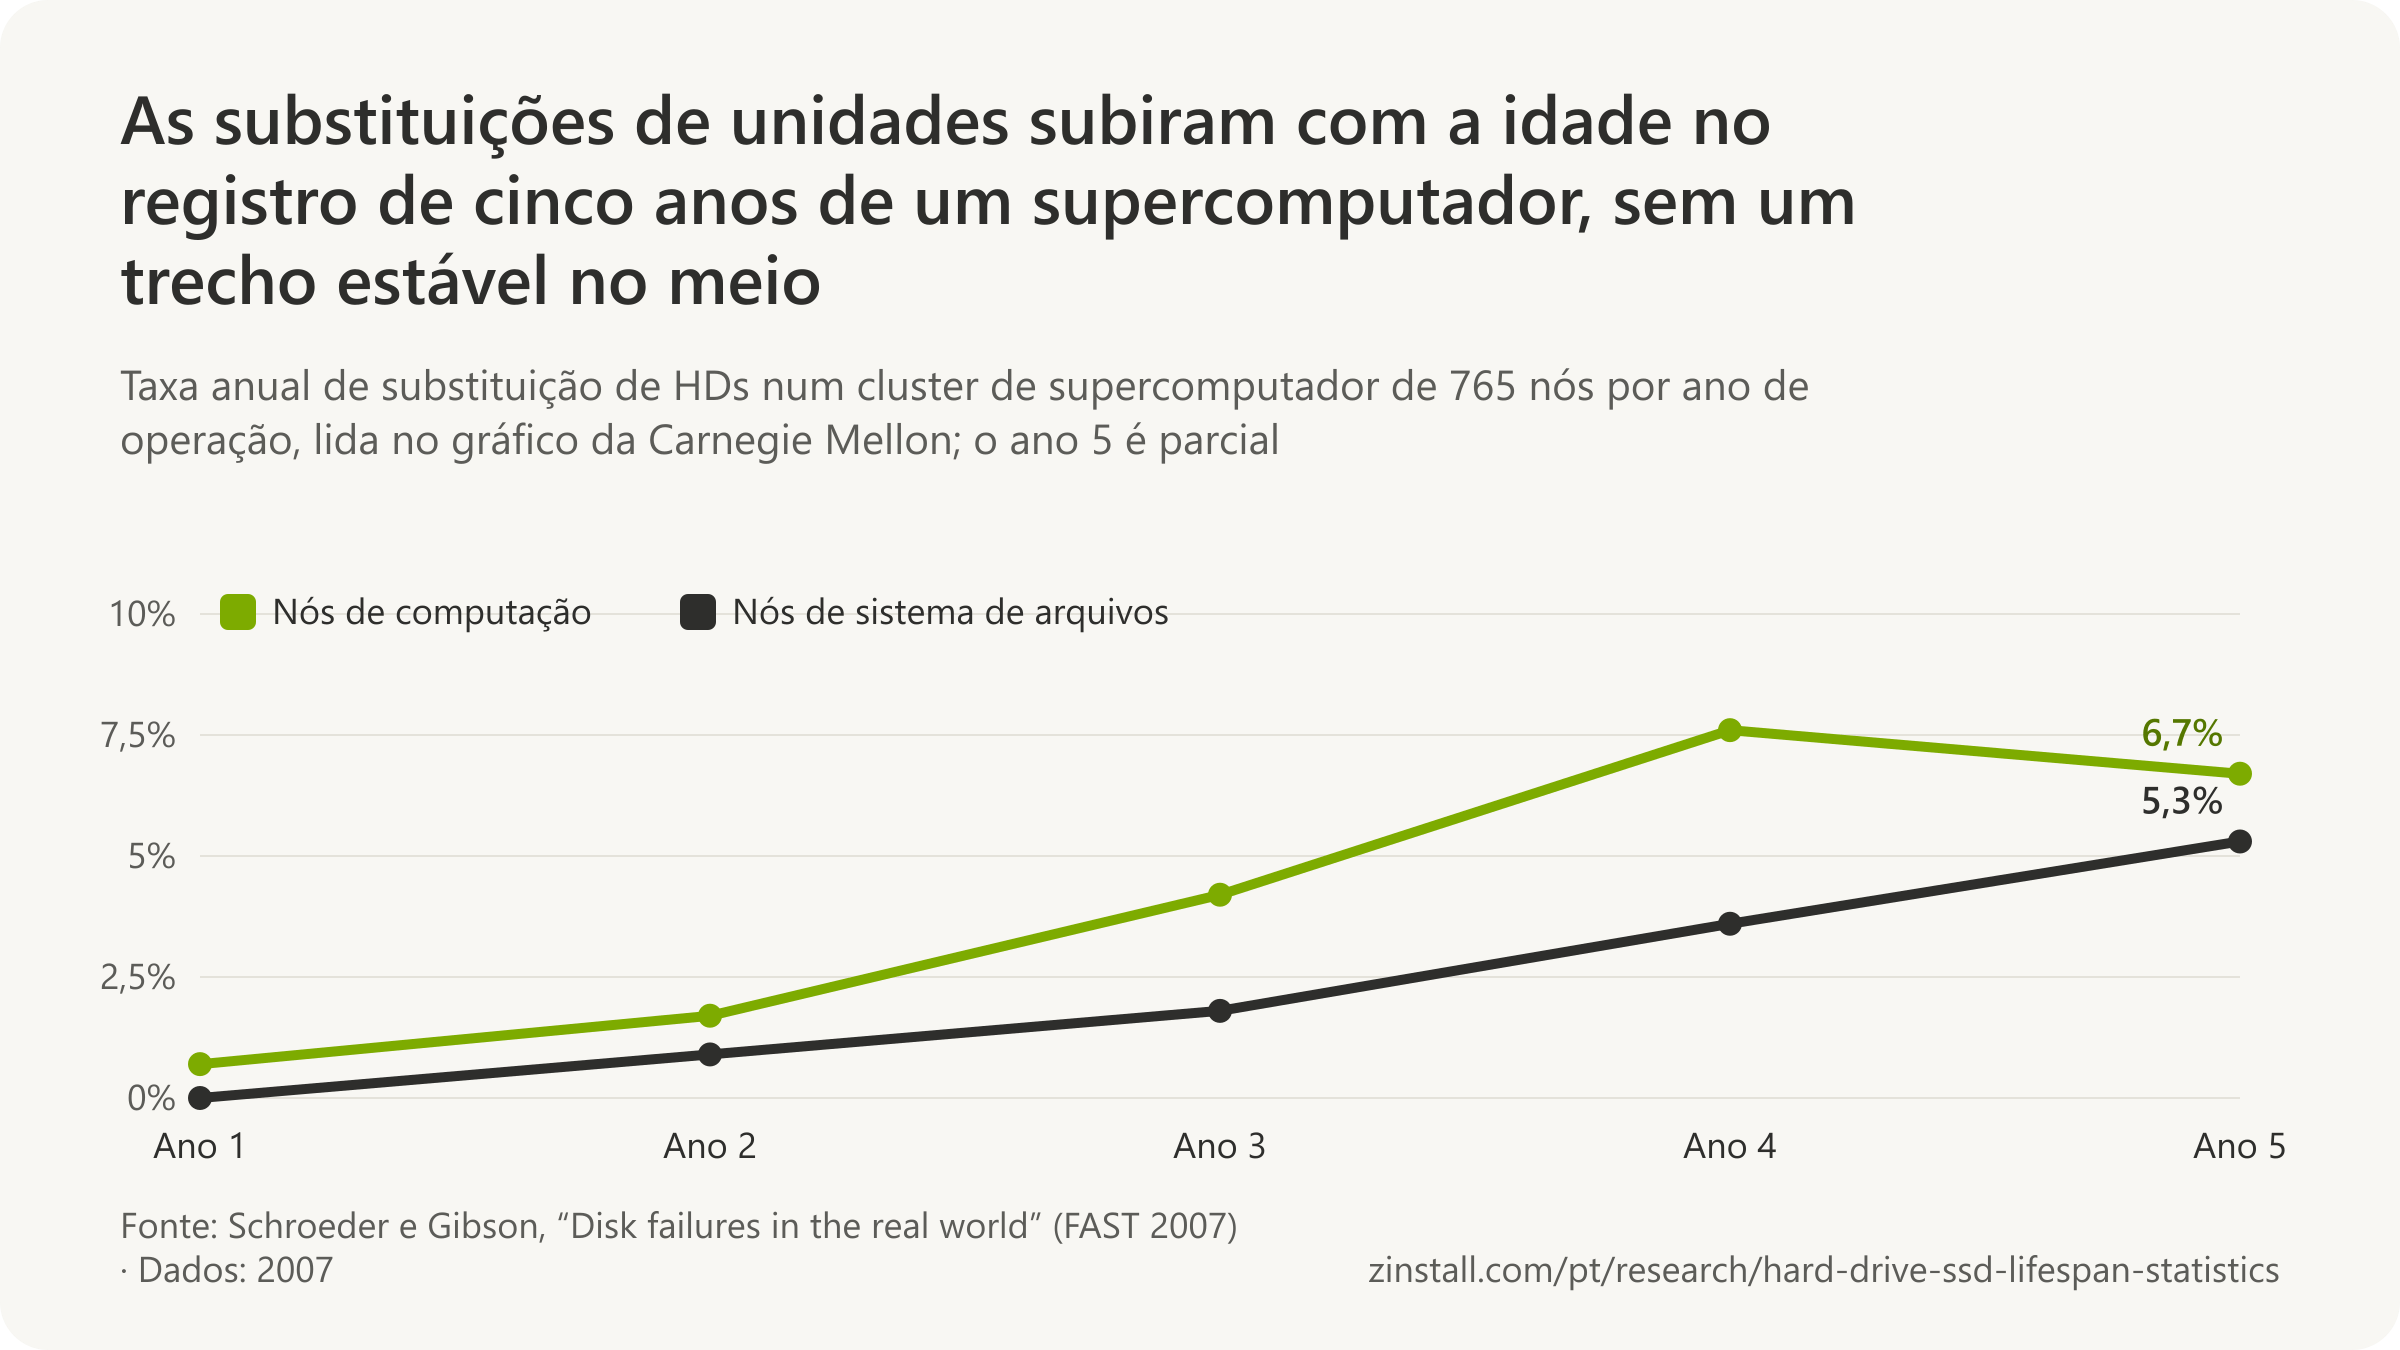
- Cerca de 0,7% dos HDs foram substituídos no primeiro ano de operação nos nós de computação de um cluster de supercomputador (Carnegie Mellon University, 2007).
- Cerca de 1,7% dos HDs foram substituídos no segundo ano de operação nos nós de computação de um cluster de supercomputador (Carnegie Mellon University, 2007).
- Cerca de 4,2% dos HDs foram substituídos no terceiro ano de operação nos nós de computação de um cluster de supercomputador (Carnegie Mellon University, 2007).
- Cerca de 7,6% dos HDs foram substituídos no quarto ano de operação nos nós de computação de um cluster de supercomputador, ainda dentro da vida nominal de cinco anos das unidades (Carnegie Mellon University, 2007).
- Cerca de 6,7% dos HDs foram substituídos no quinto ano de operação nos nós de computação de um cluster de supercomputador (Carnegie Mellon University, 2007).
- 0% dos HDs foram substituídos no primeiro ano nos nós de sistema de arquivos de um cluster de supercomputador: nenhuma mortalidade infantil foi detectável (Carnegie Mellon University, 2007).
- Cerca de 0,9% dos HDs foram substituídos no segundo ano nos nós de sistema de arquivos de um cluster de supercomputador (Carnegie Mellon University, 2007).
- Cerca de 1,8% dos HDs foram substituídos no terceiro ano nos nós de sistema de arquivos de um cluster de supercomputador (Carnegie Mellon University, 2007).
- Cerca de 3,6% dos HDs foram substituídos no quarto ano nos nós de sistema de arquivos de um cluster de supercomputador (Carnegie Mellon University, 2007).
- Cerca de 5,3% dos HDs foram substituídos no quinto ano nos nós de sistema de arquivos de um cluster de supercomputador (Carnegie Mellon University, 2007).
- 16% das paradas de nós causadas por hardware num cluster de supercomputador foram atribuídas a HDs, a terceira causa depois das CPUs (44%) e da memória (29%), mas cerca de 90% dos problemas de disco terminaram com a substituição da unidade (Carnegie Mellon University, 2007).
- 43% dos HDs que os clientes devolveram não mostraram nenhum problema quando o fabricante os testou, segundo o que um fornecedor de unidades informou à Carnegie Mellon (Carnegie Mellon University, 2007).
- De 20% a 55% das falhas de subsistemas de armazenamento foram falhas de disco, e de 27% a 68% foram falhas das conexões (cabos, gabinetes de prateleira, adaptadores), em cerca de 39.000 sistemas de armazenamento da NetApp com 1,8 milhão de unidades (University of Illinois e NetApp, 2008).
- 1,9% dos HDs SATA em sistemas de backup near-line falharam por ano, contra 0,9% das unidades Fibre Channel em sistemas primários de entrada, segundo os logs de cerca de 39.000 sistemas de armazenamento da NetApp (University of Illinois e NetApp, 2008).
- 4,6% ao ano foi a taxa de falha de subsistemas de armazenamento inteiros nos sistemas de entrada da NetApp, enquanto os seus discos falharam a apenas 0,9% ao ano, cerca de 20% do total (University of Illinois e NetApp, 2008).
- 78% das substituições de hardware nos servidores de nuvem da Microsoft foram de HDs, seguidos pelas controladoras RAID (5%) e pela memória (3%), em mais de 100.000 servidores ao longo de 14 meses (Microsoft, 2010).
- 70% das primeiras falhas de hardware dos servidores de nuvem da Microsoft foram de HDs, à frente das controladoras RAID (6%) e da memória (5%), em mais de 100.000 servidores (Microsoft, 2010).
- 2,7% dos HDs foram substituídos a cada ano (um limite superior) nos servidores de nuvem da Microsoft, contra 0,7% das controladoras RAID e 0,1% dos módulos de memória, em mais de 100.000 servidores (Microsoft, 2010).
- 3,16% dos HDs falharam por ano, em média (taxa de falha anualizada), com variação de 1,5% a 5,4% conforme o data center, em mais de 1 milhão de unidades em nove data centers da Microsoft (Microsoft e Rutgers University, 2016).
- 89% das falhas de componentes de hardware dos servidores foram falhas de HD, em média (de 76% a 95% conforme o data center), qualquer que fosse o resfriamento ou o clima, em nove data centers da Microsoft (Microsoft e Rutgers University, 2016).
- A maior e a menor taxa de falha durante a vida útil dos modelos de HD diferiram em bem mais de 10 vezes, em mais de 50 marcas e modelos e 4,3 milhões de unidades da NetApp (Carnegie Mellon University, 2020).
- 1,36% dos HDs falharam por ano (taxa anual de falha, medida ao longo de cerca de 70 dias), em 380.000 unidades em 64 locais de um grande operador de data centers (universidades Wayne State e Northeastern, 2020).
- 10 dos 15 maiores modelos de HD tinham taxa de falha anualizada abaixo de 1%, e nenhum acima de 3,8%, em mais de três milhões de unidades nos data centers da Alibaba Cloud (Chinese University of Hong Kong e Alibaba, 2019).
- Cerca de 0,78% dos HDs falharam por ano, em média, nos 15 maiores modelos de unidade, que somam 72% de mais de três milhões de unidades nos data centers da Alibaba Cloud (Chinese University of Hong Kong e Alibaba, 2019).
- No máximo 3 em cada 10.000 HDs passaram a apresentar defeito em qualquer dia no Microsoft Azure, uma nuvem que, segundo o artigo, roda centenas de milhões de unidades (Microsoft, 2018).
- 6,0% dos HDs SCSI de 10K rpm precisaram ser substituídos por ano num grande serviço web, e 3,3% das unidades PATA de classe desktop em outro, cerca de dez vezes o que diziam as fichas técnicas dos fornecedores (Microsoft Research, 2005).
As unidades entre as outras falhas de hardware
- Placas-mãe e HDs foram as duas fontes mais comuns de falha de hardware em notebooks e PCs desktop com menos de dois anos, informou a Gartner em 2006 (Gartner, 2006).
- De 25% a 45% das falhas de hardware em notebooks foram falhas de placa-mãe e de HD, constatou a Gartner em 2006, com dados de prestadores de reparos em garantia e pesquisas com usuários finais (Gartner, 2006).
O que conta como falha
- 53,0% das 1.361 falhas de HD nos data centers da Backblaze no 3º trimestre de 2024 foram substituições preventivas de unidades que mostravam sinais de falha, e 47,0% foram unidades que tinham parado de funcionar (Backblaze, 2024).
- AFR = (falhas de unidades / (dias-unidade / 365)) x 100 é a fórmula por trás de toda taxa de falha da Backblaze, que conta cada dia em que cada unidade funciona, para que as unidades acrescentadas ou retiradas no meio do ano tenham o peso correto (Backblaze, 2022).
- 1 unidade em cada 100 deve falhar num ano a uma taxa de falha anualizada de 1%, explica a Backblaze, acrescentando que o dono de uma única unidade enfrenta uma chance de tudo ou nada (Backblaze, 2025).
- 3 condições definem uma unidade com falha nos dados da Backblaze: ela não gira ou não se conecta, não sincroniza ou não se mantém sincronizada no seu array, ou as suas estatísticas SMART passam dos limites da Backblaze (Backblaze, 2015).
- 16,95% foi a taxa de falha anualizada do 3º trimestre de 2025 de um modelo Toshiba de 16TB nos data centers da Backblaze, inflada porque as unidades retiradas para uma atualização de firmware foram contadas como falhas (Backblaze, 2025).
- As falhas no primeiro dia provavelmente foram subnotificadas nos dados da Backblaze desde o início, disse a Backblaze em 2026, porque uma unidade precisa sobreviver ao primeiro dia para entrar no registro diário (Backblaze, 2026).
- 24,31% foi a taxa de falha anualizada do 1º trimestre de 2022 de um lote de 76 unidades HGST de 8TB com dois meses de uso e 4.504 dias-unidade, um exemplo de por que a Backblaze adverte contra amostras pequenas (Backblaze, 2022).
- 2 modelos de unidade, o Western Digital Green de 3TB e o Seagate LP de 2TB, ficaram de fora do primeiro relatório de confiabilidade da Backblaze porque “simplesmente não funcionam” nos seus servidores, uma ressalva inicial de seleção (Backblaze, 2014).
- A Backblaze adverte que as suas unidades são usadas de forma diferente das unidades dos consumidores e que as suas cargas de trabalho e o manuseio das unidades mudaram ao longo dos seus 13 anos de dados (Backblaze, 2025).
- A Backblaze tolera falhas de unidade por projeto: ela diz que levar o hardware a zero falhas seria imprudente porque a sua camada de software evita em grande parte a perda de dados (Backblaze, 2026).
- Um terço das substituições de SSDs corporativos nos sistemas de armazenamento da NetApp ocorreu após erros SCSI graves e outro terço foi preventivo, motivado por previsões de falha; apenas 0,6% ocorreram depois que uma unidade parou completamente de funcionar (Maneas et al., 2020).
- Metade (49,55%) das falhas de SSDs NVMe da Alibaba apareceu como erros de leitura ou gravação e apenas 5,65% como o sumiço da unidade, contra 53,7% de sumiços entre os seus SSDs SATA anteriores (Lu et al., 2022).
- 1,41% dos SSDs NVMe corporativos da Alibaba ficaram “fail-slow” (pelo menos duas vezes mais lentos que os vizinhos por 5 minutos ou mais) durante quatro meses de monitoramento, contra 0,20% dos seus HDs (Lu et al., 2022).
- Apenas cerca de 0,22% dos SSDs NVMe fail-slow da Alibaba (10 unidades) chegaram a falhar por completo nos meses seguintes, então um SSD lento raramente é um SSD morrendo (Lu et al., 2022).
- As lentidões nos SSDs NVMe corporativos da Alibaba só ficaram muito mais comuns com a idade depois que as unidades tinham passado mais de 41 meses ligadas (Lu et al., 2022).
- Apenas cerca de metade dos SSDs trocados após falhar num data center do Google foi reparada e voltou ao serviço nos seis anos observados (Alter et al., 2019).
- Cerca de 50% dos SSDs com falha de data centers do Google, num estudo, foram reparados e voltaram ao serviço, contra 7% dos HDs com falha da Backblaze (Pinciroli et al., 2023).
Fontes: Backblaze (2014-2026); Carnegie Mellon University (2007, 2020); University of Illinois at Urbana-Champaign and NetApp; Microsoft Research (2005, 2010); Rutgers University, GoDaddy and Microsoft; Wayne State University and Northeastern University; The Chinese University of Hong Kong and Alibaba; Microsoft Research and Microsoft Azure, with the University of Newcastle and Nankai University; USENIX, Proceedings of the 2019 USENIX Annual Technical Conference; Gartner (2006); USENIX, Proceedings of the 18th USENIX Conference on File and Storage Technologies; USENIX, Proceedings of the 2022 USENIX Annual Technical Conference; ACM / IEEE, Proceedings of the International Conference; IEEE, Transactions on Dependable and Secure Computing, vol. 20, no. 1, pp. 256-270
Quanto tempo duram os HDs?
Cerca de 90% dos HDs de um parque de mais de 200.000 unidades de data center tinham durado quatro anos (Backblaze, 2021).

- 65% dos HDs de um parque de nuvem ainda funcionavam após seis anos, por uma análise de 2021.
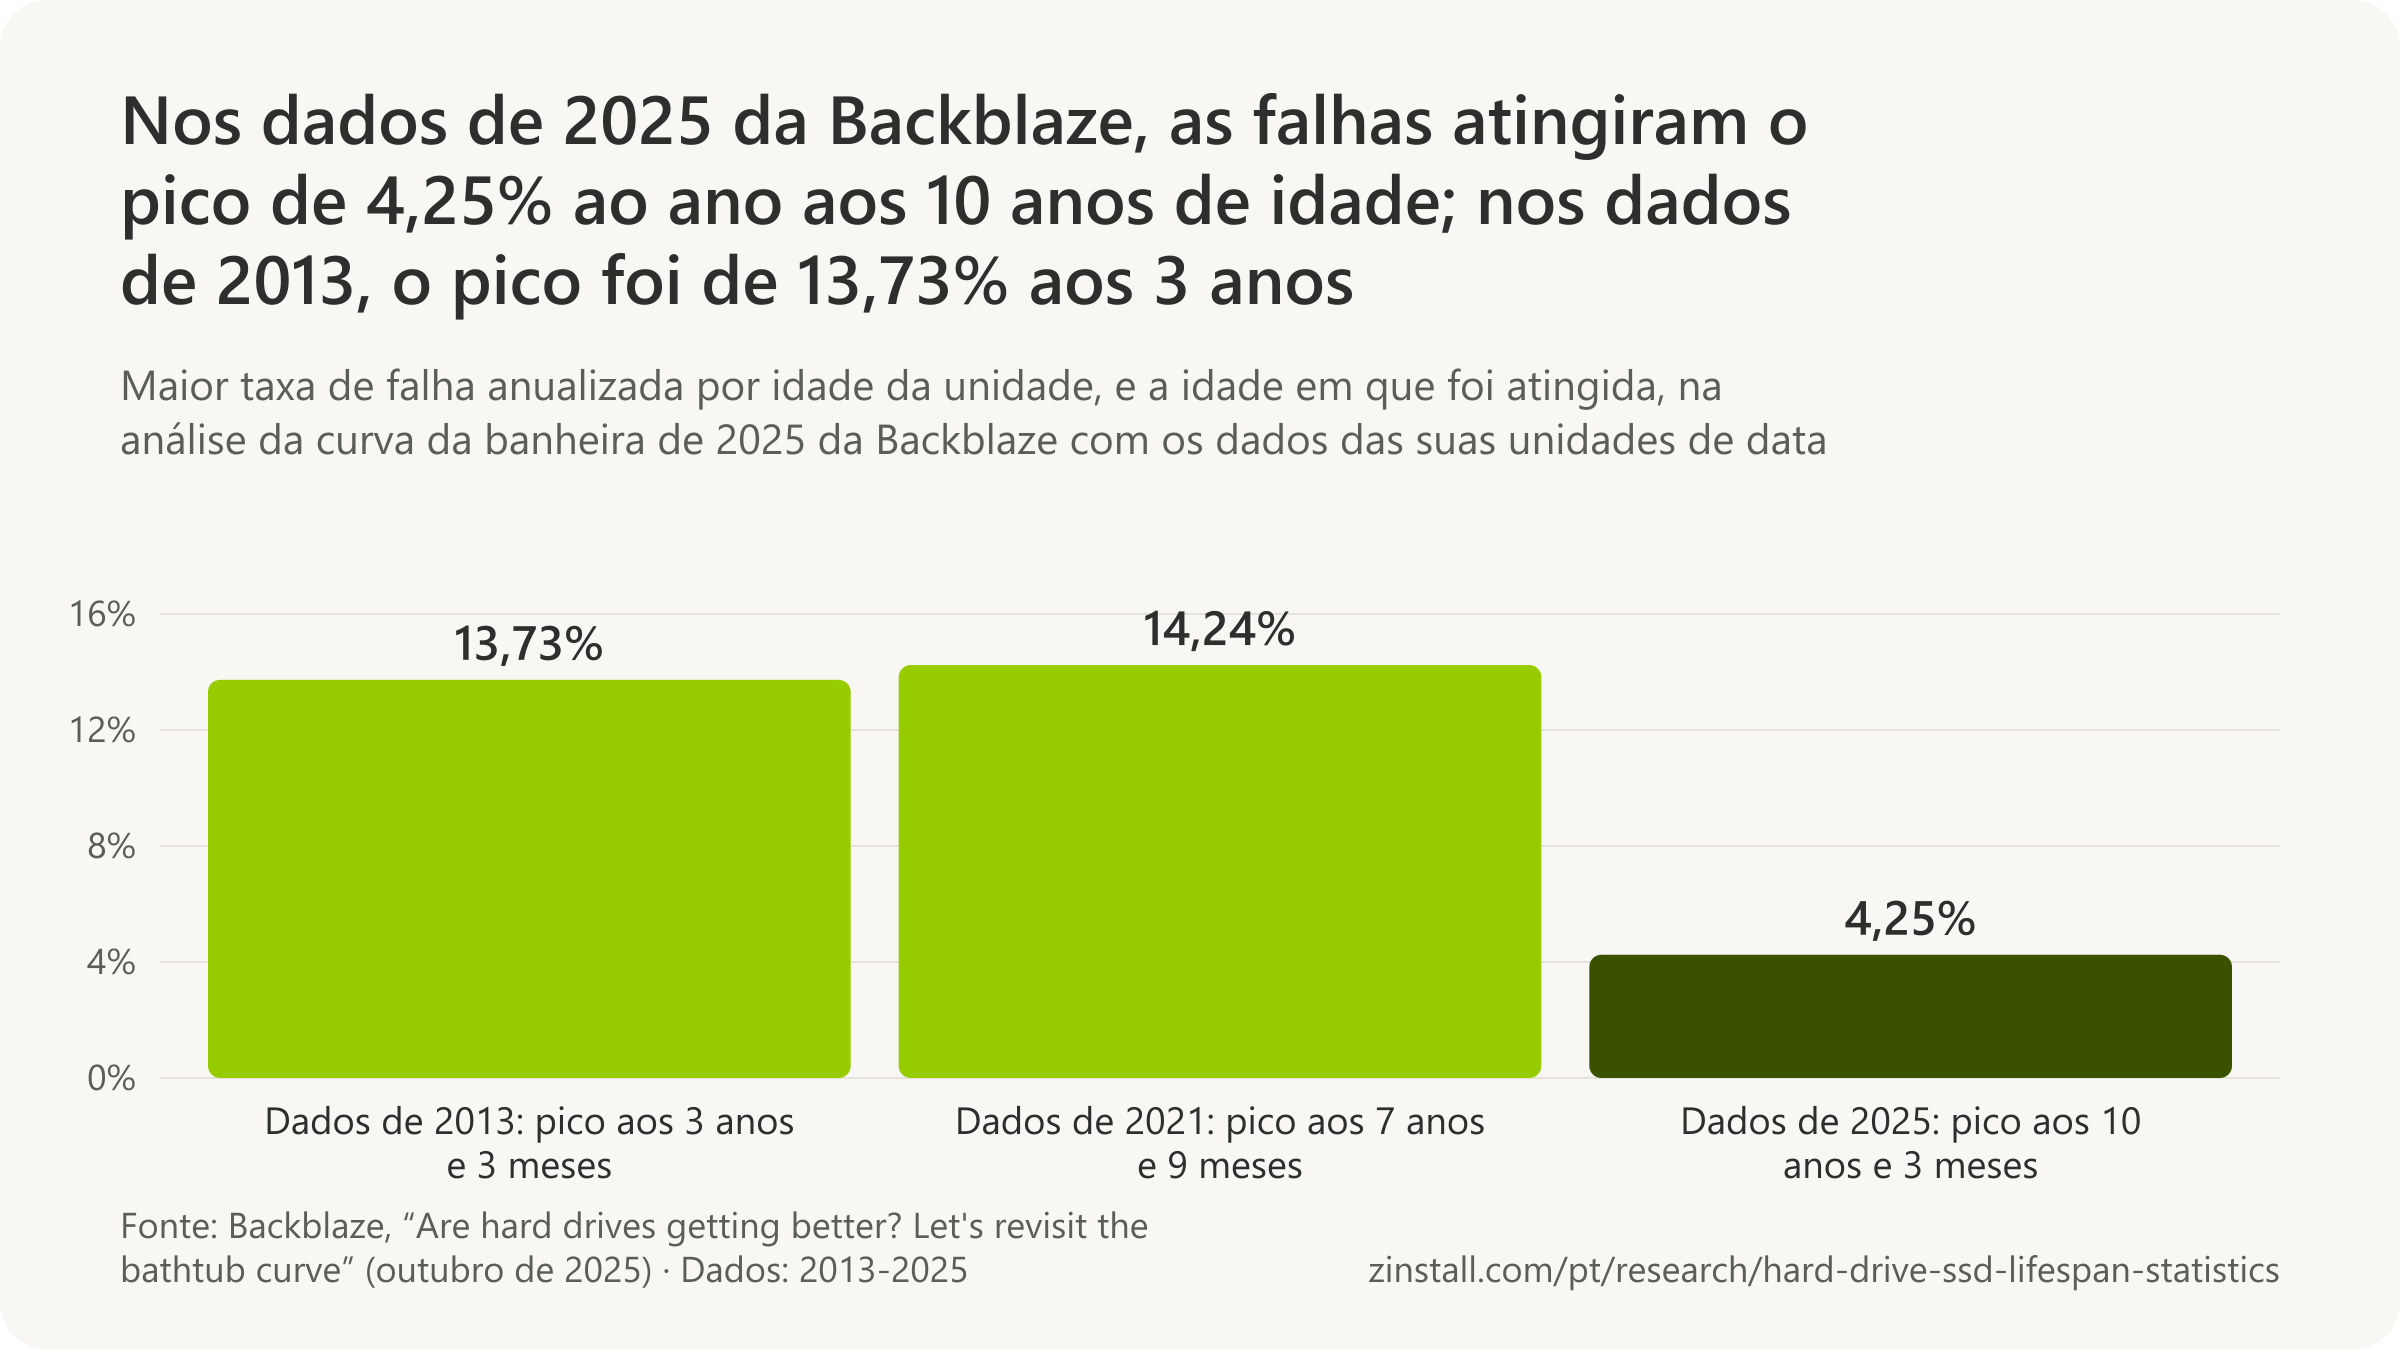
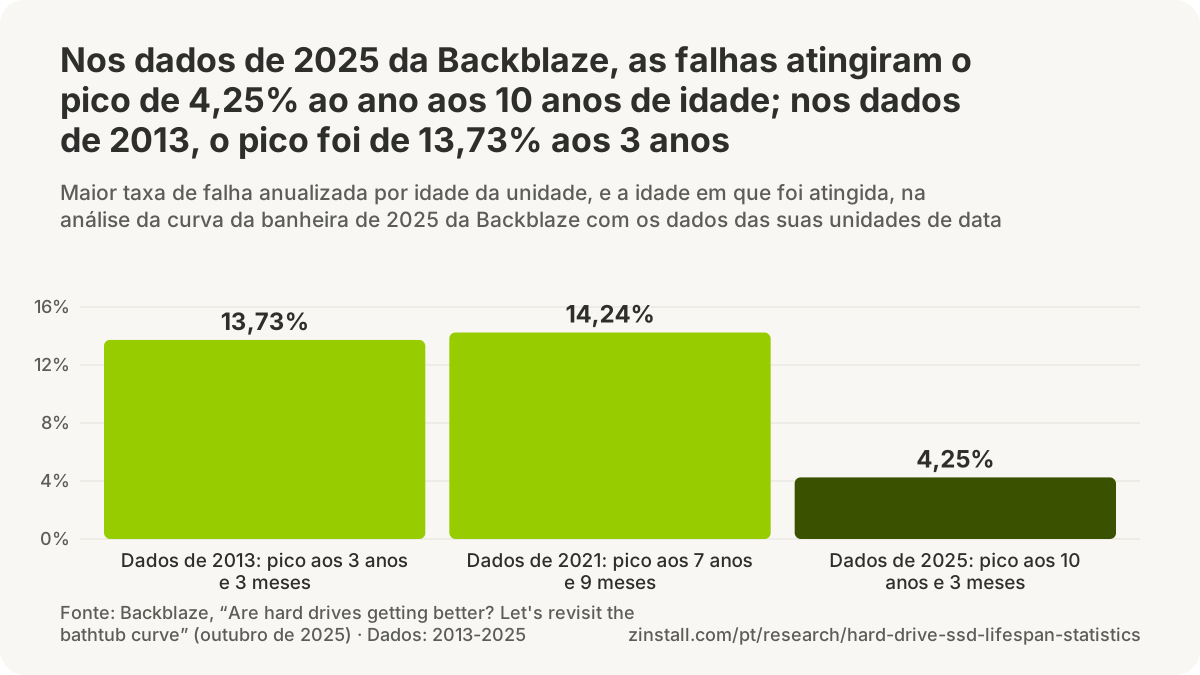
- As falhas num parque de nuvem atingiram o pico de 4,25% ao ano aos 10 anos de idade nos dados de 2025, contra 13,73% por volta dos três anos em 2013.
- Nenhum de mais de 60 modelos de unidade mostrou um início súbito de desgaste, em 5,3 milhões de unidades de data center.
- As 17.155 unidades que falharam num parque de nuvem até 2023 tinham em média 2 anos e 6 meses de idade: uma idade na falha, não uma vida útil.
- A unidade de dados mais antiga em funcionamento de um parque de nuvem tinha 8,8 anos de uso em meados de 2023.
| Fonte, medida e data | Número |
|---|---|
| Ainda funcionando após quatro anos, dados de 2013 | 78% |
| Expectativa de unidades funcionando aos seis anos, análise de outubro de 2021 | 88% |
| Vida mediana, estimativa de dezembro de 2021 (extrapolada) | 6 anos e 9 meses |
| Vida mediana, projeção de 2013 | mais de 6 anos |
| Taxa de falha no primeiro ano de serviço, dados de 2025 | menos de 1,30% |
| Idade média das unidades que tinham falhado, 2024 | 2 anos e 10 meses |
| Idade em que unidades funcionando foram substituídas por outras mais densas, 2018 | cerca de 4 anos |
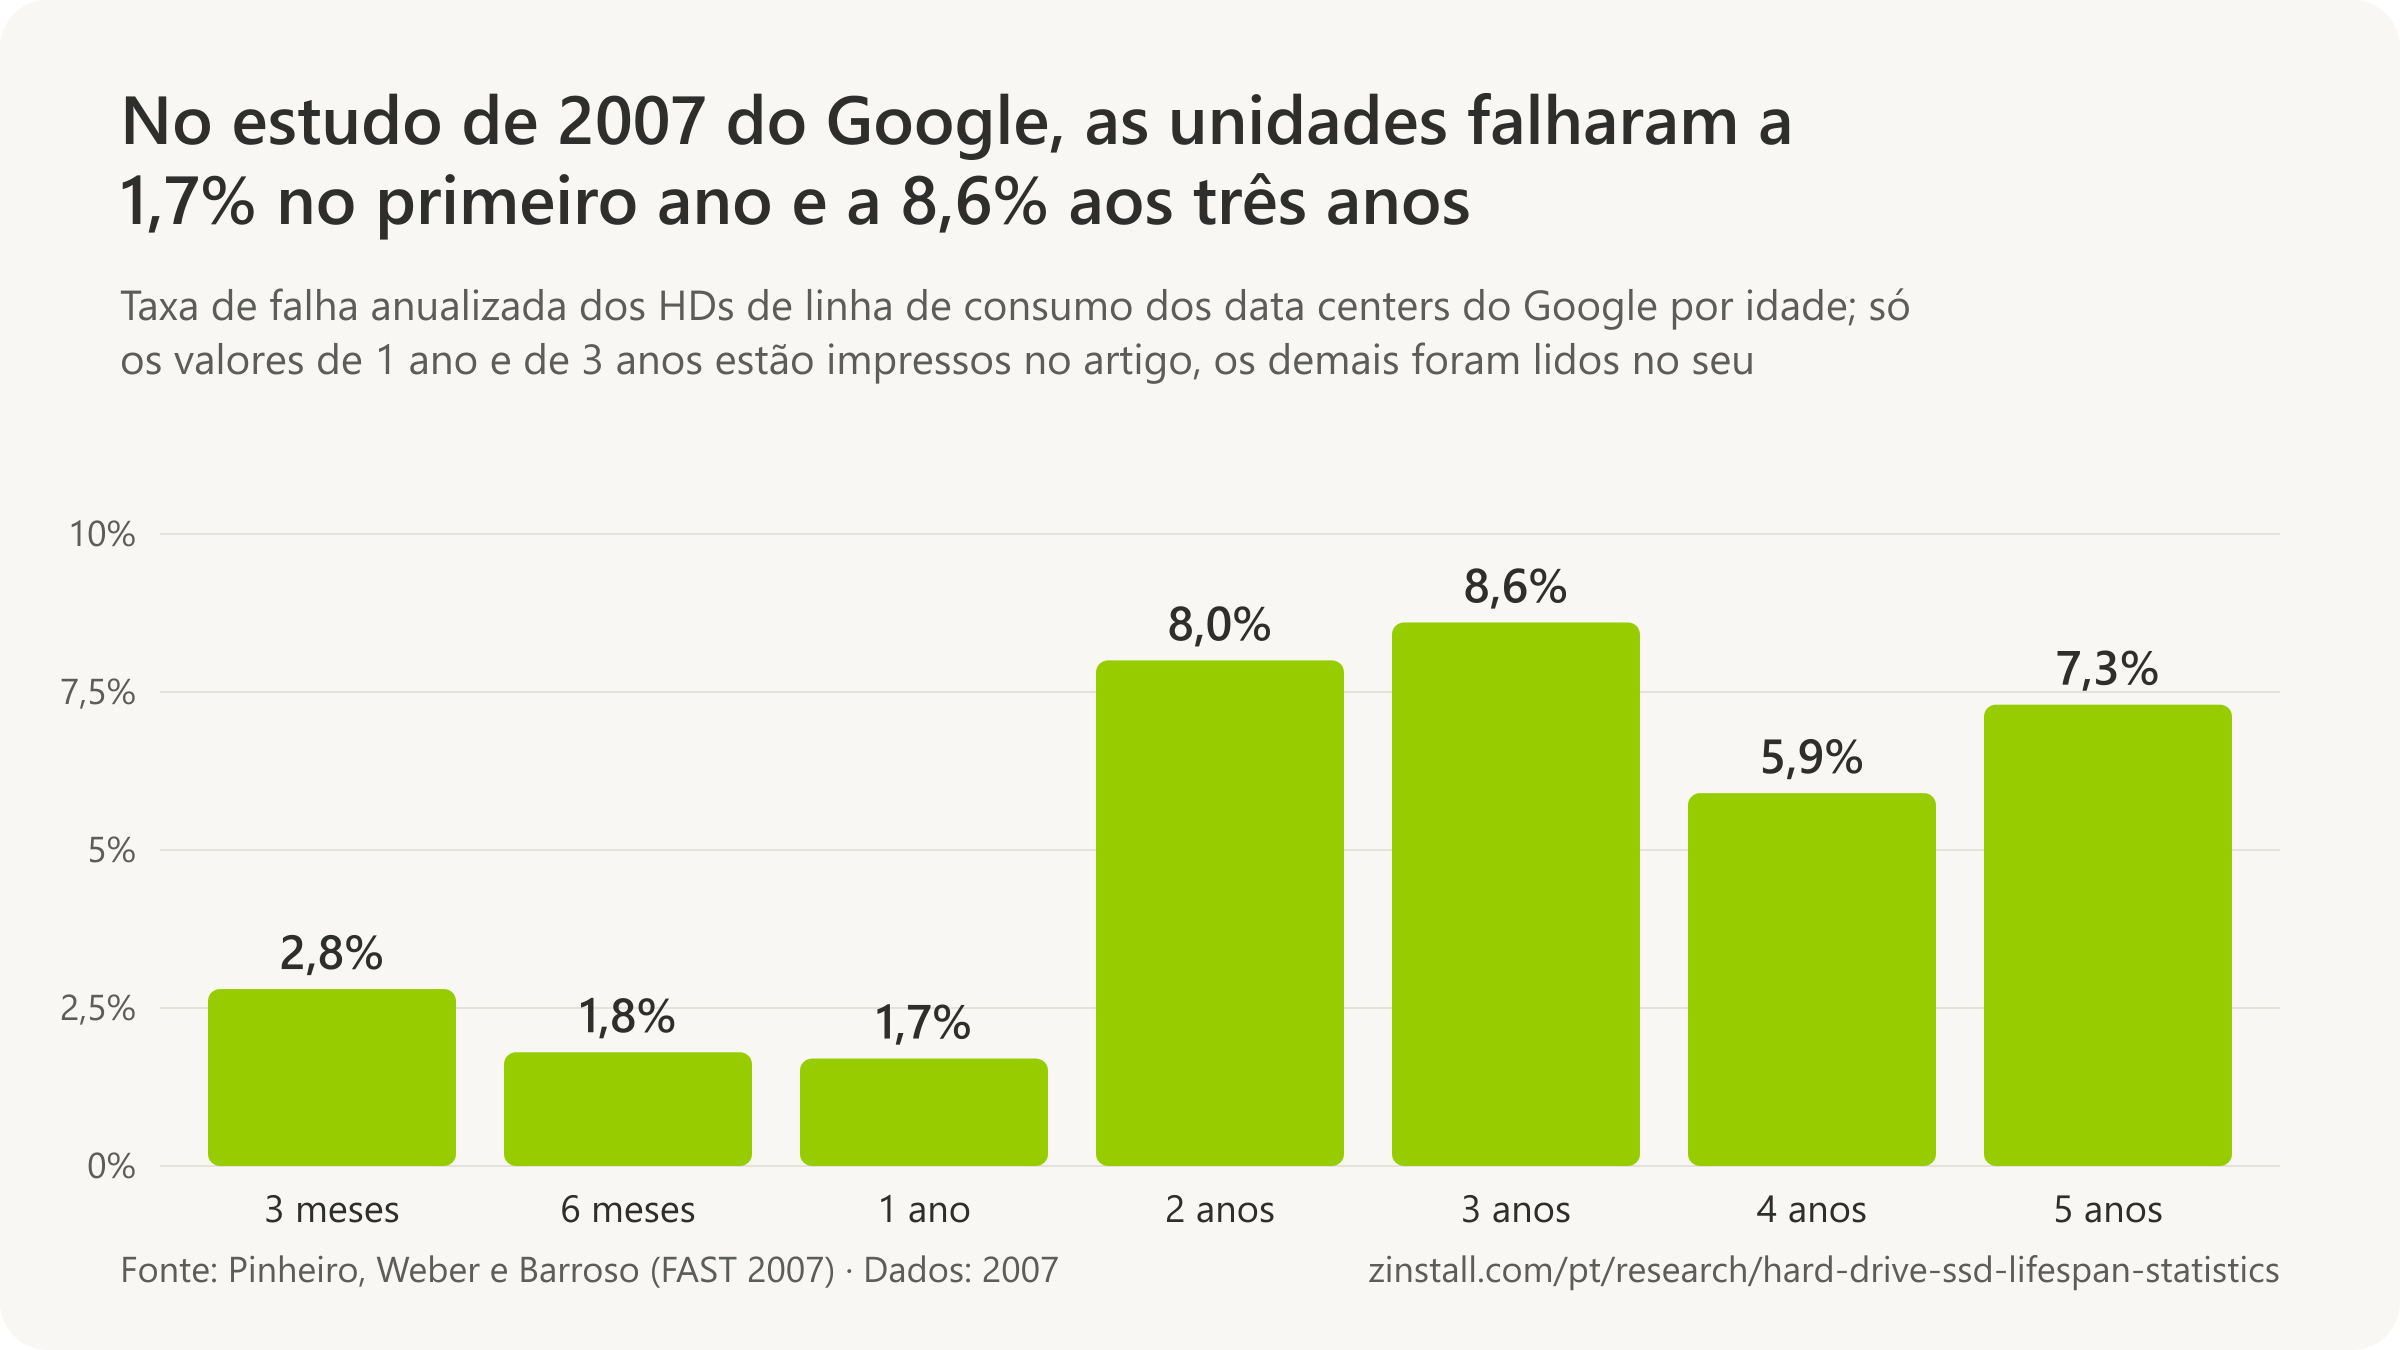
| Google: taxa de falha no primeiro ano, 2007 | 1,7% |
| Google: taxa de falha aos três anos, 2007 | 8,6% |
| Carnegie Mellon: taxas de substituição por ano de uso, 2007 | cerca de 2 vezes |
Fontes: Backblaze (2013-2025); Carnegie Mellon University (2020, 2007); Google
Guias relacionados: Um HD antigo para um PC novo · Um computador quebrado ou que não liga · Mensagem “Windows detected a hard disk problem”
Mais estatísticas (44)
Nenhum estudo acompanhou as unidades de PCs domésticos até o fim, então as respostas medidas vêm de data centers e das unidades enviadas a laboratórios de recuperação. As contagens de sobrevivência da Backblaze mostram que a maioria dos seus HDs passa dos quatro anos, e a idade em que as falhas atingem o pico ficou mais tardia desde 2013. A curva da banheira dos manuais, muitas falhas no início e depois um longo trecho tranquilo, não apareceu nos maiores estudos; a idade média das unidades que falharam é uma medida diferente de quanto tempo as unidades duram.
Quantas unidades sobrevivem a quatro e a seis anos
- 78% dos HDs que a Backblaze comprou ainda funcionavam após quatro anos, pela sua contagem de cerca de 25.000 unidades de data center (Backblaze, 2013).
- Mais de 6 anos é a vida útil mediana que a Backblaze projetou em 2013 para os seus HDs de data center, extrapolada de quatro anos de dados de sobrevivência (Backblaze, 2013).
- 80% dos HDs que a Backblaze instala funcionam por pelo menos quatro anos, pela própria experiência da empresa, como ela declarou em 2015 (Backblaze, 2015).
- Cerca de 90% dos HDs da Backblaze tinham durado quatro anos, pela sua análise de sobrevivência de 2021 com mais de 200.000 unidades de data center (Backblaze, 2021).
- 65% dos HDs da Backblaze ainda funcionavam após seis anos, pela sua análise de sobrevivência de 2021 com mais de 200.000 unidades de data center (Backblaze, 2021).
- 6 anos e 9 meses é a estimativa da Backblaze para a vida mediana dos seus HDs de data center, extrapolada de seis anos de dados de sobrevivência (Backblaze, 2021).
- De 2% a 2,5% dos HDs da Backblaze foram perdidos a cada ano nos seus primeiros quatro anos, e depois disso as perdas se aceleraram, pela sua análise de sobrevivência de 2021 (Backblaze, 2021).
- 88% dos HDs da Backblaze tinham expectativa de estar funcionando aos seis anos em 2021, contra 50% nos seus dados de 2013, pela análise da curva da banheira da Backblaze; a sua análise de sobrevivência dois meses depois, um método diferente, pôs a sobrevivência aos seis anos em 65% (Backblaze, 2021).
- 362 dias (8.687 horas de funcionamento) foi o tempo mediano de funcionamento antes da falha entre 5.106 HDs com falha enviados à Secure Data Recovery de 2023 a meados de 2026 (Secure Data Recovery, 2026).
- 5.536 horas de funcionamento foi a mediana na falha dos HDs da Western Digital enviados à Secure Data Recovery de 2023 a meados de 2026, contra 15.070 da Seagate, 7.639 da Toshiba e 14.348 da Hitachi (Secure Data Recovery, 2026).
Em que momento da vida uma unidade falha: a curva da banheira
- 5,1% dos HDs da Backblaze falharam por ano entre 0 e 18 meses de idade, no seu estudo de 2013 com cerca de 25.000 unidades de data center (Backblaze, 2013).
- 1,4% dos HDs da Backblaze falharam por ano entre 18 meses e 3 anos de idade, no seu estudo de 2013 com cerca de 25.000 unidades de data center (Backblaze, 2013).
- 11,8% dos HDs da Backblaze falharam por ano depois de passar dos três anos de idade (até os quatro anos, o fim dos seus dados), no seu estudo de 2013 com cerca de 25.000 unidades de data center (Backblaze, 2013).
- Menos de 1,30% dos HDs da Backblaze falharam, em base anualizada, no primeiro ano de serviço, na sua análise da curva da banheira de 2025 (Backblaze, 2025).
- Cerca de 1,0% ao ano foi a taxa de falha dos HDs Seagate de 8TB da Backblaze nos seus primeiros 60 meses, o perfil que a Backblaze chama de normal antes de as falhas subirem com a idade (Backblaze, 2024).
- As taxas de substituição de HDs quase dobraram do ano 1 para o ano 2, ou do ano 2 para o ano 3, no registro de cinco anos de um supercomputador, subindo de forma constante em vez de se estabilizar como supõe a curva da banheira (Carnegie Mellon University, 2007).


- 24% dos HDs com mais de sete anos foram substituídos em um ano, entre 432 unidades Fibre Channel instaladas em 1998 num provedor de serviços de internet e registradas em 2005 (Carnegie Mellon University, 2007).
- Cerca de 1,4% dos HDs SATA foram substituídos no primeiro ano de idade em clusters de computação de alto desempenho (Carnegie Mellon University, 2007).
- Cerca de 2,4% dos HDs SATA foram substituídos no segundo ano de idade em clusters de computação de alto desempenho (Carnegie Mellon University, 2007).
- Cerca de 2,9% dos HDs SATA foram substituídos no terceiro ano de idade em clusters de computação de alto desempenho (Carnegie Mellon University, 2007).
- De 63% a 66% dos HDs com falha de três modelos SATA falharam no quarto ano de serviço, então as unidades instaladas juntas tendiam a falhar juntas, em appliances de backup da EMC (EMC, 2015).
- Nenhum de mais de 60 modelos e marcas de HD mostrou um início súbito de desgaste: as taxas de falha subiram aos poucos com a idade, em 5,3 milhões de unidades no Google, na NetApp e na Backblaze (Carnegie Mellon University, 2020).
- Em até 20 dias após a instalação, a taxa de falha da maioria dos modelos de HD caiu bruscamente e se estabilizou, no Google e na NetApp, enquanto as unidades da Backblaze mostraram uma infância mais longa e com taxas mais altas (Carnegie Mellon University, 2020).
- 50% das falhas no primeiro ano dos componentes de PC vendidos por uma grande varejista on-line francesa foram relatadas em até um mês e meio após o envio, e 25% em até 10 dias, pela contagem do hardware.fr (hardware.fr, 2014).
A idade das unidades que falharam
- 2 anos e 6 meses foi a idade média dos 17.155 HDs que falharam nos data centers da Backblaze de abril de 2013 a março de 2023 (Backblaze, 2023).
- 2 anos e 7 meses era a idade média de 3.379 HDs com falha de modelos que a Backblaze tinha aposentado por completo, que não podem mais falhar nem envelhecer (Backblaze, 2023).
- 2 anos e 10 meses era a idade média dos 21.388 HDs que tinham falhado nos data centers da Backblaze até março de 2024 (Backblaze, 2024).
- Perto de 4 anos é a idade média na falha que a Backblaze previu em 2024 para os seus modelos de unidade aposentados quando as suas unidades de 4TB saírem de serviço (Backblaze, 2024).
- Cerca de 4 anos de serviço foi o ponto em que a Backblaze concluiu, em 2018, que fazia sentido financeiro substituir unidades em funcionamento por outras mais densas, aposentando unidades de 4TB com 3,5 a 4 anos de idade (Backblaze, 2018).
- 8,8 anos era a idade da unidade de dados mais antiga em funcionamento da Backblaze em meados de 2023, um Seagate de 4TB, enquanto a unidade mais antiga em funcionamento no geral, uma unidade de boot WDC de 500GB, tinha 10,2 anos de uso (Backblaze, 2023).
- Quase 100 dos HDs Seagate de 4TB da Backblaze funcionaram mais de 100 meses (mais de oito anos) antes de ser aposentados, de um modelo que chegou a 34.744 unidades em 2016 (Backblaze, 2024).
- 0,86% é a taxa de falha anualizada de todo o tempo de serviço dos HDs Seagate de 6TB da Backblaze, com idade média de nove anos e nenhuma falha no 1º trimestre de 2024 (Backblaze, 2024).
- 1,33% é a taxa de falha anualizada conjunta, de todo o tempo de serviço, dos modelos de HD da Backblaze que tinham seis anos ou mais em meados de 2025 (Backblaze, 2025).
- Quase 20% dos HDs dos data centers da Backblaze no fim de 2023 eram de nove modelos com idade média de seis anos ou mais (Backblaze, 2024).
- 1 ano e 8 meses era a idade média dos 3.579 HDs de 12TB com falha da Backblaze, contra 4 anos e 7 meses dos seus 76 HDs de 1TB com falha, pela contagem da Backblaze (Backblaze, 2023).
- 3,8 anos (45,9 meses) era a idade média dos HDs da tabela de falhas do 2º trimestre de 2026 da Backblaze, ponderando a idade média de cada modelo pelo seu número de unidades (dados da Backblaze, 2026).
- A maioria dos HDs enviados à Japan Data Technology para recuperação em 2009 tinha sido fabricada cerca de quatro a cinco anos antes, entre mais de 40.000 unidades (Japan Data Technology, 2010).

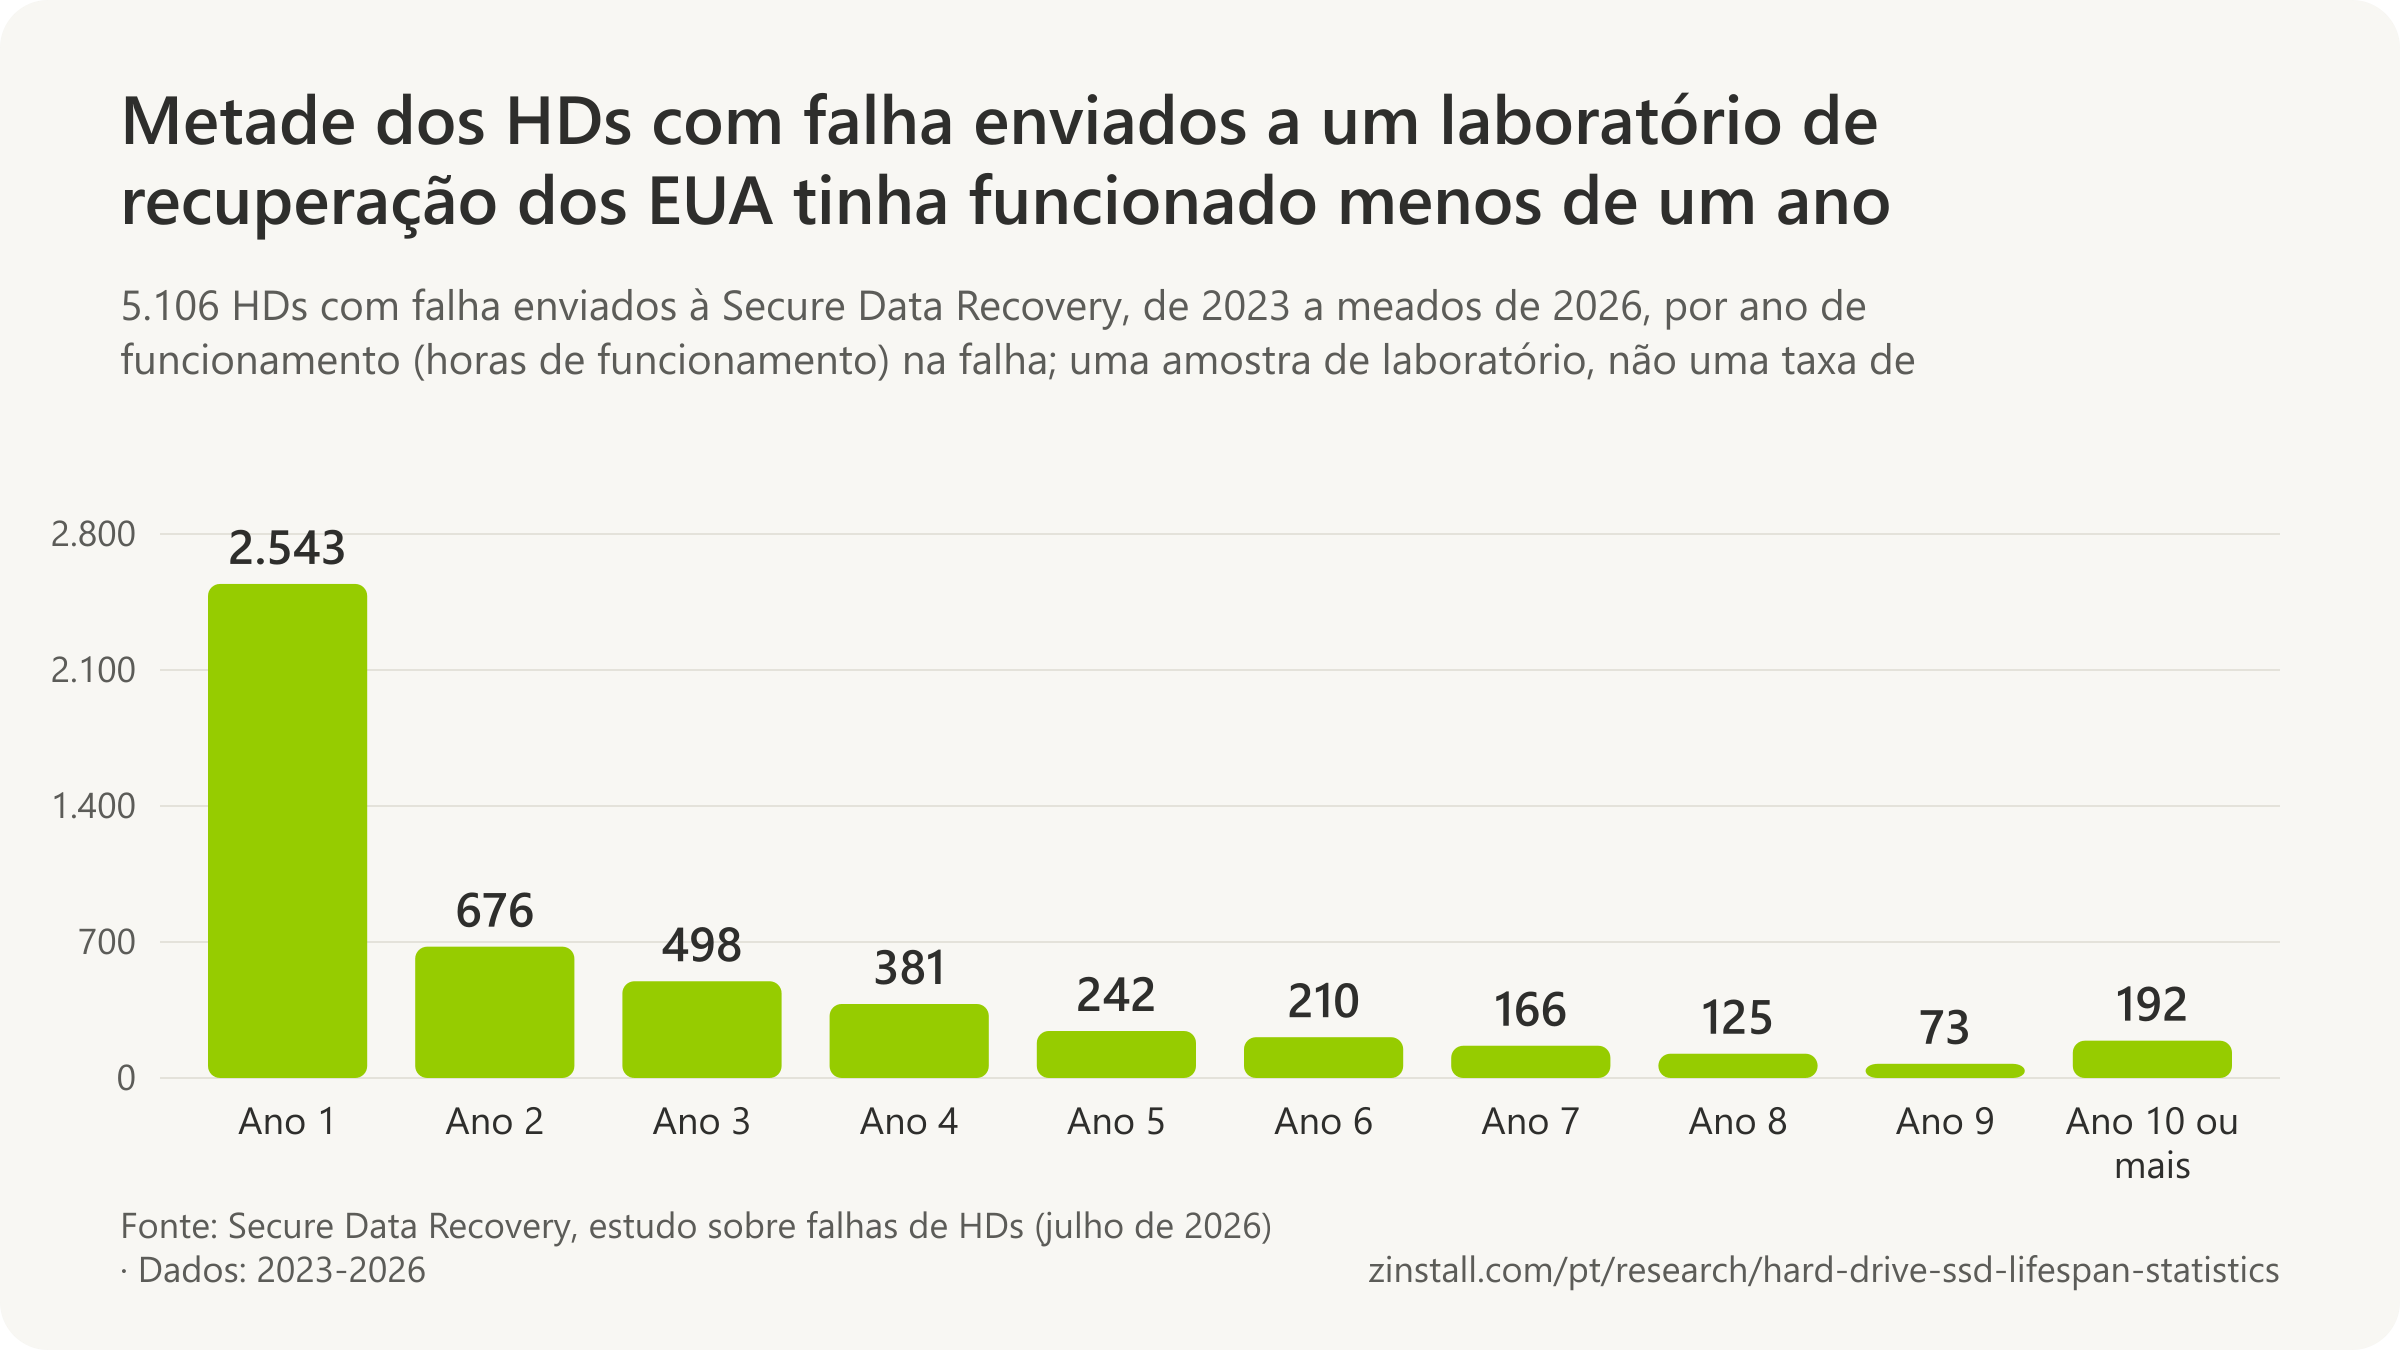
- 807 dias (19.375 horas de funcionamento, cerca de 2 anos e 2 meses) foi o tempo médio de funcionamento antes da falha entre 5.106 HDs com falha enviados à Secure Data Recovery de 2023 a meados de 2026 (Secure Data Recovery, 2026).
- 49,8% dos HDs com falha enviados à Secure Data Recovery de 2023 a meados de 2026 tinham funcionado menos de um ano (8.760 horas de funcionamento) quando falharam, entre 5.106 unidades (Secure Data Recovery, 2026).
- O tempo médio de funcionamento antes da falha dos HDs enviados à Secure Data Recovery foi 23,2% menor na sua amostra de 2023-2026 (807 dias) do que na sua amostra de 2022 (1.051 dias) (Secure Data Recovery, 2026).
- 25.233 horas de funcionamento (1.051 dias, cerca de 2 anos e 10 meses) foi o tempo médio de funcionamento antes da falha entre 2.007 HDs com falha enviados à Secure Data Recovery em 2022 (Secure Data Recovery, 2023).
- 1.548 setores defeituosos (contagem atual de setores pendentes) foi a média na falha entre 2.007 HDs com falha enviados à Secure Data Recovery em 2022 (Secure Data Recovery, 2023).
- 34.799 horas de funcionamento foi a média na falha dos HDs da Toshiba enviados à Secure Data Recovery em 2022, a maior de seis fabricantes, contra 25.676 da Western Digital, 23.298 da Seagate e 18.632 da Hitachi (Secure Data Recovery, 2023).
- Os cinco modelos de HD mais duráveis de cada fabricante na amostra de 2022 da Secure Data Recovery, com 2.007 unidades com falha, foram todos fabricados antes de 2015, e a maioria dos menos duráveis depois de 2015 (Secure Data Recovery, 2023).
Fontes: Backblaze (2013-2026); Secure Data Recovery Services (2023, 2026); Carnegie Mellon University (2007, 2020); EMC Corporation and Datrium; Hardware.fr; Japan Data Technology; Google
Quanto tempo duram os SSDs?
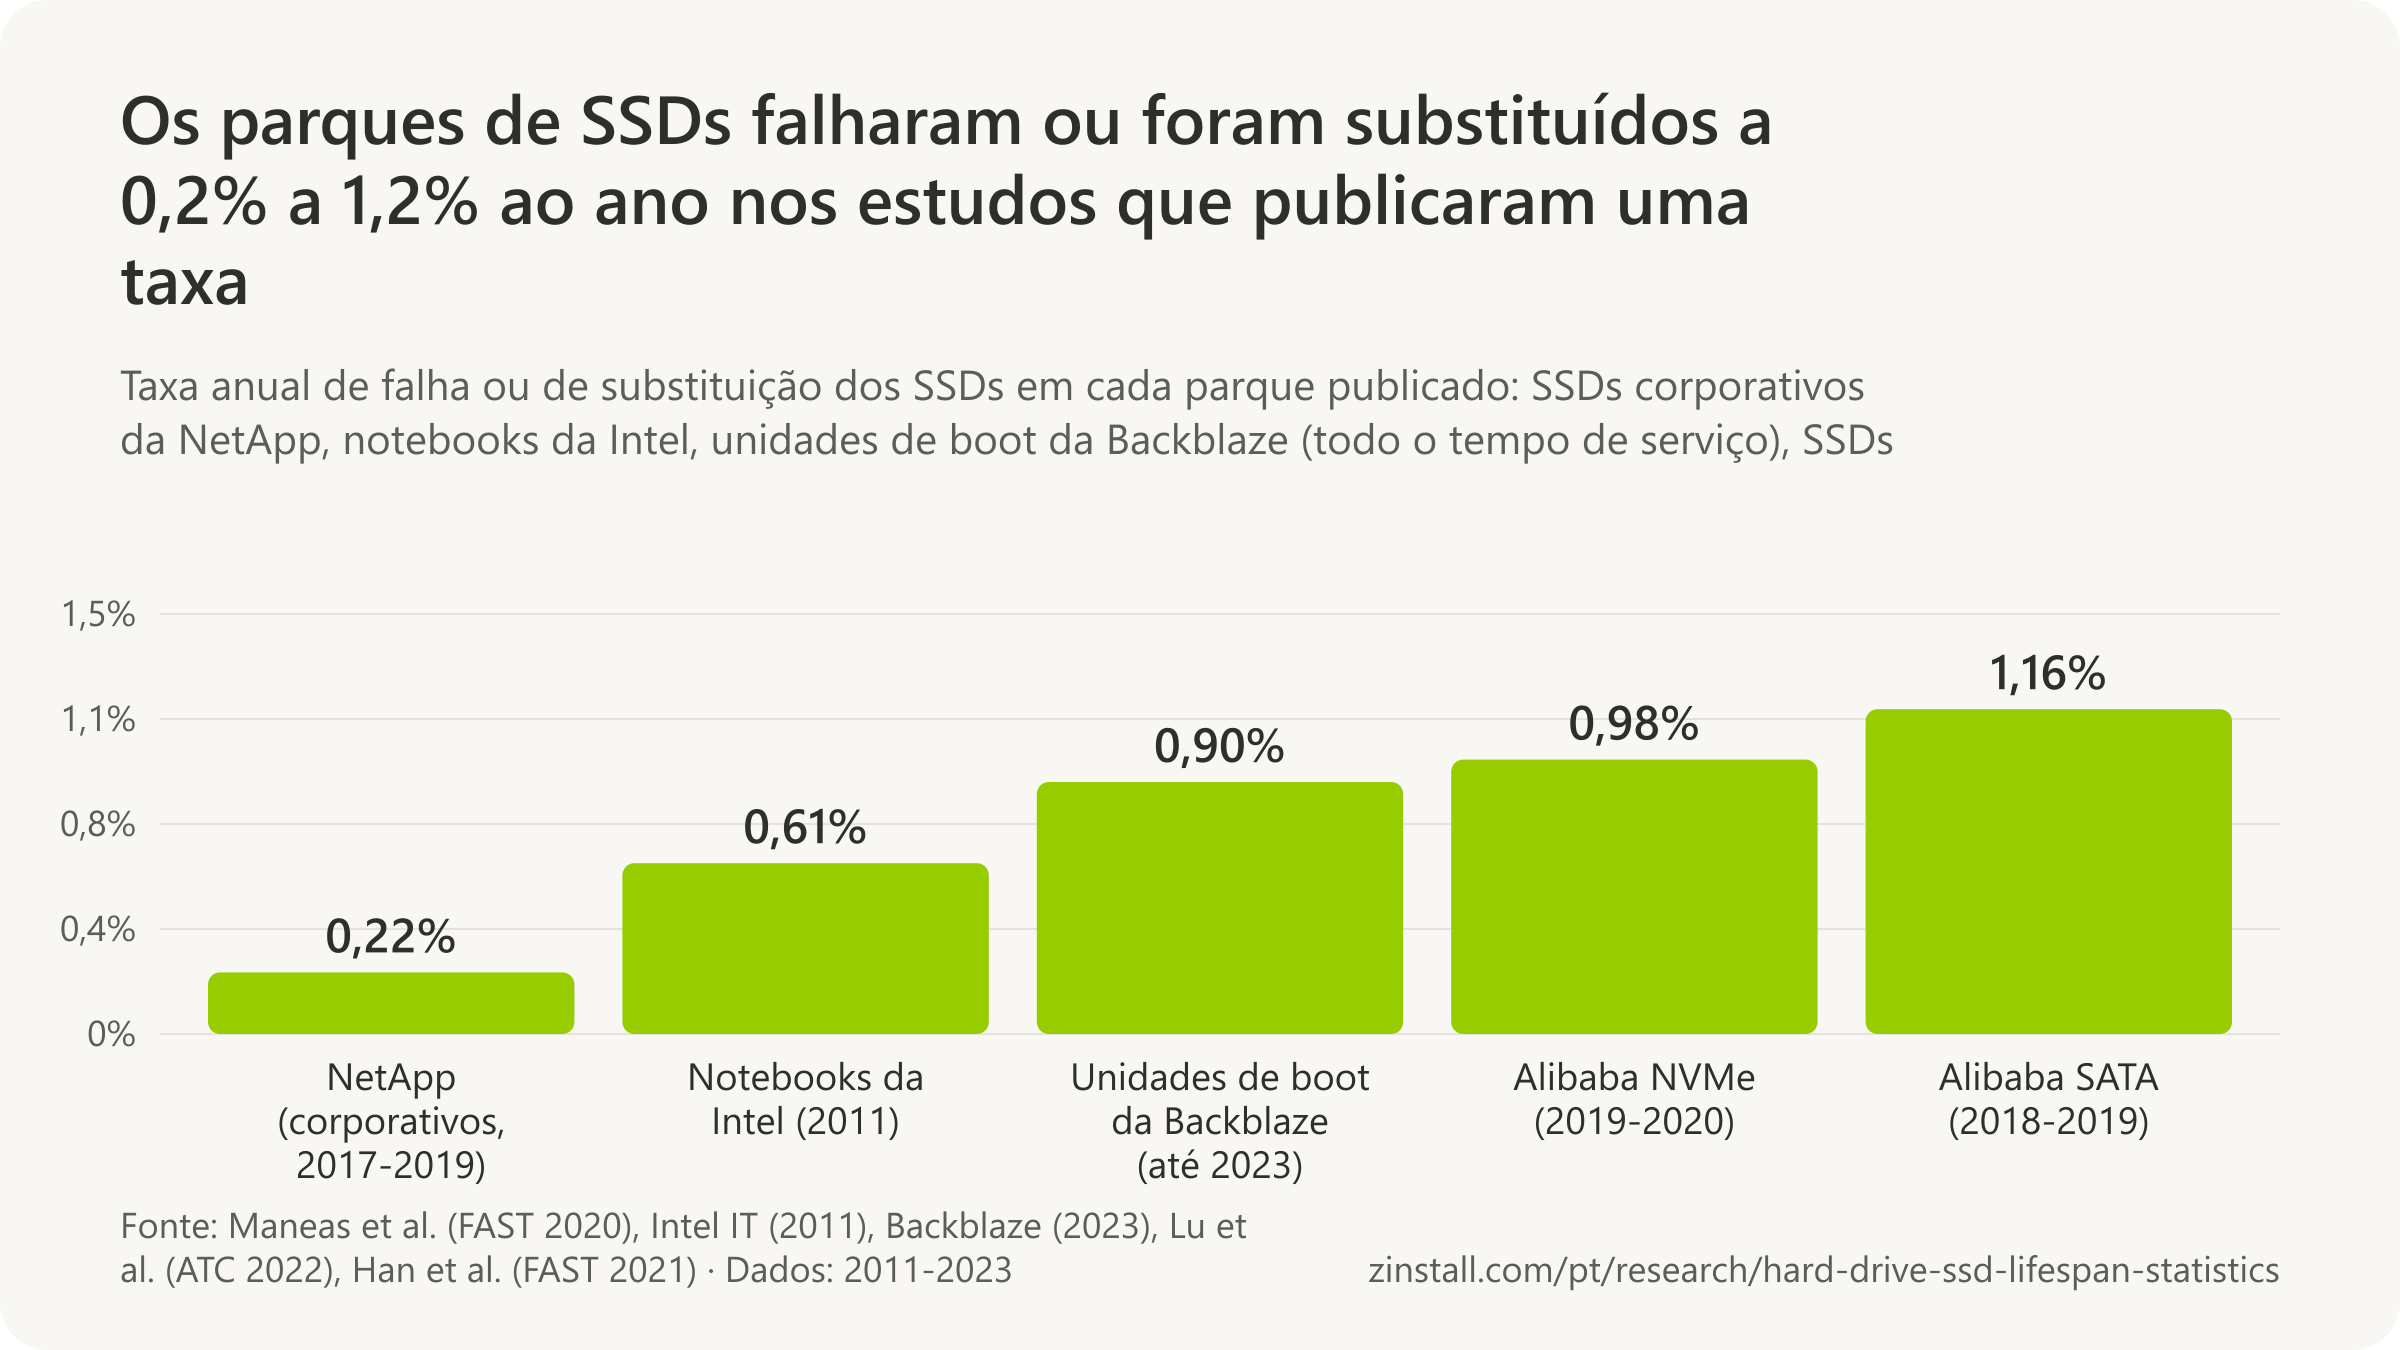
0,22% dos SSDs corporativos nos clientes de um fabricante de sistemas de armazenamento foram substituídos por ano, de 2017 a 2019 (Maneas et al., 2020).

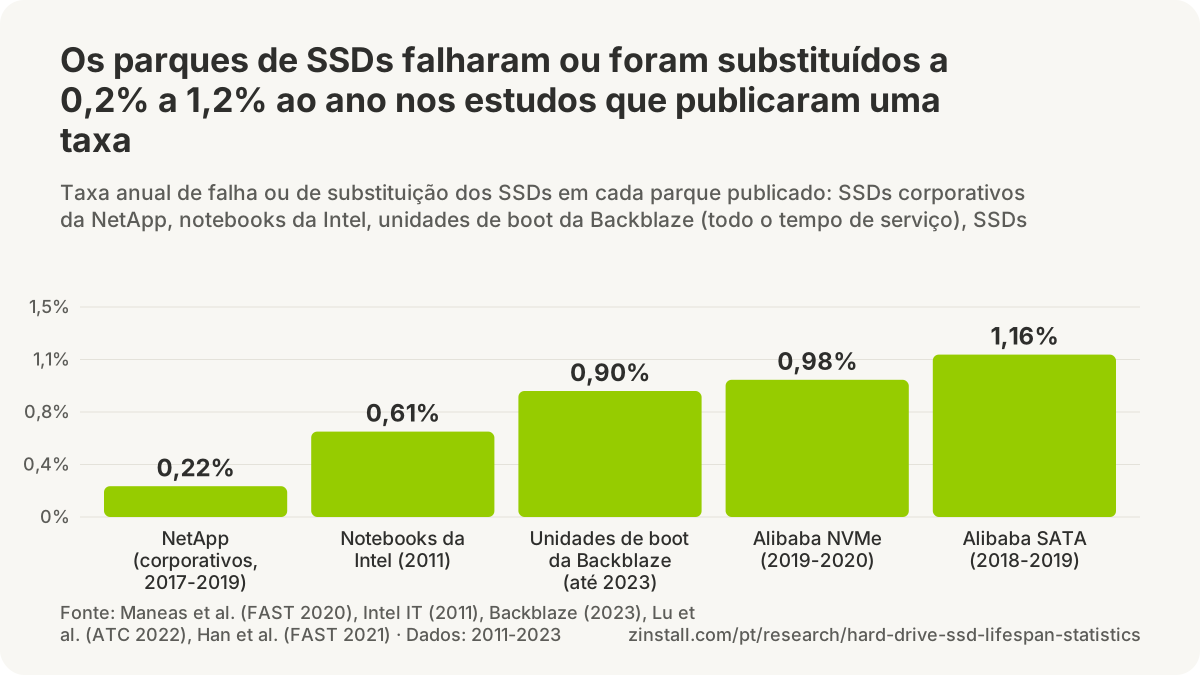
- Quase 98% das falhas de SSD num data center ocorreram antes que metade dos ciclos de gravação nominais tivesse sido usada (Alter et al., 2019).
- Quase um milhão de SSDs SATA nos data centers da Alibaba falharam a 1,16% ao ano em 2018 e 2019.
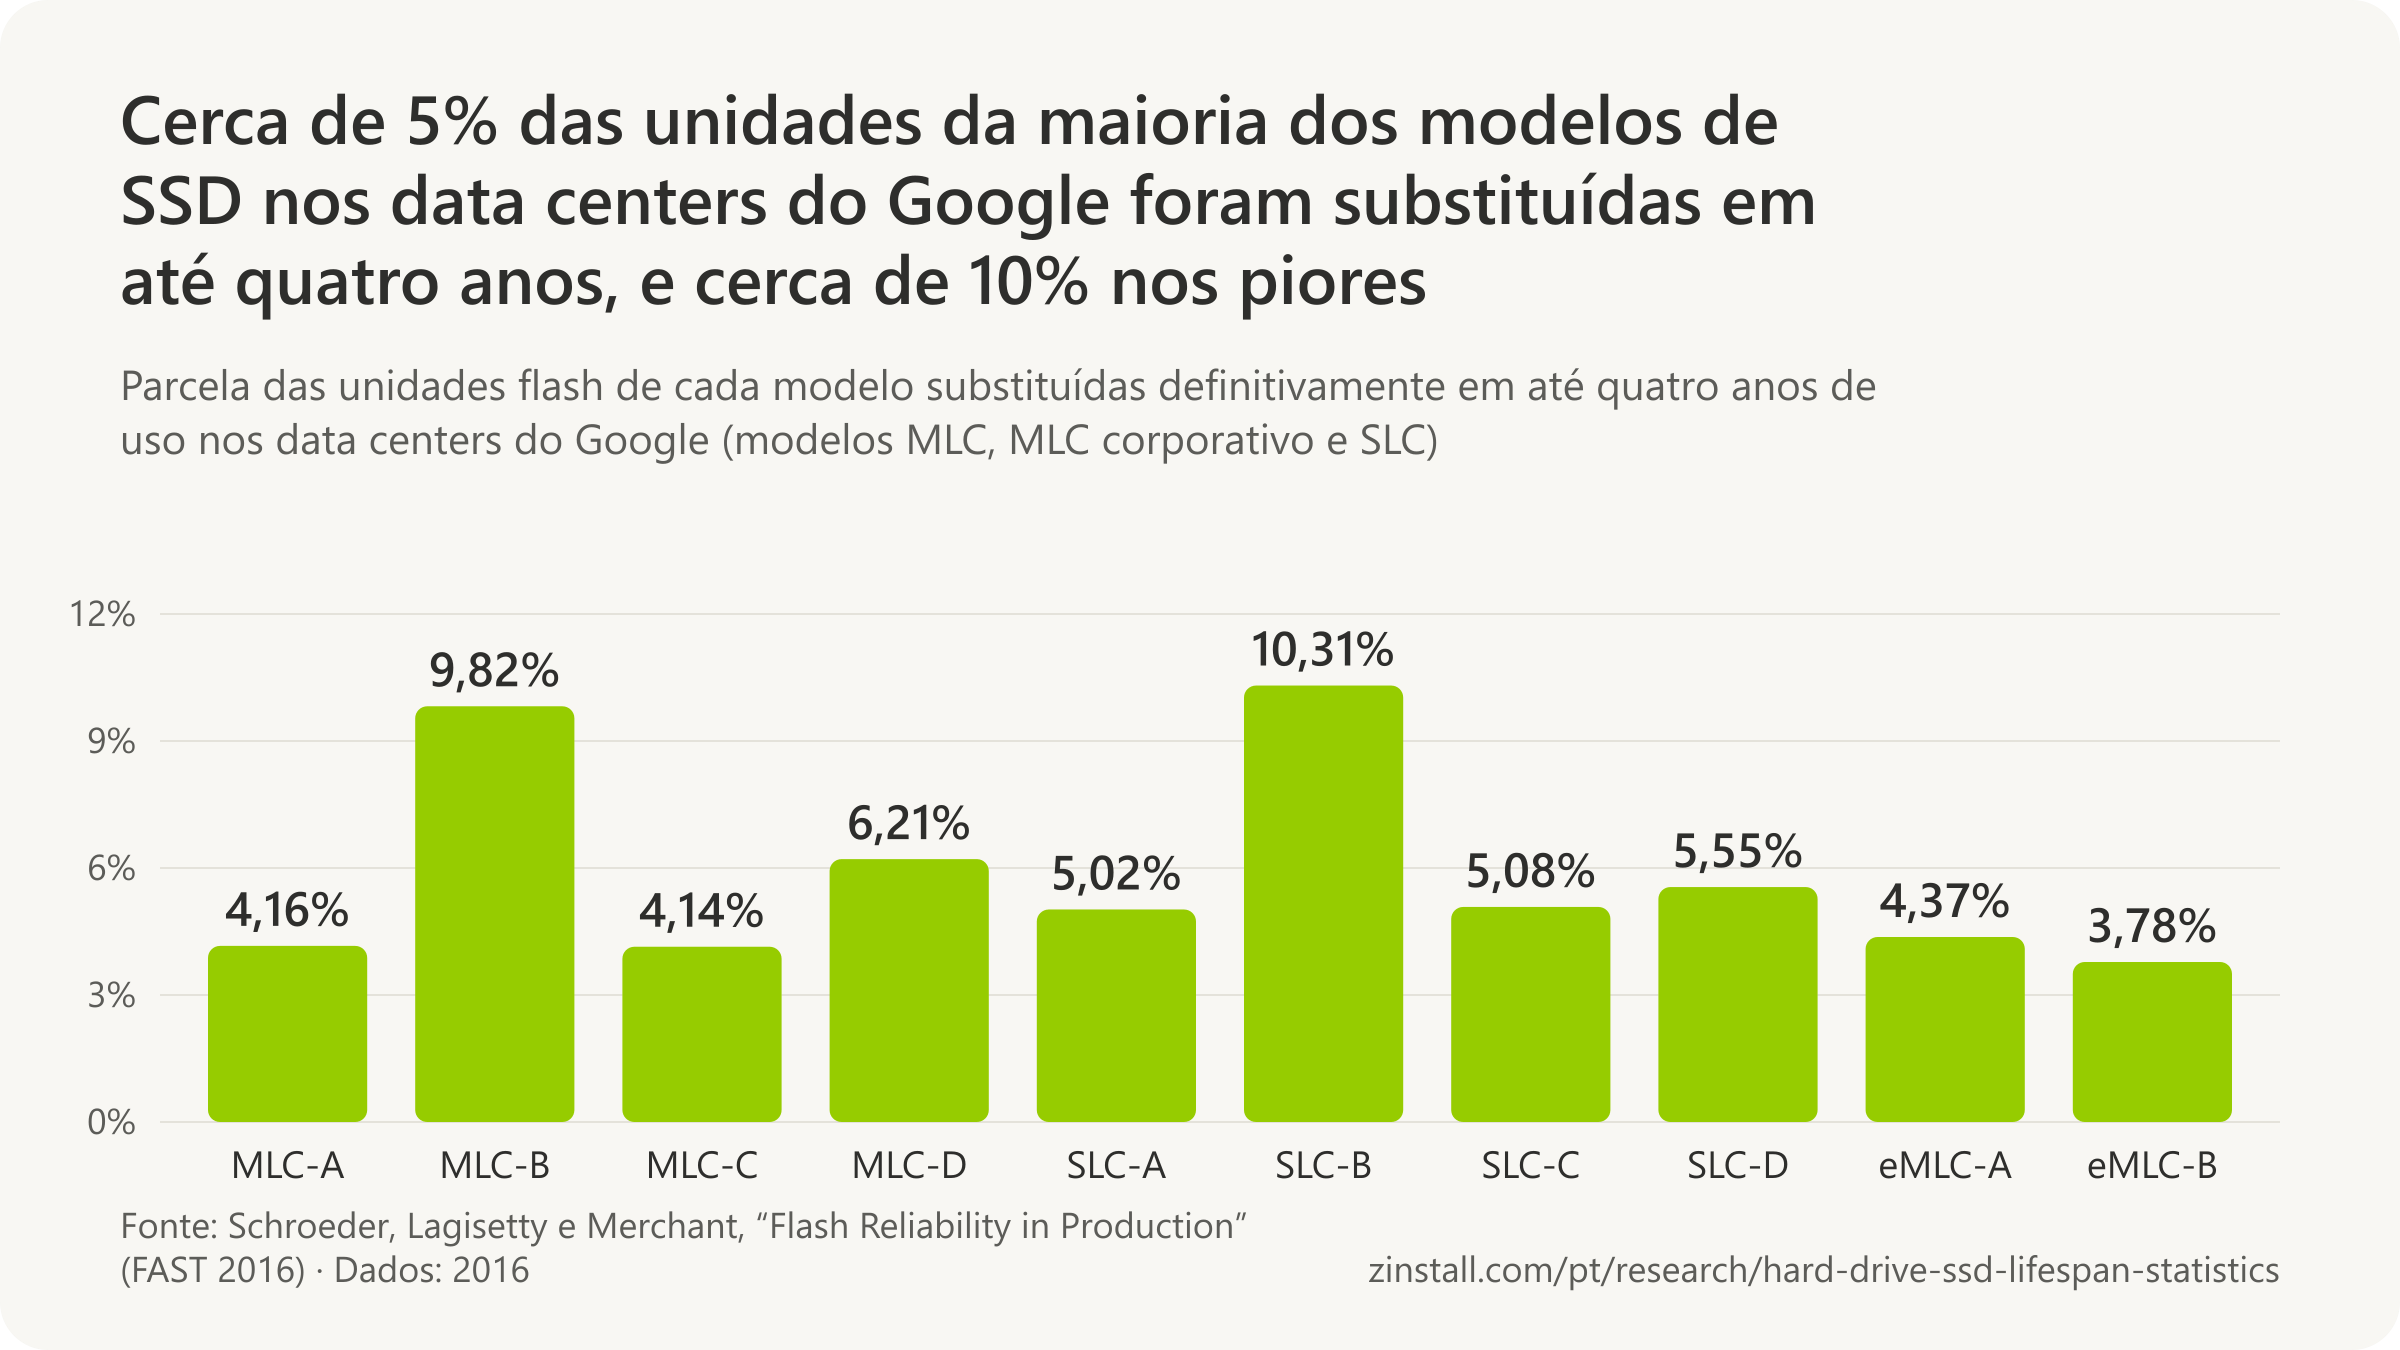
- Cerca de 5% das unidades da maioria dos modelos de SSD nos data centers do Google foram substituídas em até quatro anos.
- Os SSDs 3D-TLC, mais densos, dos sistemas da NetApp foram substituídos com frequência cerca de 1,5 vez maior que unidades MLC corporativas com uso semelhante.
- 0,74% de todos os SSDs que uma montadora de estações de trabalho dos EUA já vendeu falharam.
| Parque, medida e data | Número |
|---|---|
| Alibaba: SSDs NVMe substituídos por ano, 2019-2020 | 0,98% (mediana 0,69%) |
| Alibaba: SSDs SATA 3D-TLC, 2018-2019 | mais de 3% (3,29%, 3,92%) |
| Microsoft: falhas em campo acima da especificação dos fabricantes | até 70% acima da especificação |
| Google: trocados pelo menos uma vez em seis anos | 11,3% (6,95-14,3%) |
| Google: falhas nos primeiros 90 dias | 25% nos primeiros 90 dias |
| NetApp: quanto tempo duraram as falhas precoces | 12-15 meses |
| NetApp: o firmware mais antigo contra o mais recente | até 10 vezes |
| Backblaze: idade média das suas unidades de boot SSD que falharam | 14 meses |
| Tencent: SSDs NVMe corporativos da Samsung, estimativa aproximada | menos de 0,2% ao ano |
| Puget Systems: SSDs NVMe Kingston KC3000, 2024 | 0,08% |
Fontes: USENIX, Proceedings of the 18th USENIX Conference on File and Storage Technologies; ACM / IEEE, Proceedings of the International Conference; USENIX, Proceedings of the 19th USENIX Conference on File and Storage Technologies; USENIX, Proceedings of the 14th USENIX Conference on File and Storage Technologies; Puget Systems (2026, 2025); USENIX, Proceedings of the 2022 USENIX Annual Technical Conference; ACM, Proceedings of the 9th ACM International Systems and Storage Conference; Backblaze; USENIX, Proceedings of the 21st USENIX Conference on File and Storage Technologies; Intel Corporation, on Intel's own fleet and Intel's own SSD product
Guias relacionados: Um PC novo com SSD · Clonar ou transferir
Mais estatísticas (48)
Os parques de SSDs em data centers falham ou são substituídos a taxas que vão de cerca de um quinto de um por cento a pouco mais de um por cento ao ano, e quase nunca porque esgotaram as gravações nominais: em todos os estudos, as unidades usaram uma pequena parte da sua resistência antes de falhar ou ser aposentadas. As falhas se concentram no início em alguns parques e em outros não, e o modelo, o firmware e a capacidade de uma unidade pesam mais que a idade. Os dados de unidades de consumo são escassos: os notebooks da Intel, as unidades de boot da Backblaze e os registros de uma montadora de estações de trabalho.
Taxas de falha e de substituição de SSDs por parque
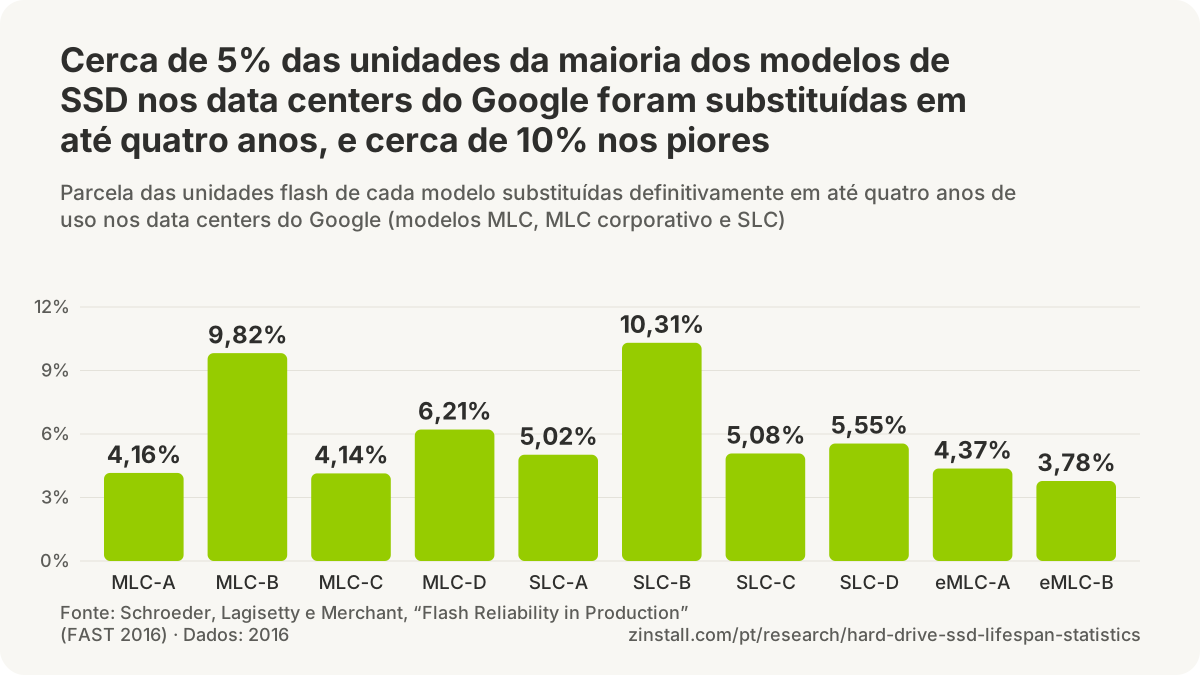
- Cerca de 5% das unidades da maioria dos modelos de unidade flash nos data centers do Google foram substituídas definitivamente em até quatro anos de uso, e cerca de 10% nos dois piores modelos (Schroeder et al., 2016).
- Cerca de 1% a 2,5% das unidades flash nos data centers do Google foram substituídas por ano, em média, distribuindo por igual os 4% a 10% substituídos em quatro anos (Schroeder et al., 2016; derivado).
- Alguns modelos dos SSDs dos data centers da Microsoft falharam em campo até 70% mais que a taxa de falha anualizada das especificações dos seus fabricantes (0,61% a 0,73%) (Narayanan et al., 2016).
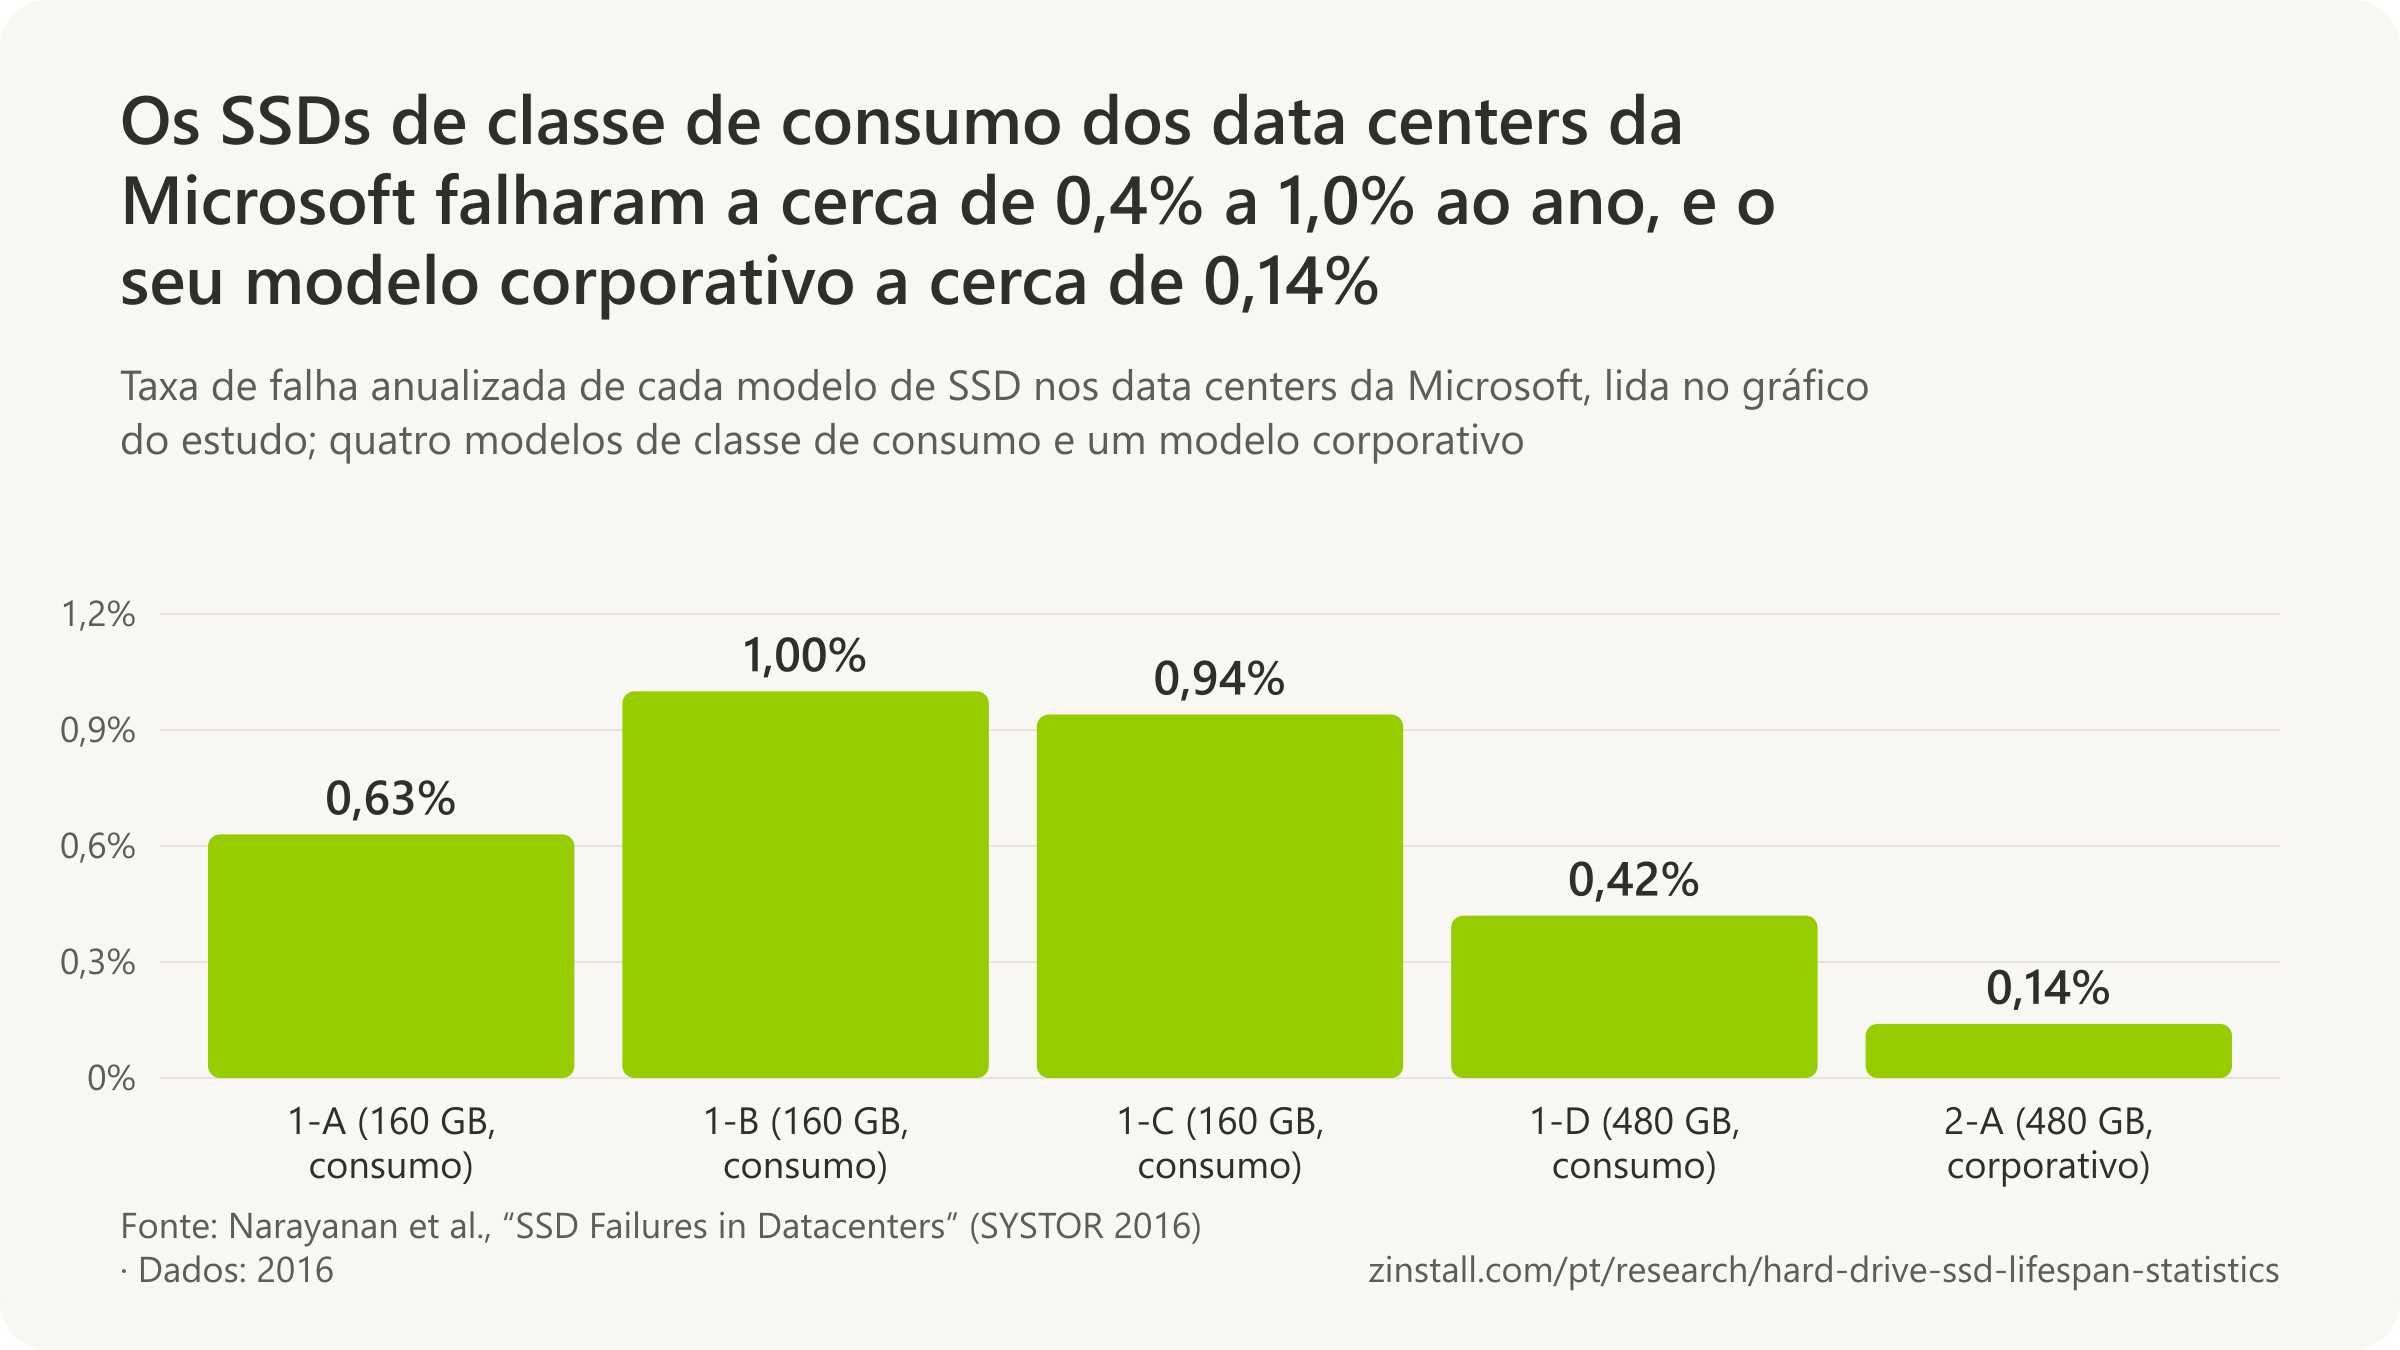
- Os SSDs dos data centers da Microsoft falharam a uma taxa anualizada de aproximadamente 0,4% a 1,0% em quatro modelos de classe de consumo e de aproximadamente 0,14% em um modelo de classe corporativa, conforme lido no gráfico do estudo (Narayanan et al., 2016).
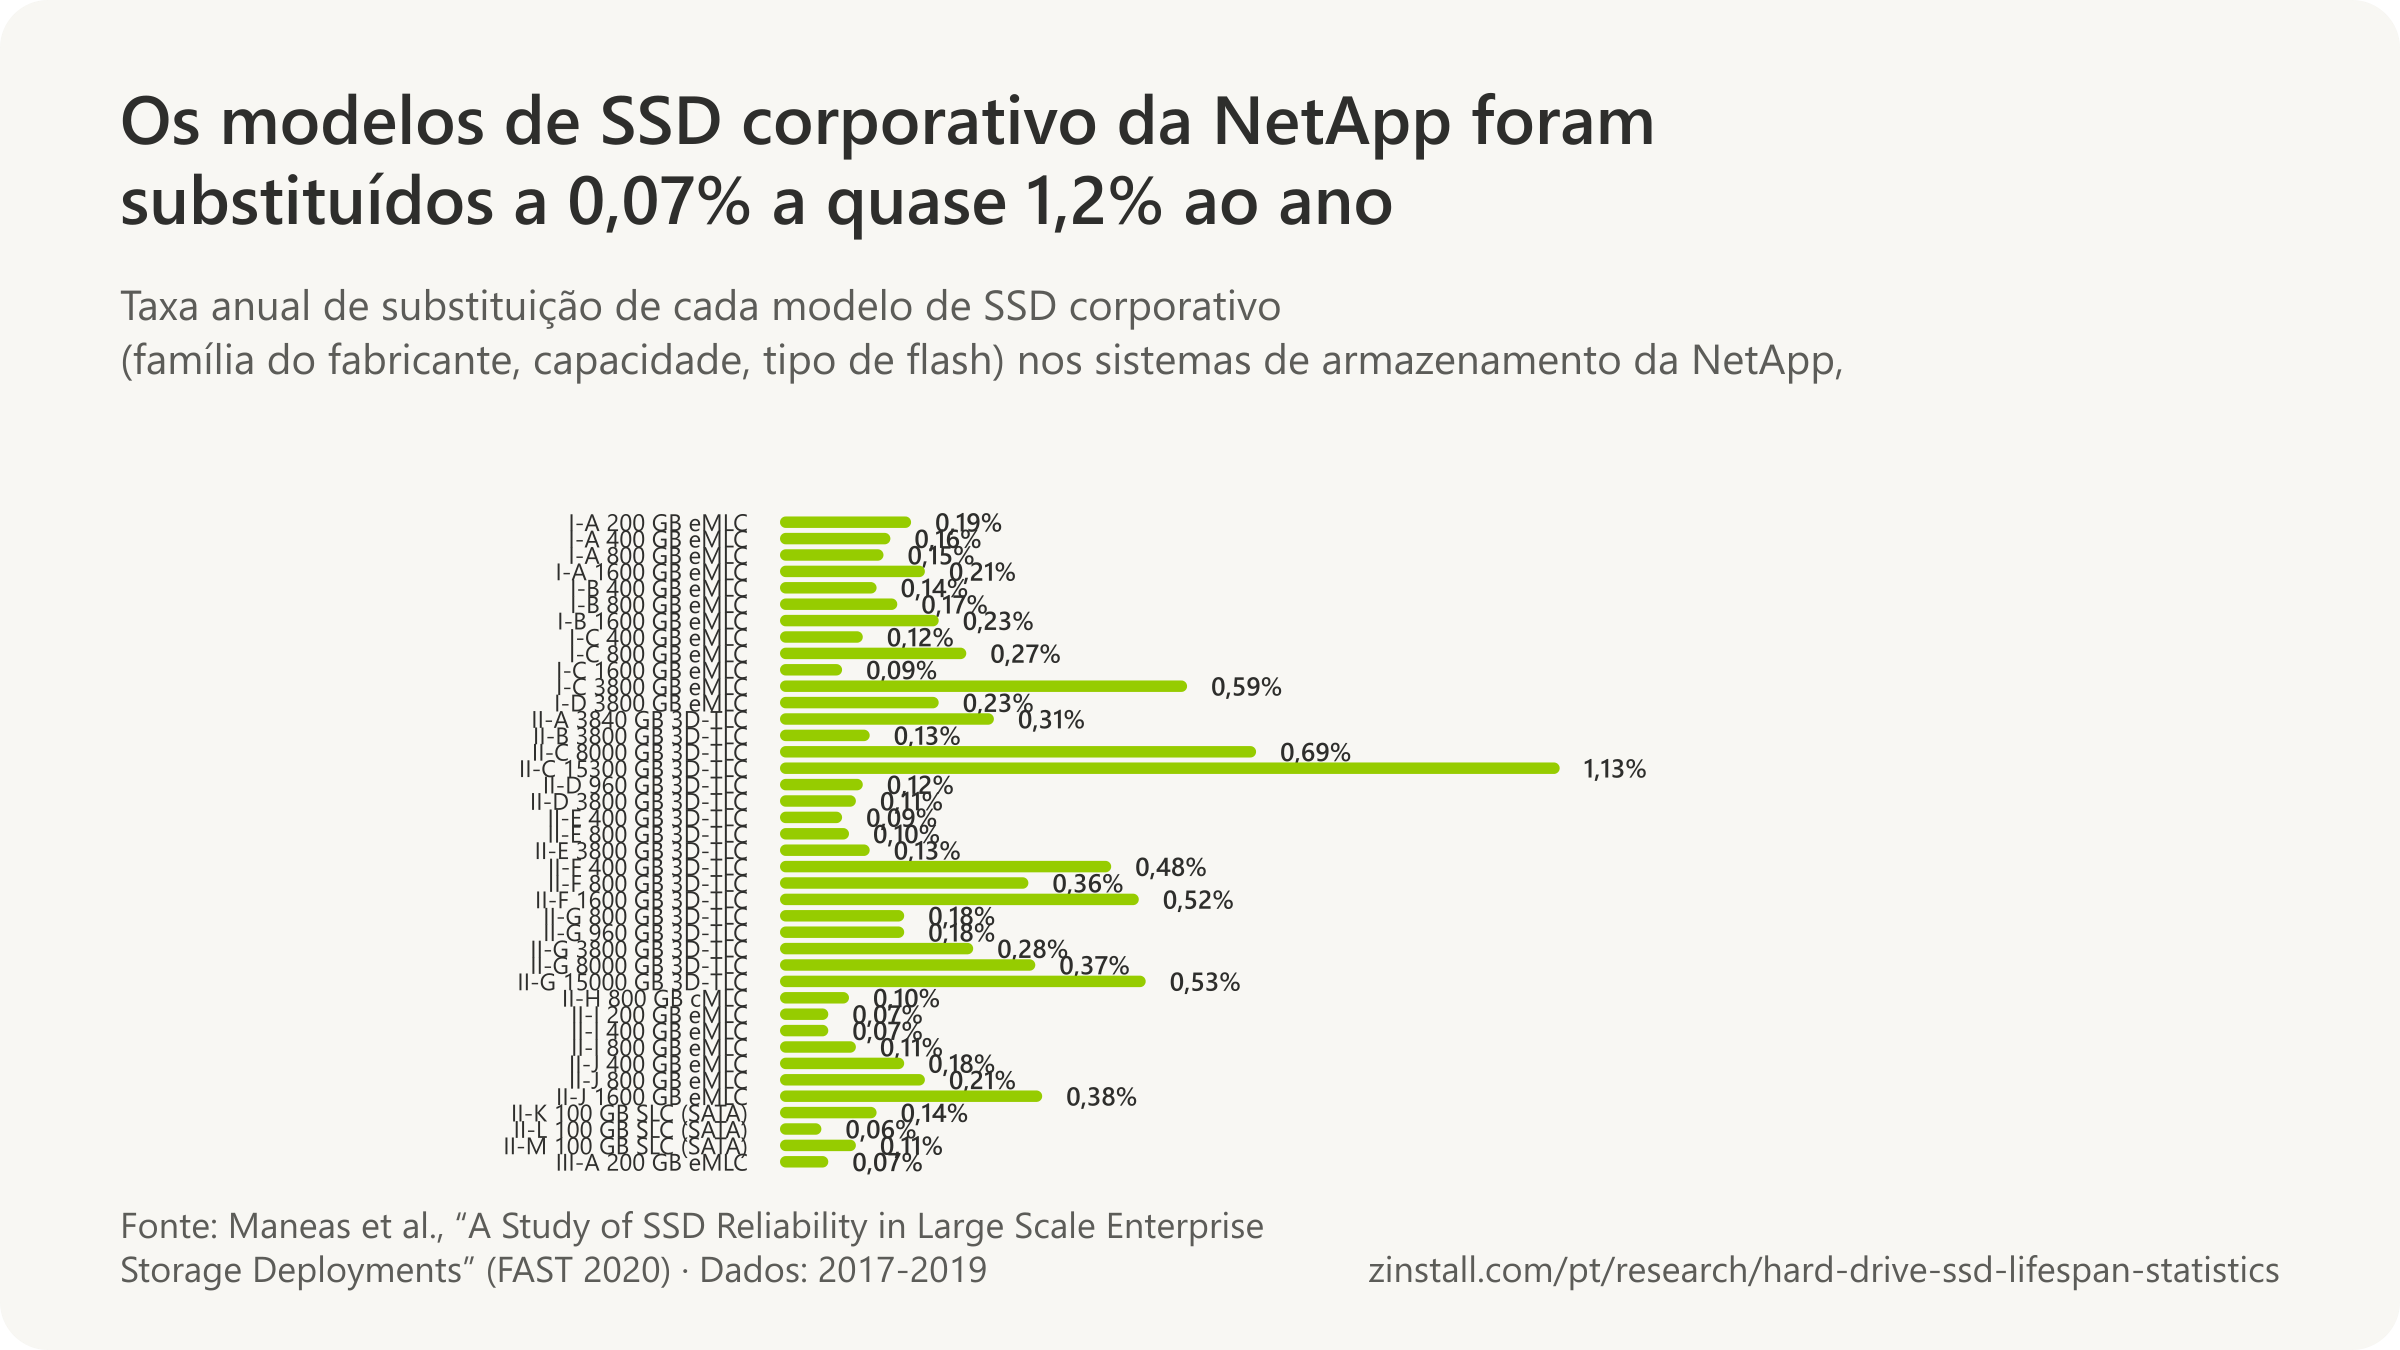
- Mesmo o pior modelo de SSD corporativo nos sistemas de armazenamento da NetApp foi substituído a 1,2% ao ano, na parte baixa da faixa de 1% a 2,5% relatada para os SSDs dos data centers do Google e abaixo dos 2% a 9% relatados para HDs (Maneas et al., 2020).
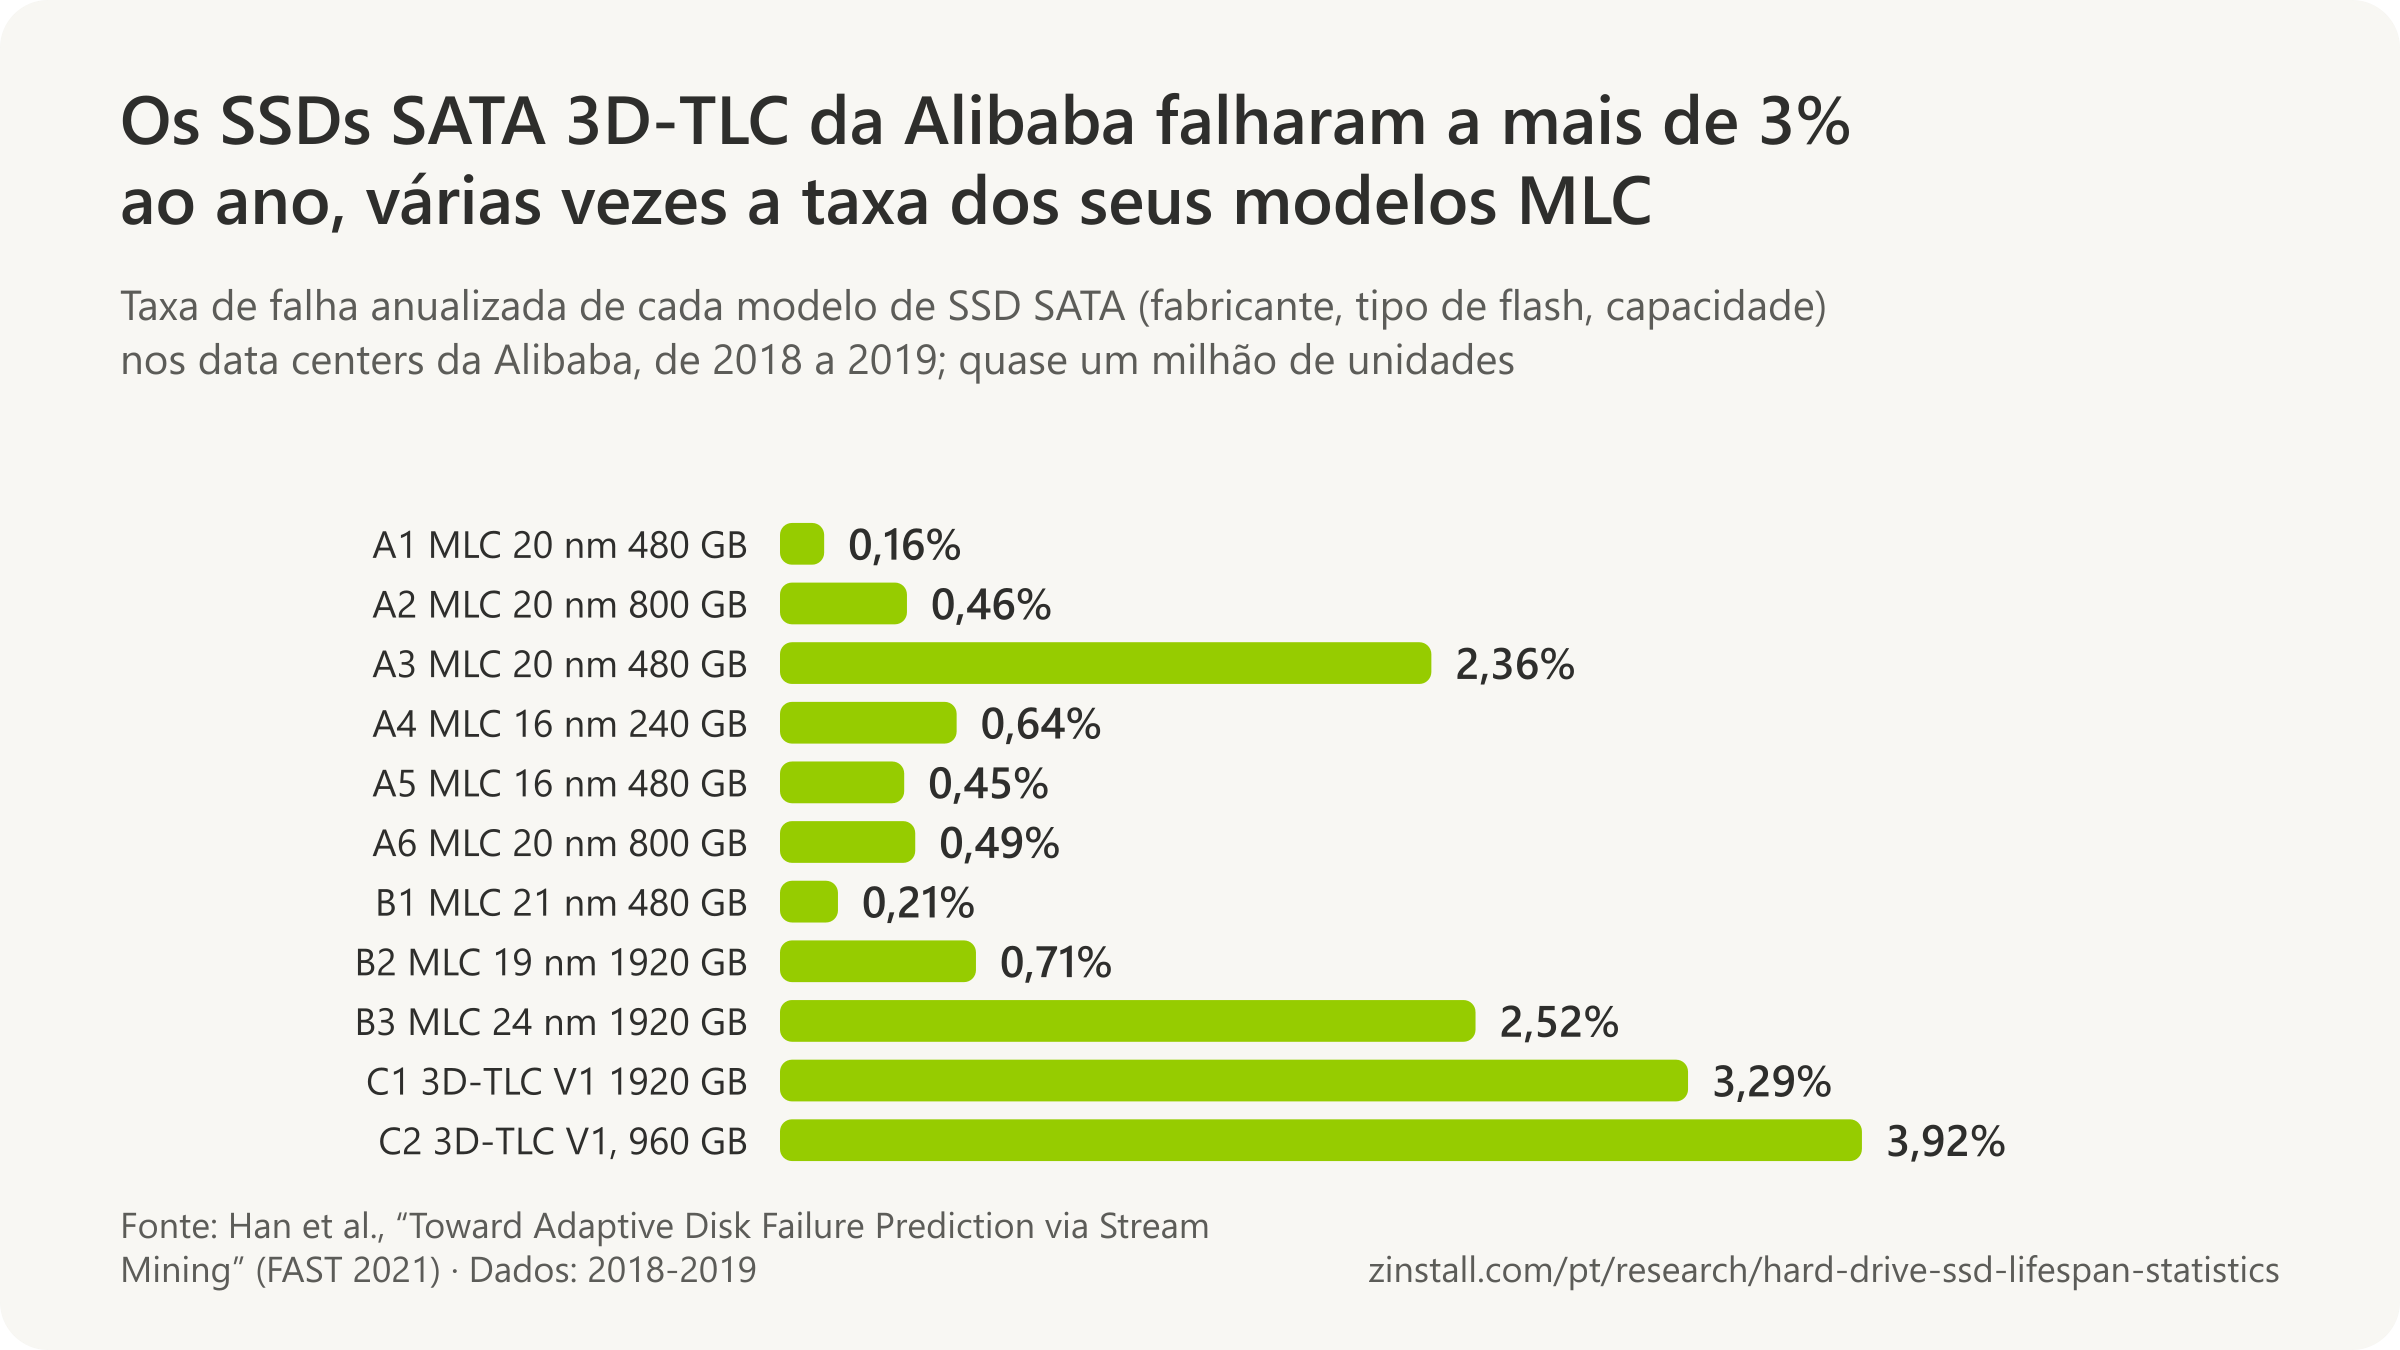
- 0,55% ao ano foi a taxa de falha geral dos SSDs MLC de classe corporativa dos data centers da Alibaba em 2018 e 2019, de 0,16% a 2,52% conforme o modelo, o que os autores chamaram de ligeiramente menor que os 1% a 2,5% relatados para os SSDs do Google (Han et al., 2021).
- Os dois modelos de SSD 3D-TLC de data center da Alibaba falharam a mais de 3% ao ano (3,29% e 3,92%) em 2018 e 2019, várias vezes os 0,55% dos seus SSDs MLC (Han et al., 2021).
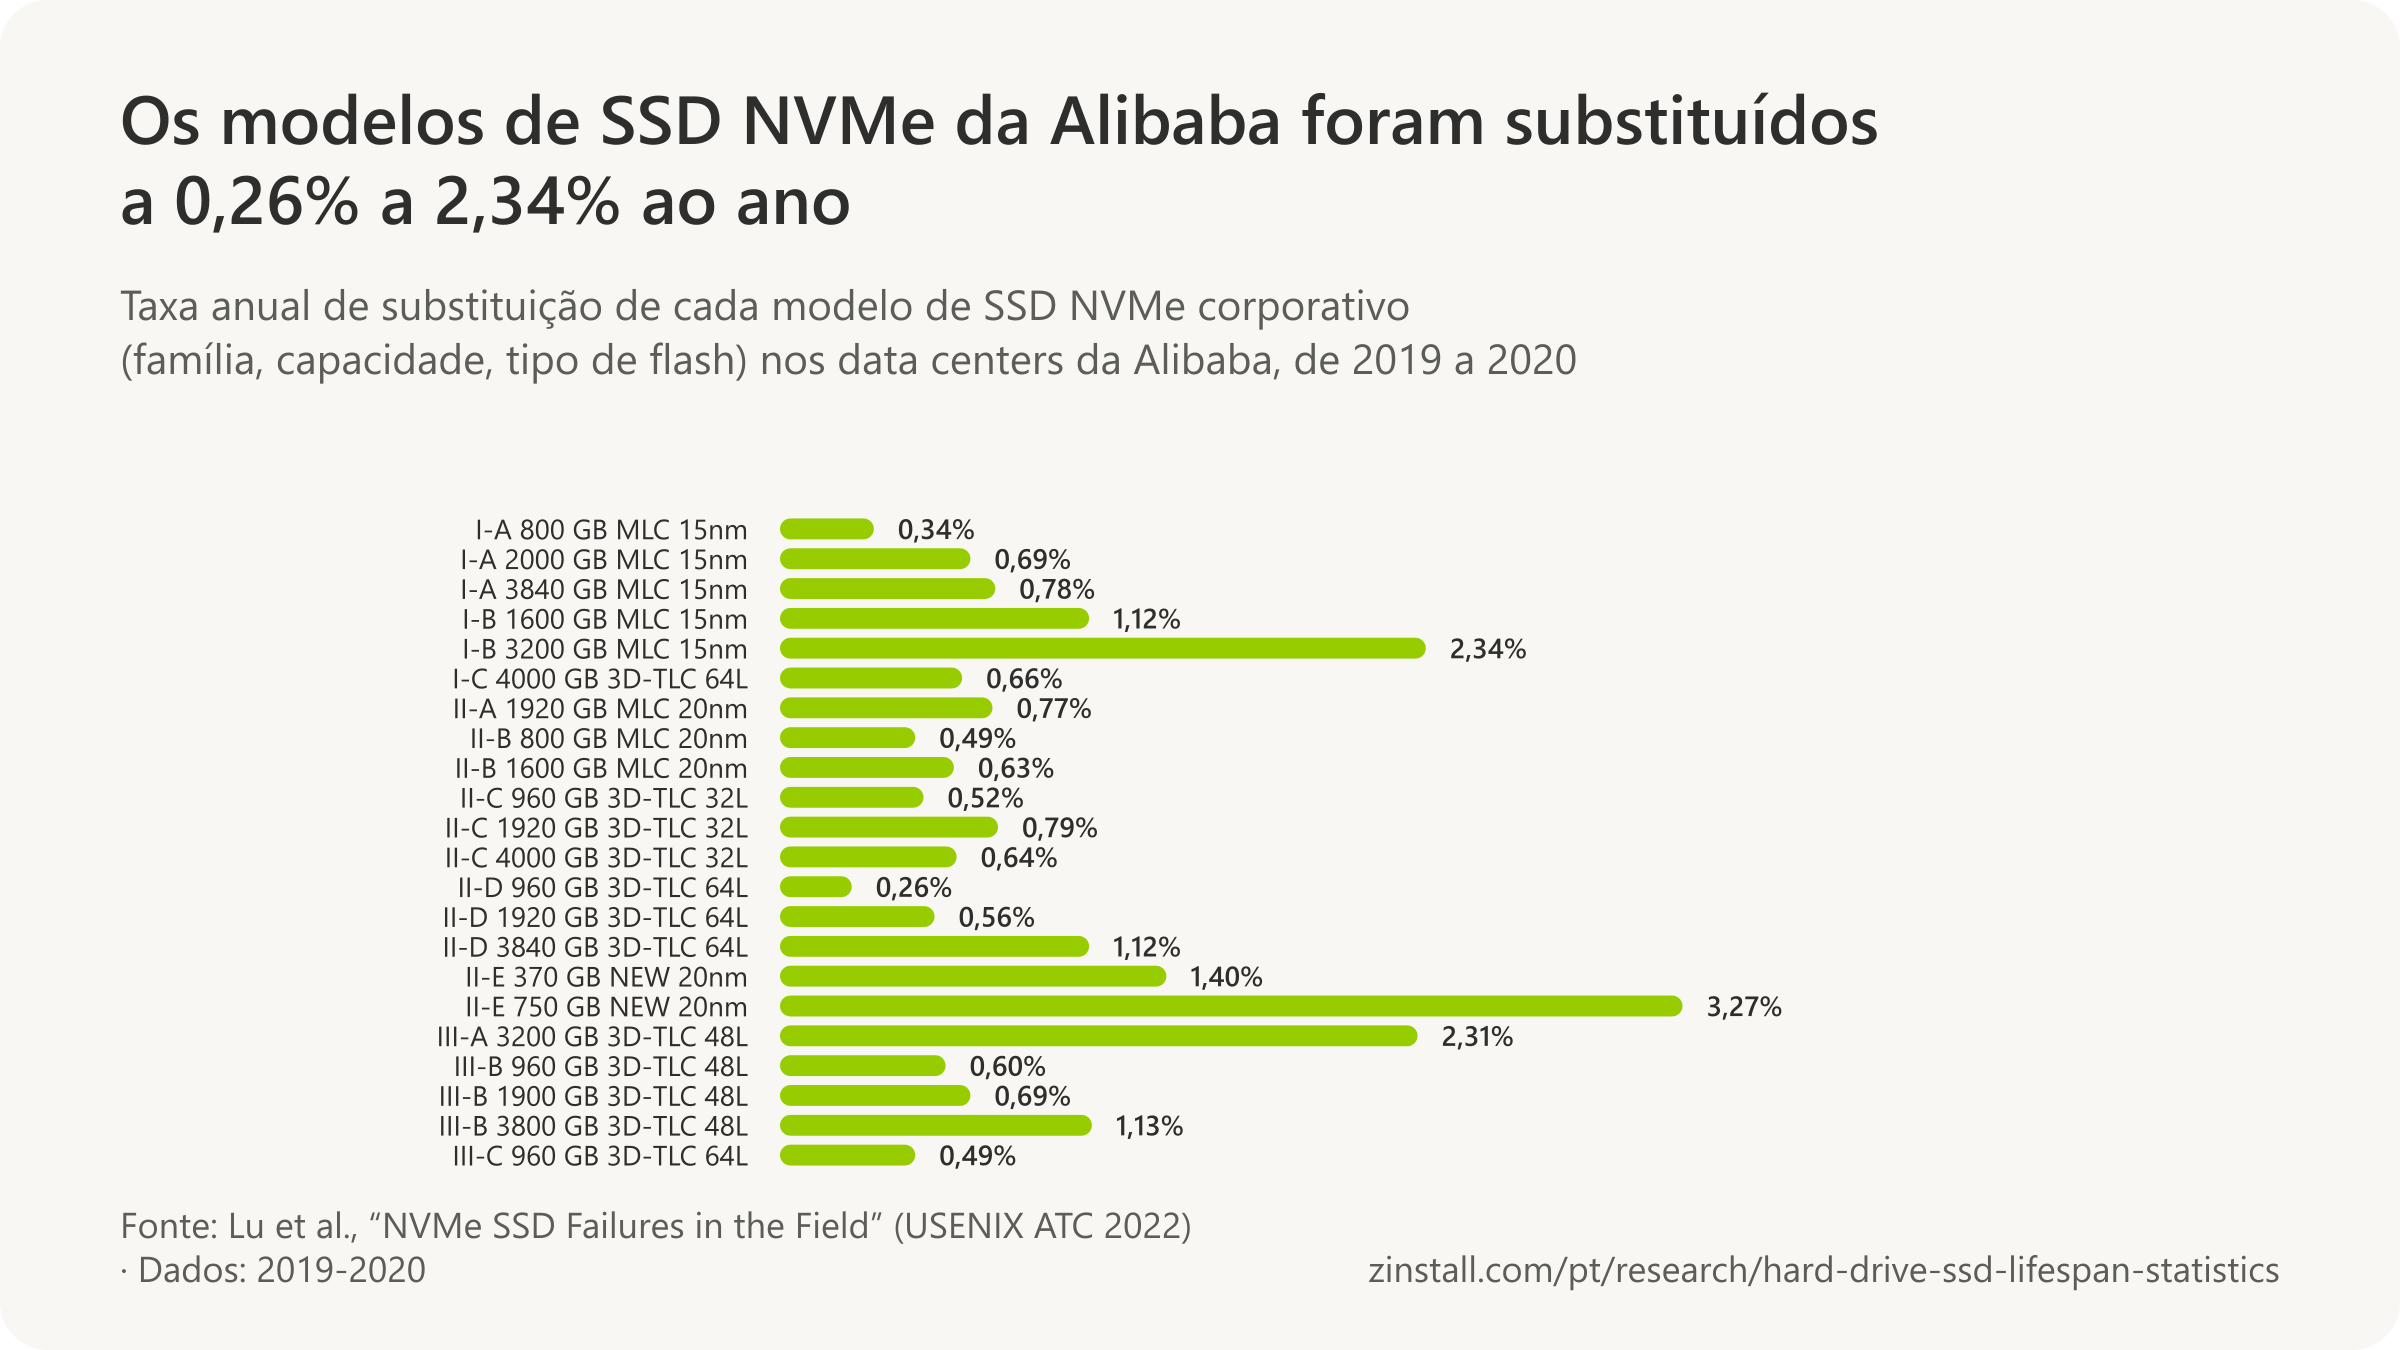
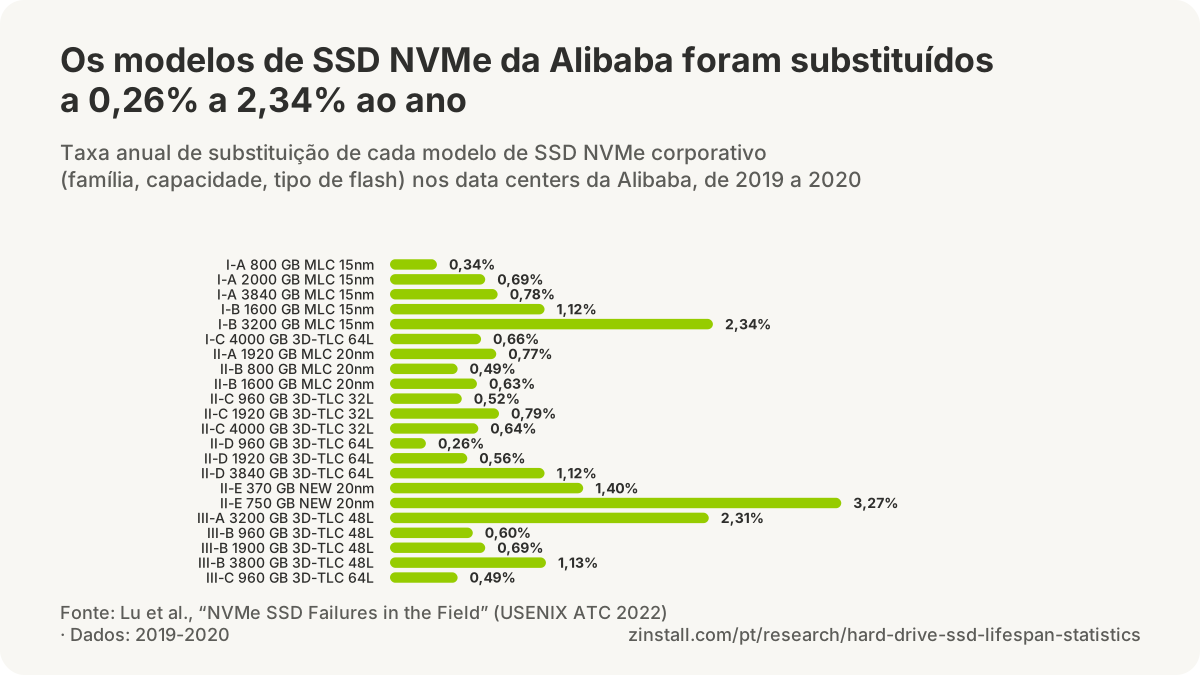
- Os SSDs NVMe MLC da Alibaba foram substituídos a 0,34% a 2,34% ao ano e os seus SSDs NVMe 3D-TLC a 0,26% a 2,31% em 2019-2020, de modo que o TLC se saiu um pouco melhor em média, o inverso do parque SATA e SAS da NetApp (Lu et al., 2022).
- De 6,95% a 14,3% das unidades flash MLC de três modelos num data center do Google falharam e foram trocadas pelo menos uma vez ao longo de seis anos, 11,29% no total (Alter et al., 2019).
- Menos de 0,2% ao ano dos mais de 300.000 SSDs NVMe corporativos Samsung PM1733 e PM9A3 da nuvem da Tencent tiveram uma falha registrada, por uma contagem aproximada de 409 registros de falha em nove meses (Zhang et al., 2023; derivado).
Por modelo, tipo de flash e capacidade





- As unidades flash SLC de classe corporativa do Google não foram reparadas nem substituídas com menos frequência que as suas unidades MLC, mais baratas, e normalmente não tiveram menos erros que chegassem ao usuário (Schroeder et al., 2016).
- Os SSDs corporativos 3D-TLC nos sistemas de armazenamento da NetApp foram substituídos com frequência cerca de 1,5 vez maior que os SSDs MLC corporativos com uso semelhante, e tinham consumido de 10 a 15 vezes mais dos seus blocos de reserva (Maneas et al., 2020).
- Os SSDs MLC corporativos de 1x nm, mais densos, nos sistemas de armazenamento da NetApp foram substituídos com frequência quase duas vezes maior que as unidades de 2x nm, enquanto no 3D-TLC a geração V2, mais antiga e de menor densidade, se saiu pior que a V3 (Maneas et al., 2020).
- Os SSDs de 15 TB nos sistemas de armazenamento da NetApp sempre foram substituídos com mais frequência que as unidades menores da mesma família, e as suas falhas foram mais vezes repentinas e graves (Maneas et al., 2020).
- Dois modelos de SSD corporativo 3D-TLC de 15 TB do mesmo fabricante tiveram taxas anuais de substituição de 0,53% e 1,13% nos sistemas de armazenamento da NetApp, de modo que especificações quase idênticas não significaram confiabilidade igual (Maneas et al., 2020).
- Os SSDs corporativos nos sistemas de armazenamento da NetApp que rodavam o primeiro firmware de um modelo podiam ser substituídos com frequência até dez vezes maior que o mesmo modelo com firmware posterior, e mesmo assim 70% das unidades ficaram numa única versão de firmware o tempo todo (Maneas et al., 2020).
- Num modelo de SSD NVMe da Alibaba, a chance mensal de falha foi de 0,02% nos três primeiros meses de serviço, de 0,05% do 4º ao 12º mês e de 0,35% nos três meses mais recentes (Lu et al., 2022).
- SSDs NVMe maiores da mesma família foram substituídos com mais frequência na Alibaba: numa família, a taxa anual subiu de 0,26% nas unidades de 960 GB para 1,12% nas de 3,84 TB (Lu et al., 2022).
Quando os SSDs falham
- As unidades flash dos data centers do Google não mostraram mortalidade infantil significativa em erros incorrigíveis, ao contrário do parque do Facebook, talvez porque as duas empresas fazem o burn-in das unidades novas de formas diferentes (Schroeder et al., 2016).
- As taxas de falha dos SSDs de servidor do Facebook não subiram de forma constante com o desgaste: elas subiram, caíram e voltaram a subir à medida que mais dados eram gravados (detecção precoce, falha precoce, vida útil e desgaste), ao contrário da clássica curva da banheira (Meza et al., 2015).
- A alta de falhas no início da vida dos SSDs de servidor do Facebook terminou depois que cerca de 3 TB a 10 TB tinham sido gravados: 3 TB nas unidades de 720 GB e de 1,2 TB, 10 TB nas unidades de 3,2 TB (Meza et al., 2015).
- Os SSDs corporativos nos sistemas de armazenamento da NetApp mostraram taxas de falha crescentes nos seus primeiros 12 a 15 meses, seguidos de 6 a 12 meses de taxas em lenta queda antes de se estabilizarem, de modo que a mortalidade infantil ocupou de 20% a 40% de uma vida típica de cinco anos (Maneas et al., 2020).
- Durante a mortalidade infantil, os SSDs corporativos nos sistemas de armazenamento da NetApp falharam a uma taxa 2 a 3 vezes maior que a que mostraram mais tarde na vida, e nenhuma alta de falhas apareceu perto do fim da vida (Maneas et al., 2020).
- Os SSDs NVMe corporativos da Alibaba não mostraram mortalidade infantil notável: em quase todos os modelos, a taxa de falha nos três primeiros meses de serviço foi igual ou menor que depois (Lu et al., 2022).
- 15% das falhas de SSD num data center do Google ocorreram nos primeiros 30 dias das unidades e 25% nos primeiros 90 dias; depois dessa infância, a taxa de falha ficou mais ou menos estável ao longo de seis anos (Alter et al., 2019).
- Passados os primeiros 90 dias, os SSDs MLC mais antigos de um data center do Google falharam mais ou menos com a mesma frequência que os mais novos ao longo de seis anos, então a idade sozinha não os tornou mais propensos a falhar (Alter et al., 2019).
As unidades de boot SSD da Backblaze

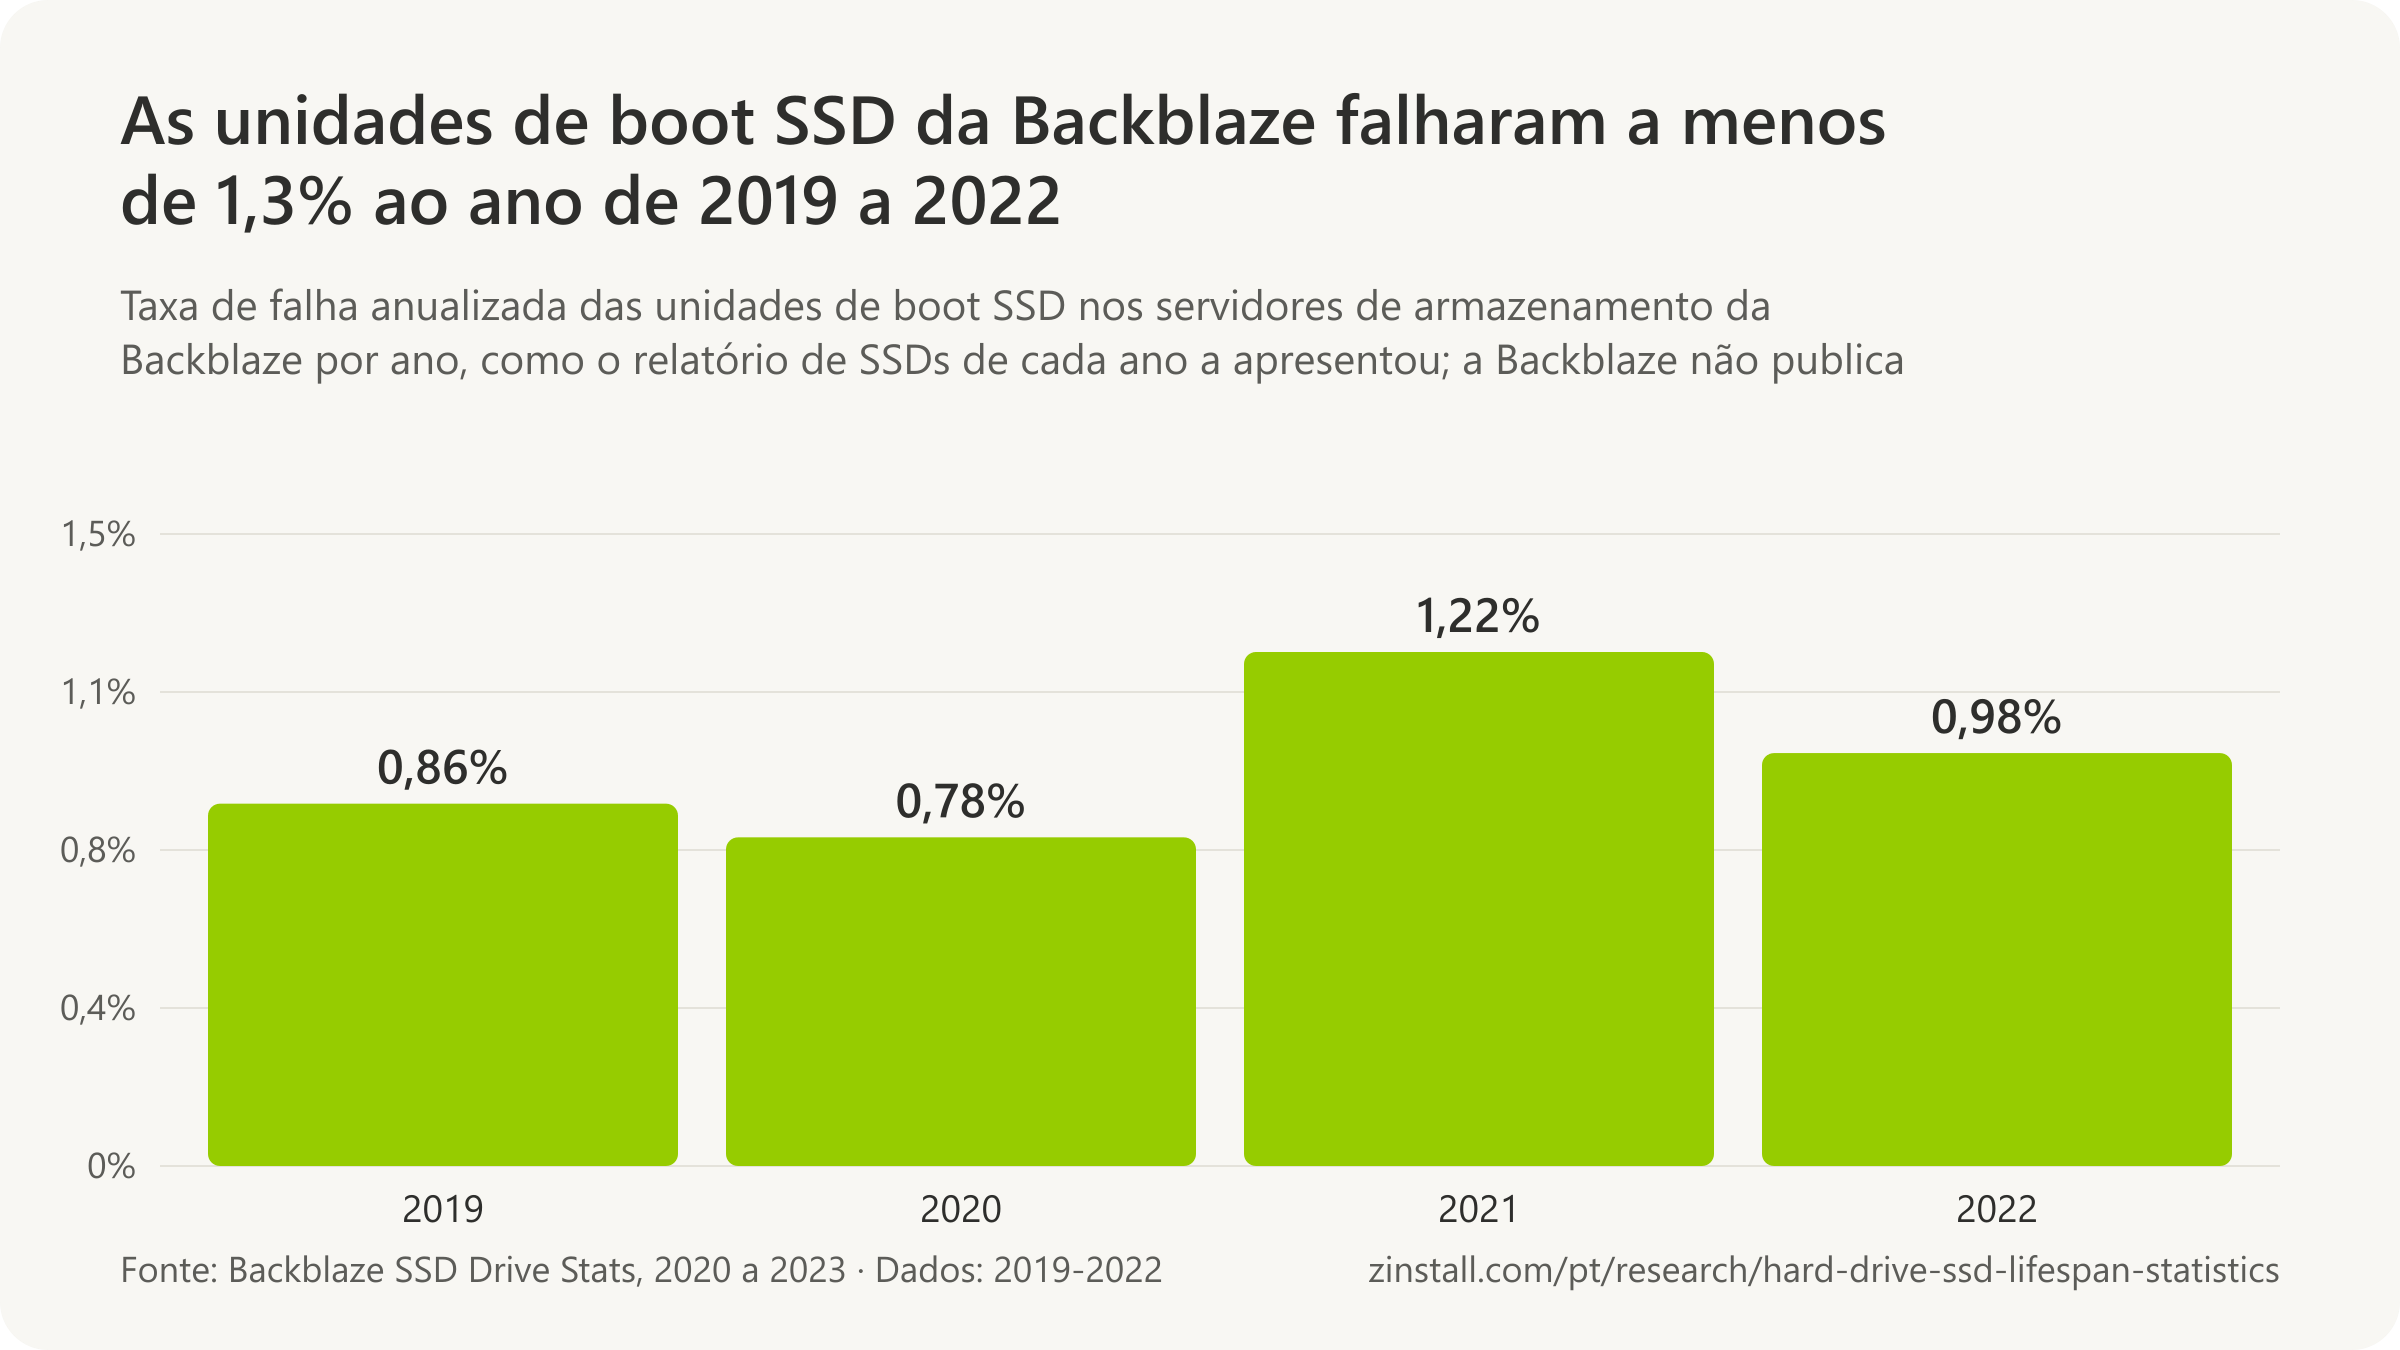
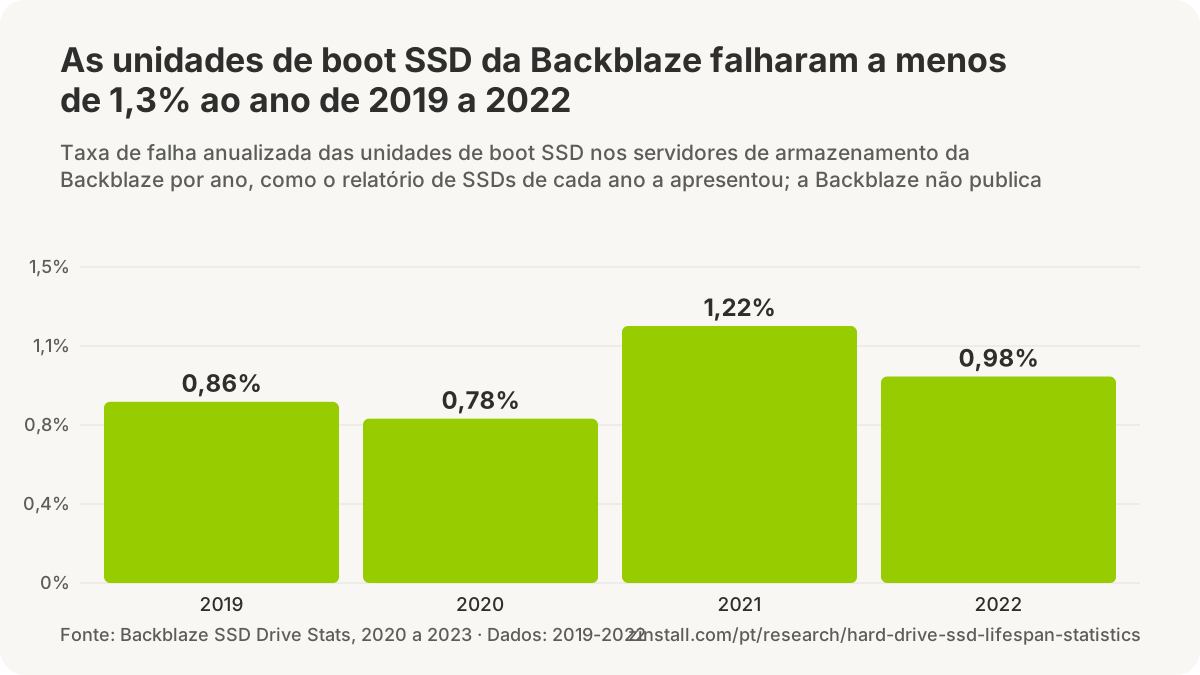
- 0,39% é a taxa de falha anualizada de 2020 das unidades de boot SSD da Backblaze conforme reproduzida no seu relatório de SSDs de 2022, contra 0,78% no seu relatório de SSDs de 2021 (Backblaze, 2023).
- 1,05% é a taxa de falha anualizada de 2021 das unidades de boot SSD da Backblaze conforme reproduzida no seu relatório de SSDs de 2022, contra 1,22% no seu relatório de SSDs de 2021 (Backblaze, 2023).
- 1,07% é a taxa de falha anualizada de todo o tempo de serviço (falhas por unidade-ano) das unidades de boot SSD da Backblaze em 31 de dezembro de 2021, em 2.200 SSDs (Backblaze, 2022).
- 0,92% é a taxa de falha anualizada de todo o tempo de serviço (falhas por unidade-ano) das unidades de boot SSD da Backblaze em 30 de junho de 2022, em 2.558 SSDs (Backblaze, 2022).
- 0,89% é a taxa de falha anualizada de todo o tempo de serviço (falhas por unidade-ano) das unidades de boot SSD da Backblaze em 31 de dezembro de 2022, em 2.906 SSDs (Backblaze, 2023).
- 1,05% das unidades de boot SSD da Backblaze falharam, em base anualizada, no 2º trimestre de 2023, depois de 0,96% no 1º trimestre de 2023, dentro de uma faixa trimestral de 0,36% a 1,72% em três anos (Backblaze, 2023).
- 14 meses era a idade média das 63 unidades de boot SSD que tinham falhado nos data centers da Backblaze até meados de 2023, quando o parque de SSDs tinha idade média de 25 meses (Backblaze, 2023).
Estações de trabalho e notebooks
- 0,74% de todos os SSDs que a Puget Systems vendeu nas suas estações de trabalho falharam, a média combinada de todos os modelos de SSD que ela já ofereceu, pelos registros da própria montadora (Puget Systems, 2026).
- 0,22% dos SSDs NVMe Kingston KC3000 nas estações de trabalho da Puget Systems falharam em 2025, contra 0,08% em 2024, pelos registros da própria montadora (Puget Systems, 2026).
- Nenhum dos SSDs SATA Samsung 870 QVO de 8TB que a Puget Systems vendeu falhou em 2025, pelos registros da própria montadora (Puget Systems, 2026).
- 0,19% dos SSDs SATA Samsung 870 QVO de 8TB que a Puget Systems vendeu falharam em todos os anos em que ela ofereceu o modelo, pelos registros da própria montadora (Puget Systems, 2026).
- 1,6% das unidades de armazenamento (NVMe, SSD SATA e HDs) nas estações de trabalho da Puget Systems falharam em 2024, em média, pelos registros da própria montadora (Puget Systems, 2025).
- 1% das unidades de armazenamento que a Puget Systems vendeu em 2024 falharam depois de chegar ao cliente, dois terços de todas as falhas de unidade da empresa naquele ano, pelos registros da própria montadora (Puget Systems, 2025).
- 0,08% dos SSDs NVMe Kingston KC3000 nas estações de trabalho da Puget Systems falharam em 2024 (cerca de 1 em 1.250, entre muitos milhares vendidos), pelos registros da própria montadora (Puget Systems, 2025).
- Nenhum dos mais de 1.000 SSDs SATA Samsung 870 EVO e QVO que a Puget Systems vendeu no período coberto pela sua análise de 2021 falhou, nem na oficina nem em campo, pelos registros da própria montadora (Puget Systems, 2021).
- 0,18% das unidades de armazenamento que a Puget Systems vendeu em 2018 falharam (cerca de 1 em 570), e 0,05% falharam depois da entrega ao cliente, pelos registros da própria montadora (Puget Systems, 2019).
- 0,11% dos SSDs SATA Samsung 850 e 860 que a Puget Systems vendeu em 2018 falharam (cerca de 1 em 874), e nenhum falhou depois da entrega, pelos registros da própria montadora (Puget Systems, 2019).
- 0,08% dos SSDs NVMe Samsung 960 e 970 que a Puget Systems vendeu em 2018 falharam (cerca de 1 em 1.250), pelos registros da própria montadora (Puget Systems, 2019).
- 0,26% dos SSDs Samsung 850 EVO que a Puget Systems vendeu em 2016 falharam, enquanto os seus SSDs Samsung 850 Pro e 950 Pro não tiveram nenhuma falha, pelos registros da própria montadora (Puget Systems, 2016).
- 0,06% dos SSDs SATA Samsung 850 EVO que a Puget Systems vendeu em 2015 falharam (uma única unidade), pelos registros da própria montadora (Puget Systems, 2015).
- 0,1% dos SSDs Samsung 840 Pro e 840 EVO que a Puget Systems vendeu em 2014 falharam (uma unidade em cada linha), e nenhum dos seus SSDs 850 Pro falhou, pelos registros da própria montadora (Puget Systems, 2014).
- Apenas um dos modelos de SSD Samsung que a Puget Systems vendeu em 2013 teve alguma falha (2 unidades, 0,7%), e três modelos não tiveram nenhuma, pelos registros da própria montadora (Puget Systems, 2013).
Fontes: USENIX, Proceedings of the 14th USENIX Conference on File and Storage Technologies; ACM, Proceedings of the 9th ACM International Systems and Storage Conference; USENIX, Proceedings of the 18th USENIX Conference on File and Storage Technologies; USENIX, Proceedings of the 19th USENIX Conference on File and Storage Technologies; USENIX, Proceedings of the 2022 USENIX Annual Technical Conference; ACM / IEEE, Proceedings of the International Conference; USENIX, Proceedings of the 21st USENIX Conference on File and Storage Technologies; ACM, Proceedings of the 2015 ACM SIGMETRICS International Conference on Measurement and Modeling of Computer Systems; Backblaze (2022, 2023); Puget Systems (2013-2026)
Vida útil de SSD vs HD: qual dura mais?
As unidades de boot SSD falharam a 0,92% ao ano no quinto ano, contra 3,55% dos HDs da mesma idade (Backblaze, 2022).

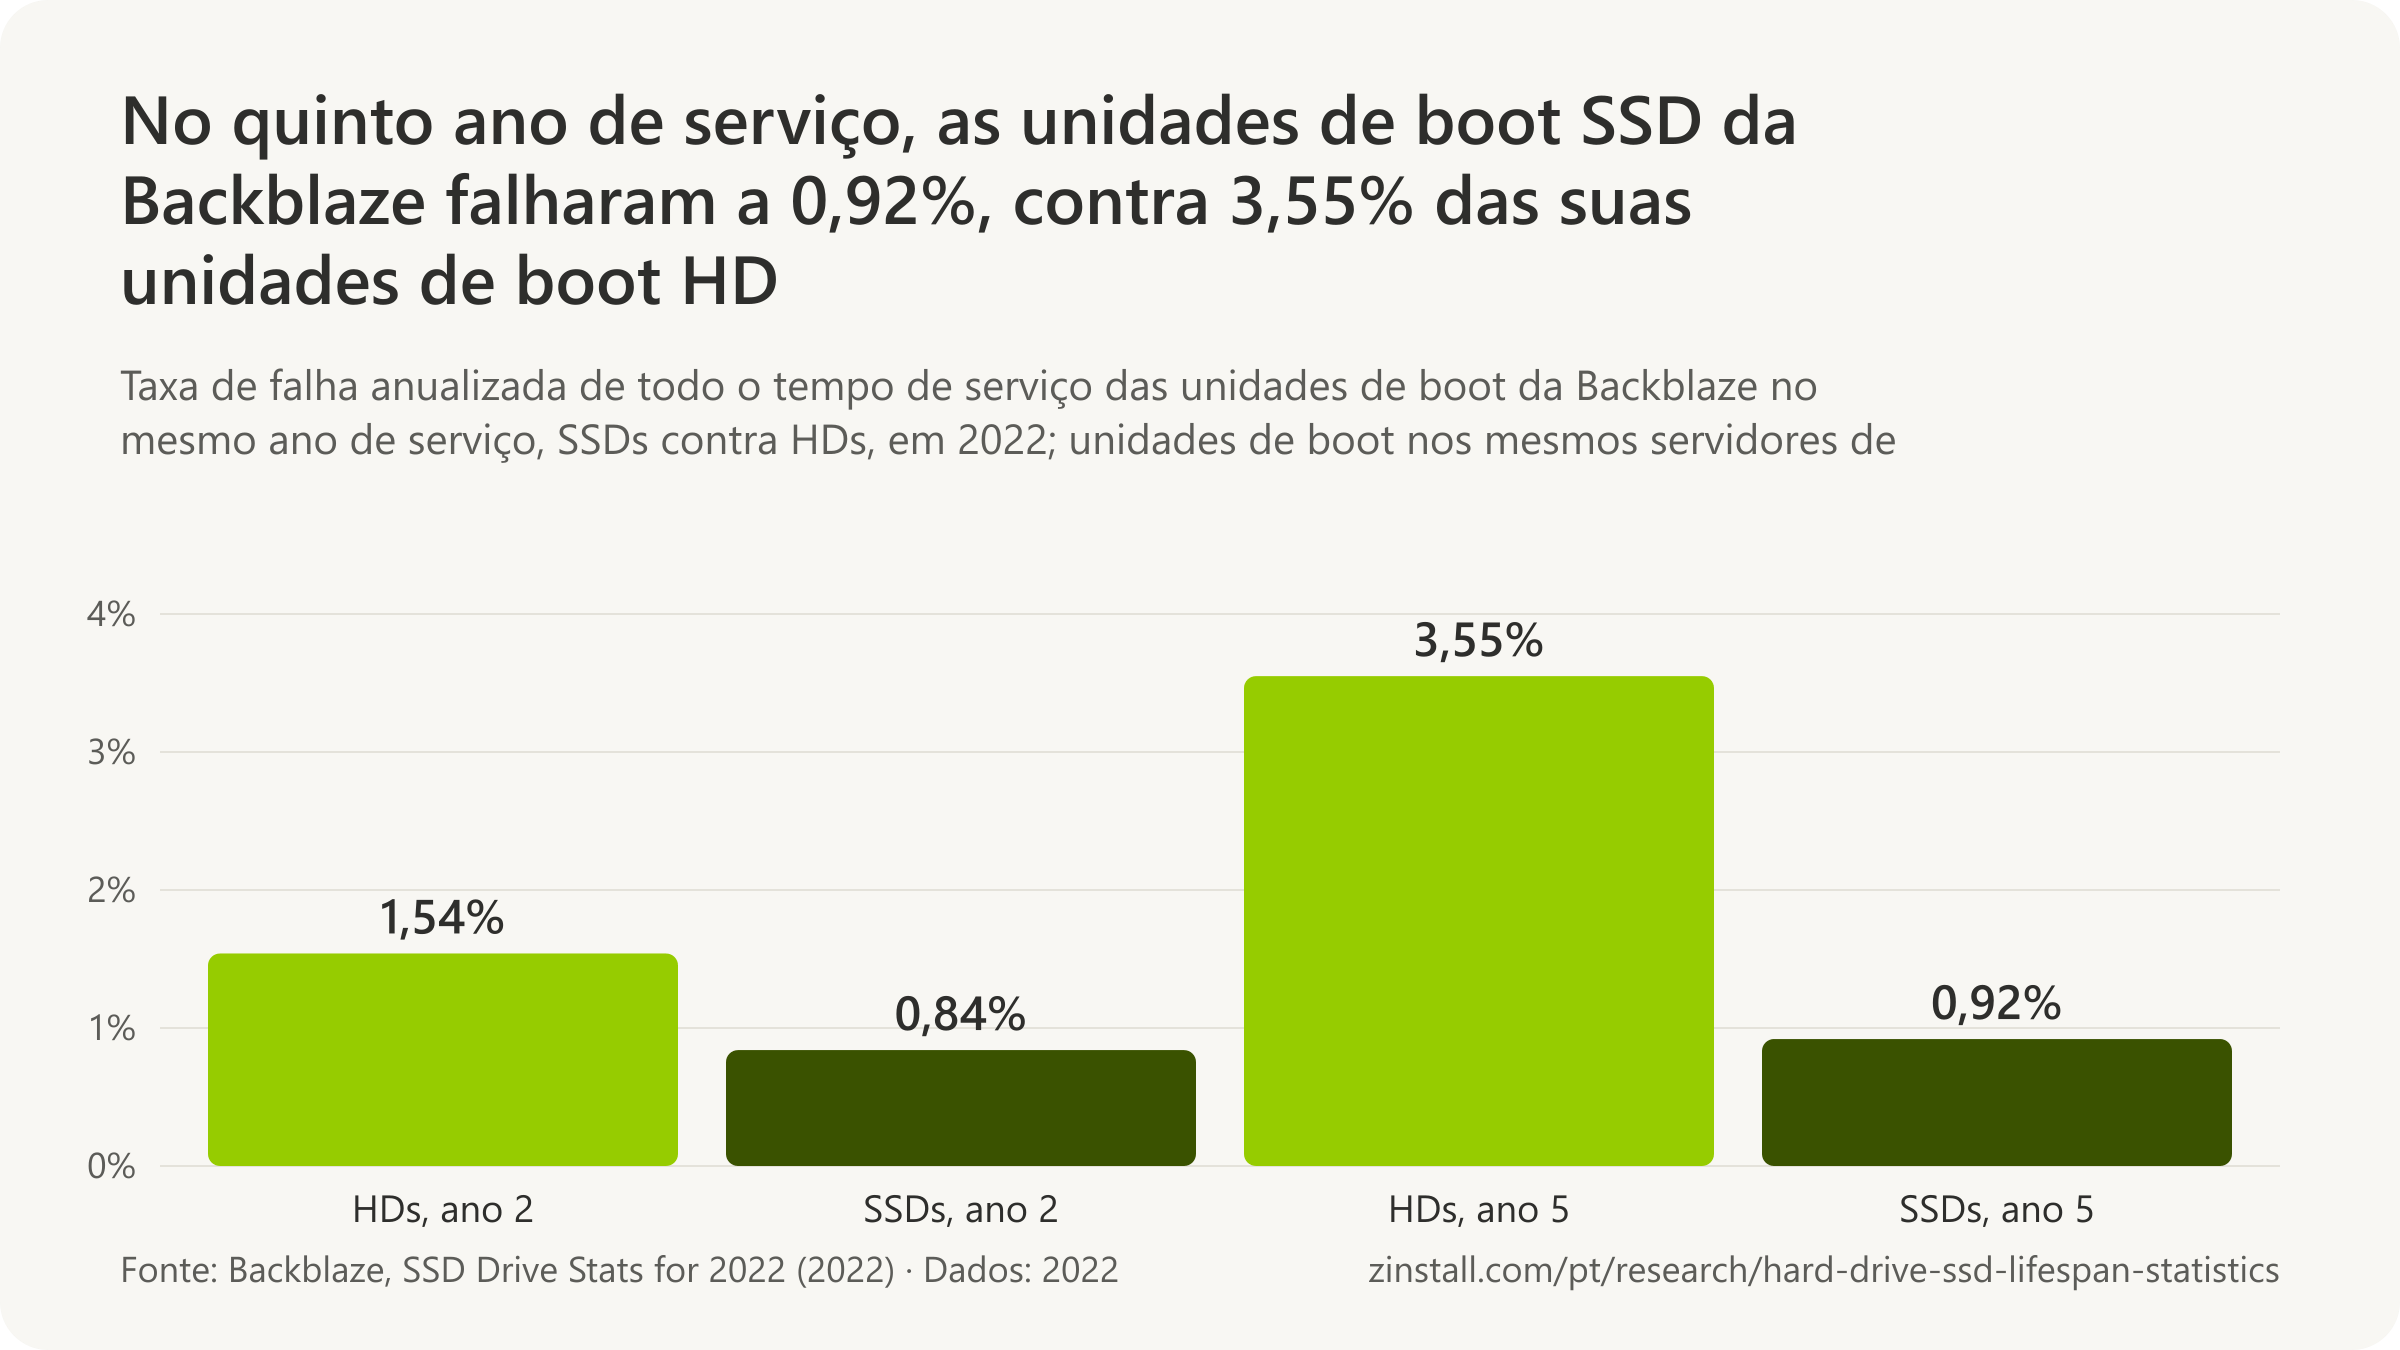
- Os SSDs dos notebooks da Intel falharam a 0,61% ao ano, contra 4,85% dos HDs de notebook que ela usava antes.
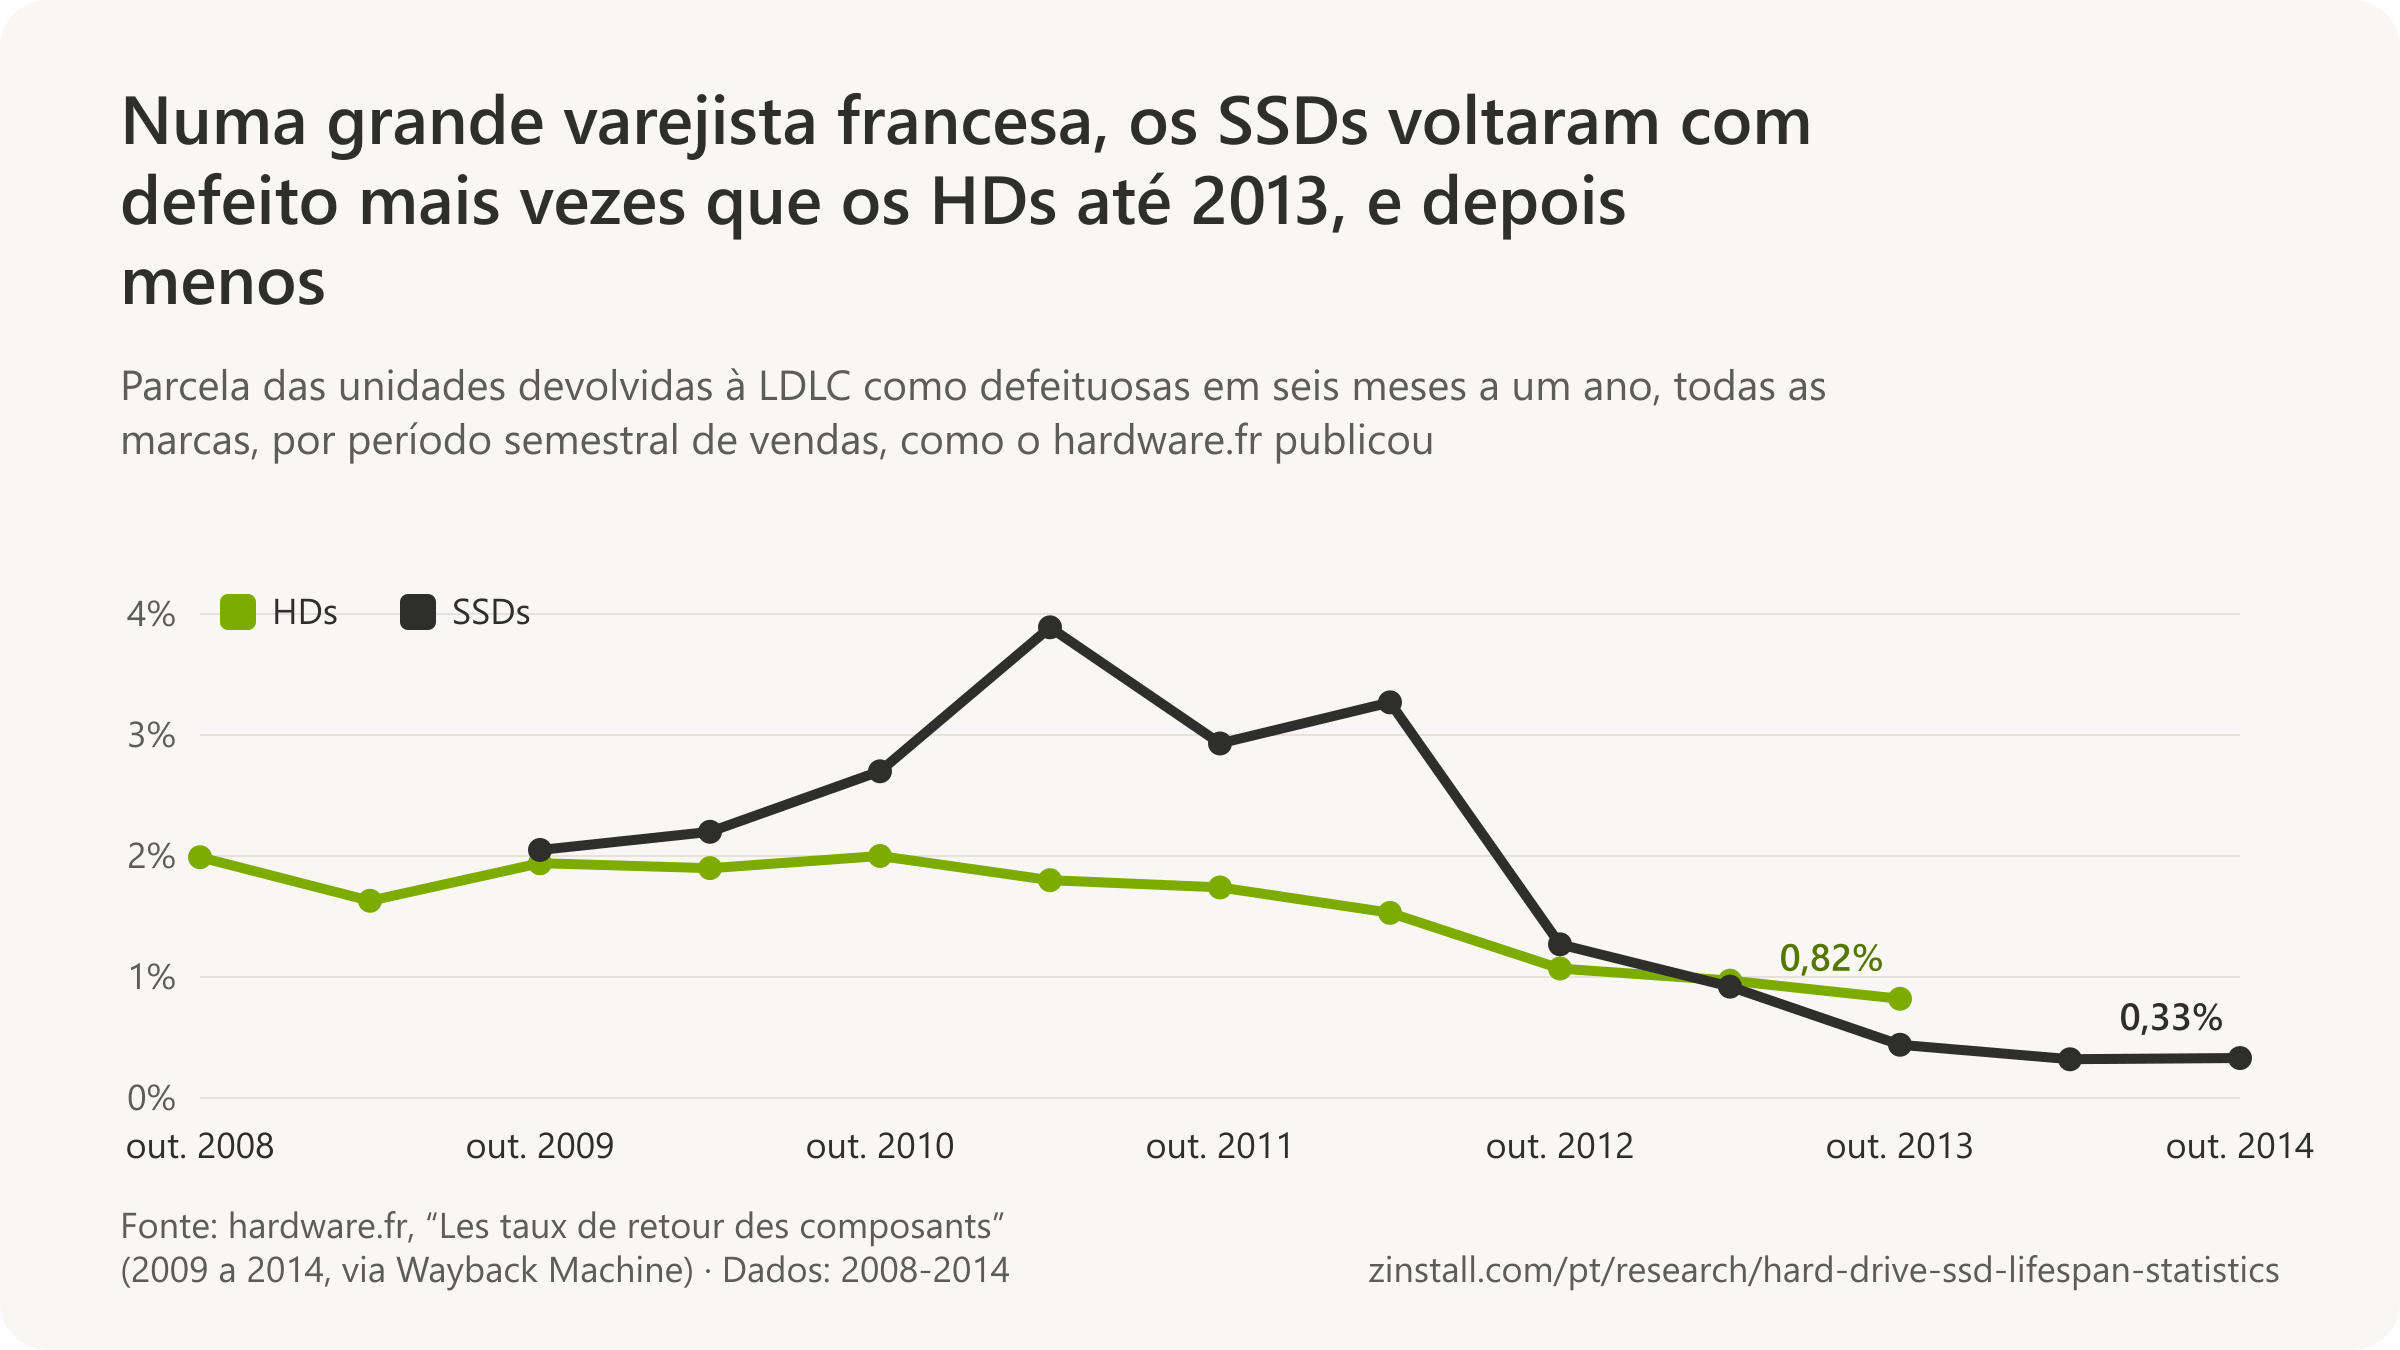
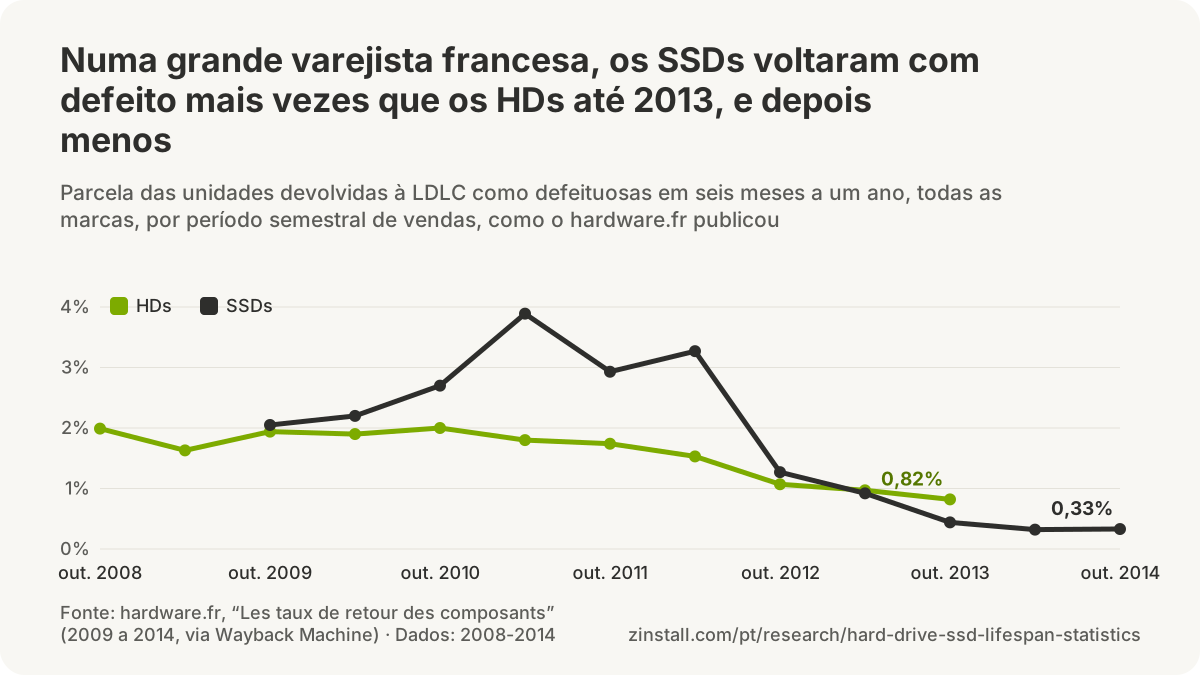
- Numa varejista francesa, 3,89% dos SSDs vendidos em 2011 voltaram com defeito, contra 1,80% dos HDs.
- 0,18% dos SSDs SATA Samsung de uma montadora falharam de 2013 a 2016, contra 1,41% dos seus HDs WD.
- 79% dos chamados de falha de SSD nos data centers da Microsoft terminaram com uma unidade nova, contra 11% nos HDs.
- 1,41% dos SSDs NVMe da Alibaba ficaram lentos em quatro meses, contra 0,20% dos seus HDs.
| Fonte, medida e data | Número |
|---|---|
| Unidades de boot da Backblaze com cerca de 12 meses: HDs | 1,54% |
| Unidades de boot SSD da Backblaze aos 14 meses | 1,05% |
| Unidades de boot HD da Backblaze aos 14 meses | 1,38% |
| Varejista francesa: SSDs devolvidos, vendas do fim de 2012 ao início de 2013 | 1,27% |
| Varejista francesa: HDs devolvidos, mesmas vendas | 1,07% |
| Puget Systems: SSDs SATA Samsung que falharam, 2018 | 0,11% |
| Puget Systems: HDs que falharam, 2018 | 0,34% |
| Alibaba: parcela dos SSDs nos chamados de falha de hardware | 5,6% contra 22,1% (HD) |
| SSDs do Google contra HDs da Backblaze ao longo de seis anos (parques diferentes) | 11,3% (SSD) contra 7,0% (HD) |
| Microsoft: custo por GB dos SSDs comparado ao dos HDs, 2016 | 4 a 40 vezes |
Fontes: Backblaze (2022, 2021a, 2021b); Intel Corporation, on Intel's own fleet and Intel's own SSD product; Hardware.fr (2013, 2012); Puget Systems (2019, 2016); ACM, Proceedings of the 9th ACM International Systems and Storage Conference; USENIX, Proceedings of the 2022 USENIX Annual Technical Conference; USENIX, Proceedings of the 2019 USENIX Annual Technical Conference; IEEE, Transactions on Dependable and Secure Computing, vol. 20, no. 1, pp. 256-270
Guias relacionados: Um PC novo com SSD · Clonar ou transferir
Mais estatísticas (25)
Onde a mesma organização usou os dois, os SSDs falharam menos que HDs da mesma idade: as unidades de boot da Backblaze, os notebooks da Intel e os registros de uma montadora de estações de trabalho apontam todos na mesma direção. As comparações que põem os SSDs de uma empresa contra os HDs de outra, ou unidades de idades diferentes, não se sustentam. Os SSDs falham de outro jeito: mais vezes sumindo ou travando, raramente por desgaste.
Mesmos servidores, mesma idade: as unidades de boot da Backblaze

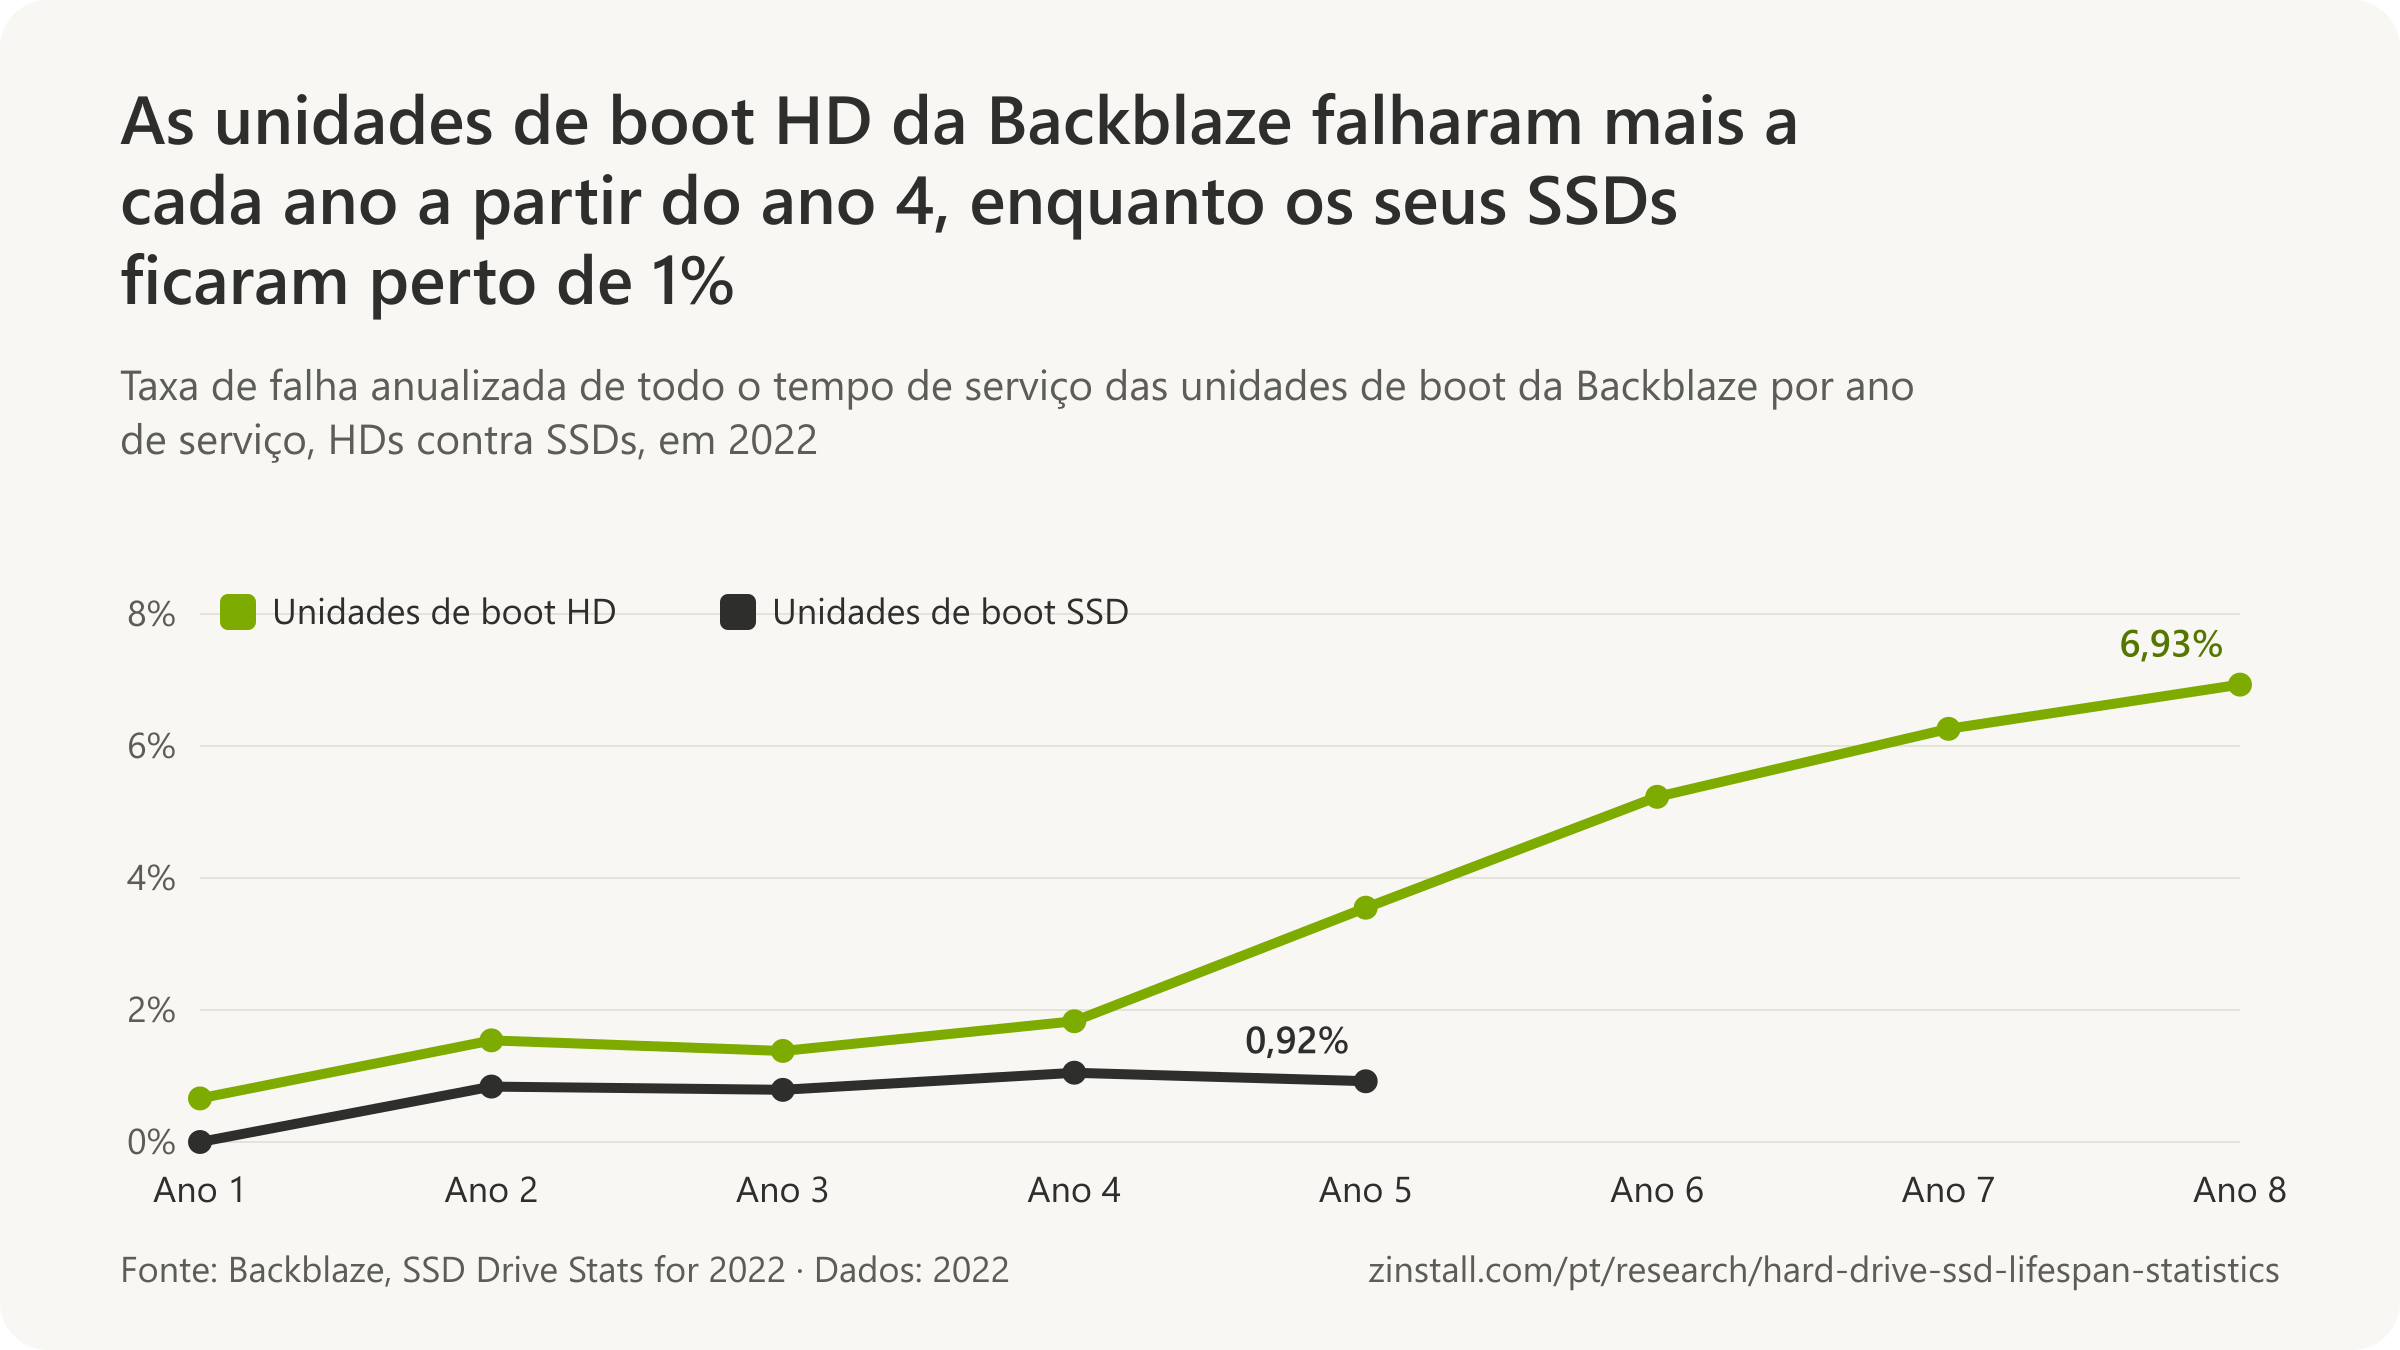
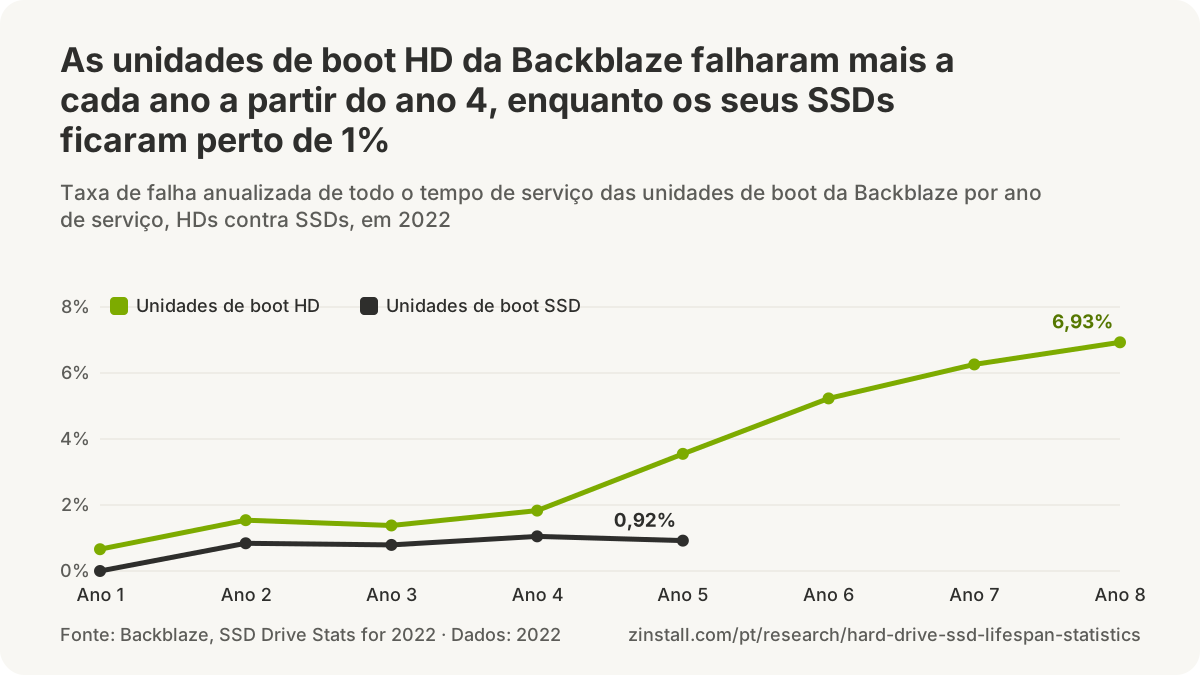
- 1,05% das unidades de boot SSD da Backblaze falharam por ano (taxa anualizada de todo o tempo de serviço) com idade média de 14 meses, contra 1,38% das suas unidades de boot HD na mesma idade (Backblaze, 2021).
- 1,38% das unidades de boot HD da Backblaze falharam por ano (taxa anualizada de todo o tempo de serviço) com idade média de 14 meses, medida no 4º trimestre de 2016 para igualar a idade dos SSDs (Backblaze, 2021).
- 6,41% das unidades de boot HD da Backblaze falharam por ano (taxa anualizada de todo o tempo de serviço) com idade média de 52 meses, contra 1,05% das unidades de boot SSD com idade média de 14 meses, uma comparação que a Backblaze chama de enganosa (Backblaze, 2021).
- 1,54% das unidades de boot HD da Backblaze falharam por ano com idade média de 12,3 meses, quase o dobro dos 0,79% das suas unidades de boot SSD na mesma idade (Backblaze, 2021).
- 34,9 graus Celsius era a temperatura média das unidades de boot SSD da Backblaze em 2022, mais quente que os 29,1 graus dos HDs nos mesmos servidores (Backblaze, 2023).
- 3.144 SSDs funcionavam como unidades de boot nos servidores de armazenamento da Backblaze em meados de 2023, contra 2.200 no fim de 2021 (Backblaze, 2023).
- 10,56% das unidades de boot HD da Backblaze falharam, em base anualizada, no 1º trimestre de 2021, contra 0,58% das suas unidades de boot SSD, com os HDs com idade média de 49,6 meses e os SSDs de 12,7 (Backblaze, 2021).
- 6,26% é a taxa de falha anualizada de todo o tempo de serviço das unidades de boot HD da Backblaze até o fim de 2020, contra 1,54% no fim de 2015, à medida que as unidades envelheciam (Backblaze, 2021).
Notebooks, estações de trabalho e uma varejista
- 0,34% dos HDs (na maioria WD) que a Puget Systems vendeu em 2018 falharam, contra 0,11% dos seus SSDs SATA Samsung e 0,08% dos seus SSDs NVMe Samsung, pelos registros da própria montadora (Puget Systems, 2019).
- Cerca de 1% dos HDs (WD Red, Gold e RE) que a Puget Systems vendeu em 2016 falharam, mais da metade deles depois de chegar ao cliente, pelos registros da própria montadora (Puget Systems, 2016).
- 0,18% dos SSDs SATA Samsung que a Puget Systems vendeu de 2013 ao início de 2016 falharam (cerca de 1 em 550), contra 1,41% dos seus HDs WD (cerca de 1 em 70), pelos registros da própria montadora (Puget Systems, 2016).
- 1,41% dos HDs WD (Blue, Green, Red, RE e SE) que a Puget Systems vendeu de 2013 ao início de 2016 falharam, cerca de 1 em 70, pelos registros da própria montadora (Puget Systems, 2016).
- Os HDs WD falharam a uma taxa 42 vezes maior que a dos SSDs SATA Samsung nas máquinas montadas pela Puget Systems em 2015, 5 vezes maior em 2014 e 4 vezes maior em 2013, pelos registros da própria montadora (Puget Systems, 2016).
- 0,74% dos HDs WD Red que a Puget Systems vendeu em 2015 falharam, a sua melhor linha de HDs naquele ano, enquanto os seus SSDs Samsung 850 EVO e 850 Pro falharam a 0,06% e 0,09%, pelos registros da própria montadora (Puget Systems, 2015).
- 0,67% dos HDs WD Red e 0,4% dos HDs WD Blue que a Puget Systems vendeu em 2014 falharam (uma unidade de cada), as suas duas melhores linhas de HDs naquele ano, pelos registros da própria montadora (Puget Systems, 2014).
- Os SSDs Samsung (linhas de consumo EVO e PRO) foram cerca de três vezes mais confiáveis que as CPUs Intel e cerca de 50% mais confiáveis que a memória ECC nas estações de trabalho da Puget Systems ao longo de três anos, pelos registros da própria montadora (Puget Systems, 2019).
- 0,61% dos SSDs Intel nos notebooks dos funcionários da Intel falharam por ano num estudo encerrado em fevereiro de 2011, contra 4,85% dos HDs dos seus notebooks em 2007, pela contagem da TI da Intel (Intel, 2011).
- 1,06% dos SSDs Intel nos notebooks dos funcionários da Intel foram devolvidos por ano como suspeitos de falha, e 130 das 227 unidades devolvidas (57%) tiveram a falha confirmada (Intel, 2011).

Data centers
- De 4% a 10% das unidades flash nos data centers do Google foram substituídas ao longo de quatro anos, enquanto estudos de campo anteriores tinham relatado de 2% a 9% de HDs substituídos a cada ano (Schroeder et al., 2016).
- 79% dos chamados de falha ligados a SSDs nos data centers da Microsoft terminaram com a troca da unidade, contra 11% dos chamados ligados a HDs (Narayanan et al., 2016).
- Os SSDs custavam por gigabyte de 4 a 40 vezes o preço dos HDs nos data centers da Microsoft em 2016, conforme a classe, o que, segundo os autores, pesava mais que as suas taxas de falha menores (Narayanan et al., 2016).
- As falhas ligadas a SSDs responderam por 5,6% dos mais de 150.000 chamados de falha de hardware nos sistemas de armazenamento da Alibaba Cloud, contra 22,1% dos HDs e 34,0% dos componentes de rede (Xu et al., 2019).
- 11,29% dos SSDs de data centers do Google num estudo falharam pelo menos uma vez em seis anos, contra 7,01% dos HDs da Backblaze com que o estudo os comparou, embora os dois parques fossem operados e contados de formas diferentes (Pinciroli et al., 2023).
- Os SSDs nos sistemas de armazenamento da NetApp funcionaram mais de duas vezes mais devagar que as outras unidades do seu grupo RAID em 0,6% do tempo, contra 0,2% dos HDs no mesmo tipo de sistema (Hao et al., 2016).
- 29% dos SSDs e 26% dos HDs nos sistemas de armazenamento da NetApp tiveram pelo menos um período em que funcionaram mais de duas vezes mais devagar que os seus pares no RAID, em cerca de 87 dias de monitoramento (Hao et al., 2016).
Fontes: Backblaze (2021, 2022, 2023); Puget Systems (2014-2019); Intel Corporation, on Intel's own fleet and Intel's own SSD product; USENIX, Proceedings of the 14th USENIX Conference on File and Storage Technologies (2016); ACM, Proceedings of the 9th ACM International Systems and Storage Conference; USENIX, Proceedings of the 2019 USENIX Annual Technical Conference; IEEE, Transactions on Dependable and Secure Computing, vol. 20, no. 1, pp. 256-270; Hardware.fr (2010-2015)
Quais marcas de HD falham mais?
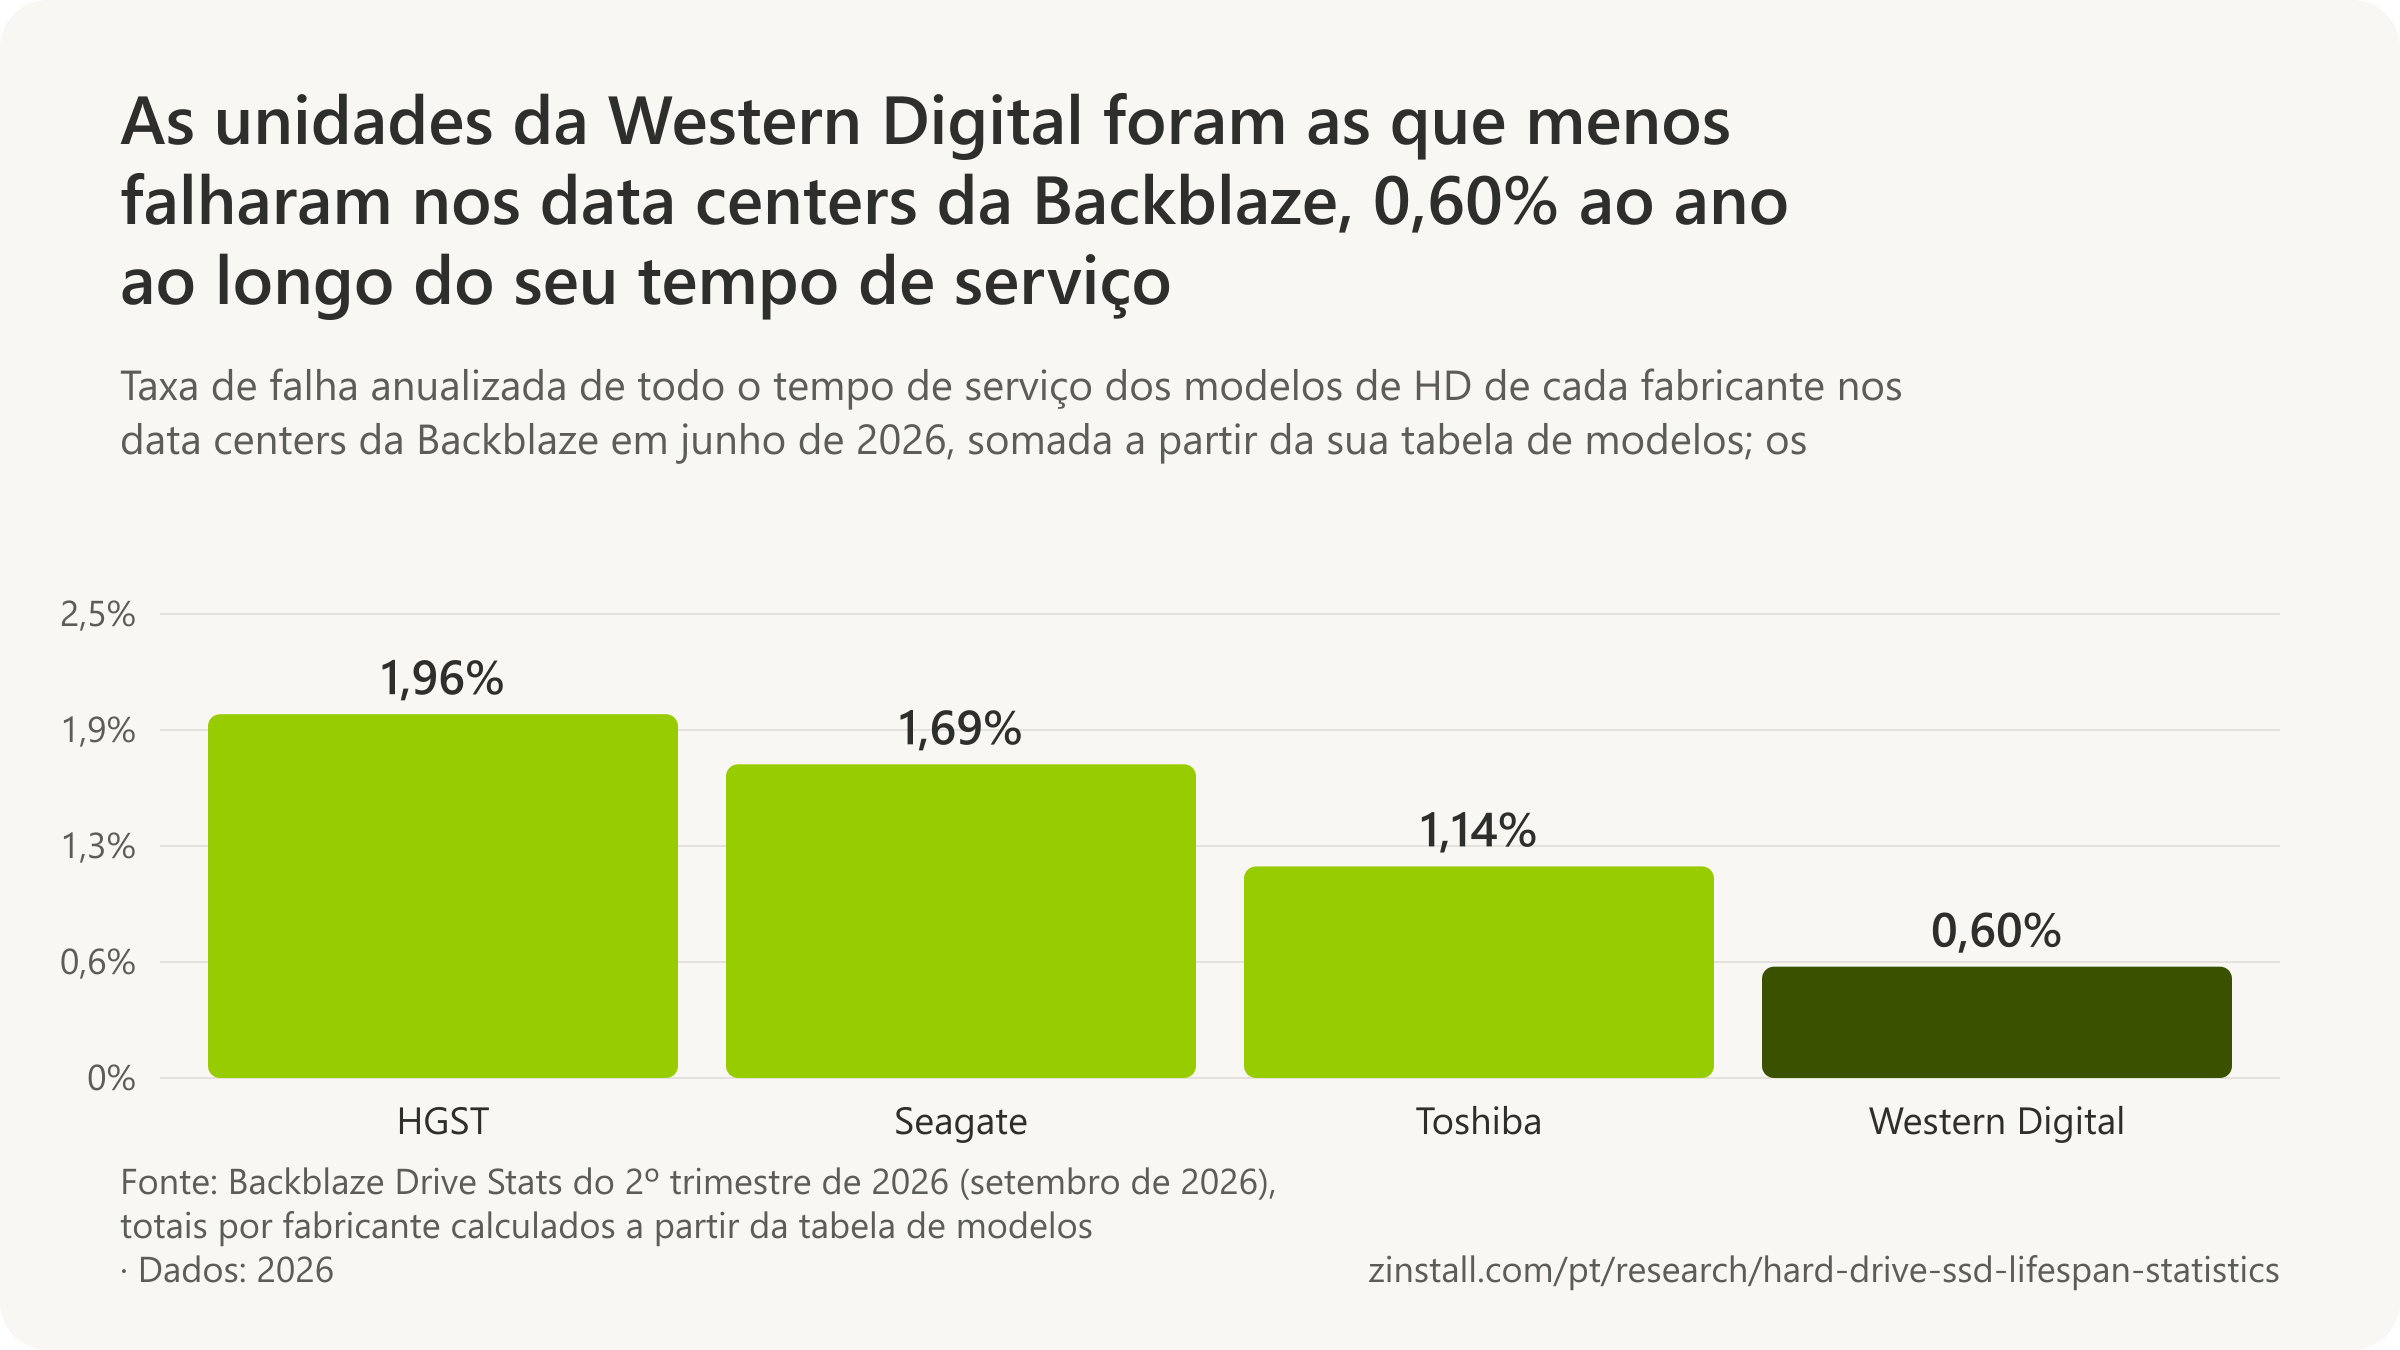
As unidades da Western Digital falharam a 0,60% ao ano ao longo do seu tempo de serviço num parque de nuvem, e as da HGST a 1,96% (Backblaze, 2026).

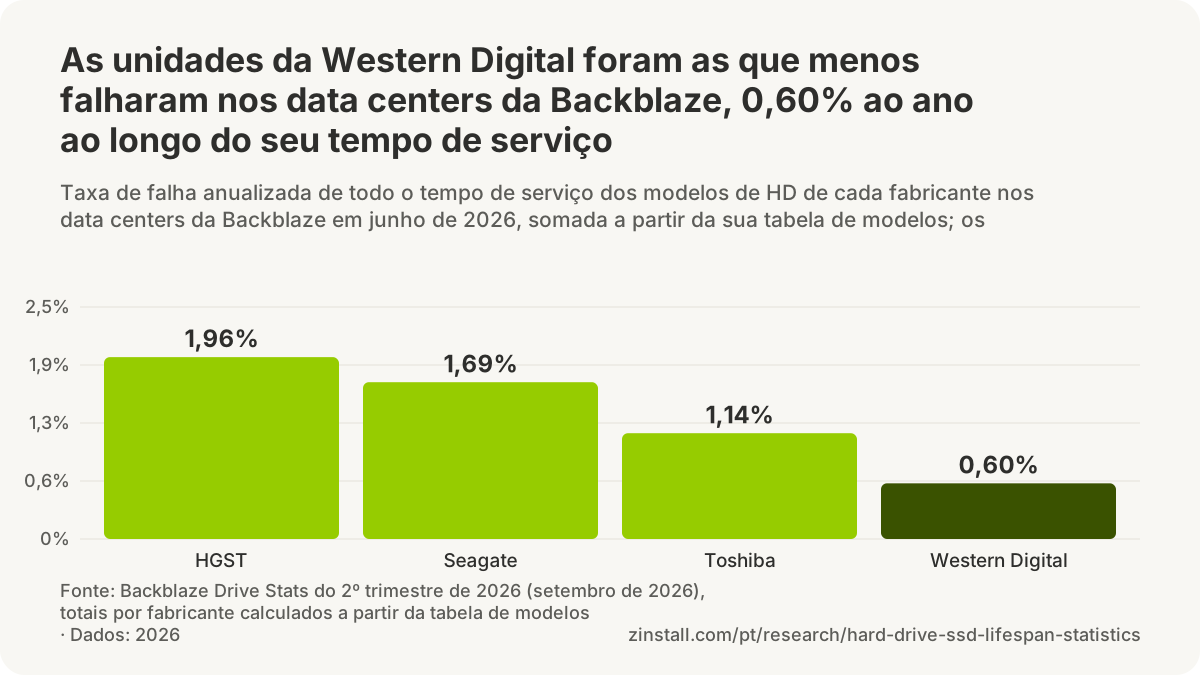
- Com idade e capacidade iguais, as unidades da HGST falharam a cerca de 41% da taxa da Seagate numa análise de 2026.
- Num parque de nuvem, a taxa de falha de todo o tempo de serviço do pior modelo era de 5,88%, um HD Seagate de 14TB, em junho de 2026.
- Um modelo Seagate de 3TB falhou a uma taxa anualizada de 43,1% em 2014, o pior entre os modelos com muitas unidades de um parque de nuvem naquele ano.
- 1,26% das unidades da Western Digital que uma varejista francesa vendeu em 2016 voltaram com defeito, a maior taxa entre as marcas.
- Num parque de nuvem, as unidades com hélio falharam a 1,03% ao ano, contra 1,06% das unidades de 8TB com ar.
| Modelo, medida e data | Número |
|---|---|
| WDC 22TB (WUH722222ALE6L4), 2025: a mais baixa | 0,47% |
| Seagate 16TB (ST16000NM001G), 2025 | 0,54% |
| HGST 12TB (HUH721212ALN604), 2025 | 3,95% |
| Toshiba 16TB (MG08ACA16TEY), 2025, inflada pelas retiradas ligadas ao firmware | 6,30% |
| WDC 14TB (WUH721414ALE6L4), todo o tempo de serviço | 0,54% |
| Toshiba 14TB (MG07ACA14TA), todo o tempo de serviço | 1,07% |
| HGST 4TB: expectativa de unidades funcionando aos seis anos | 97% |
| Seagate 4TB: expectativa de unidades funcionando aos seis anos | 81% |
| Seagate Barracuda 7200.11 500GB: devolvidos a uma varejista francesa, 2009 | 39% |
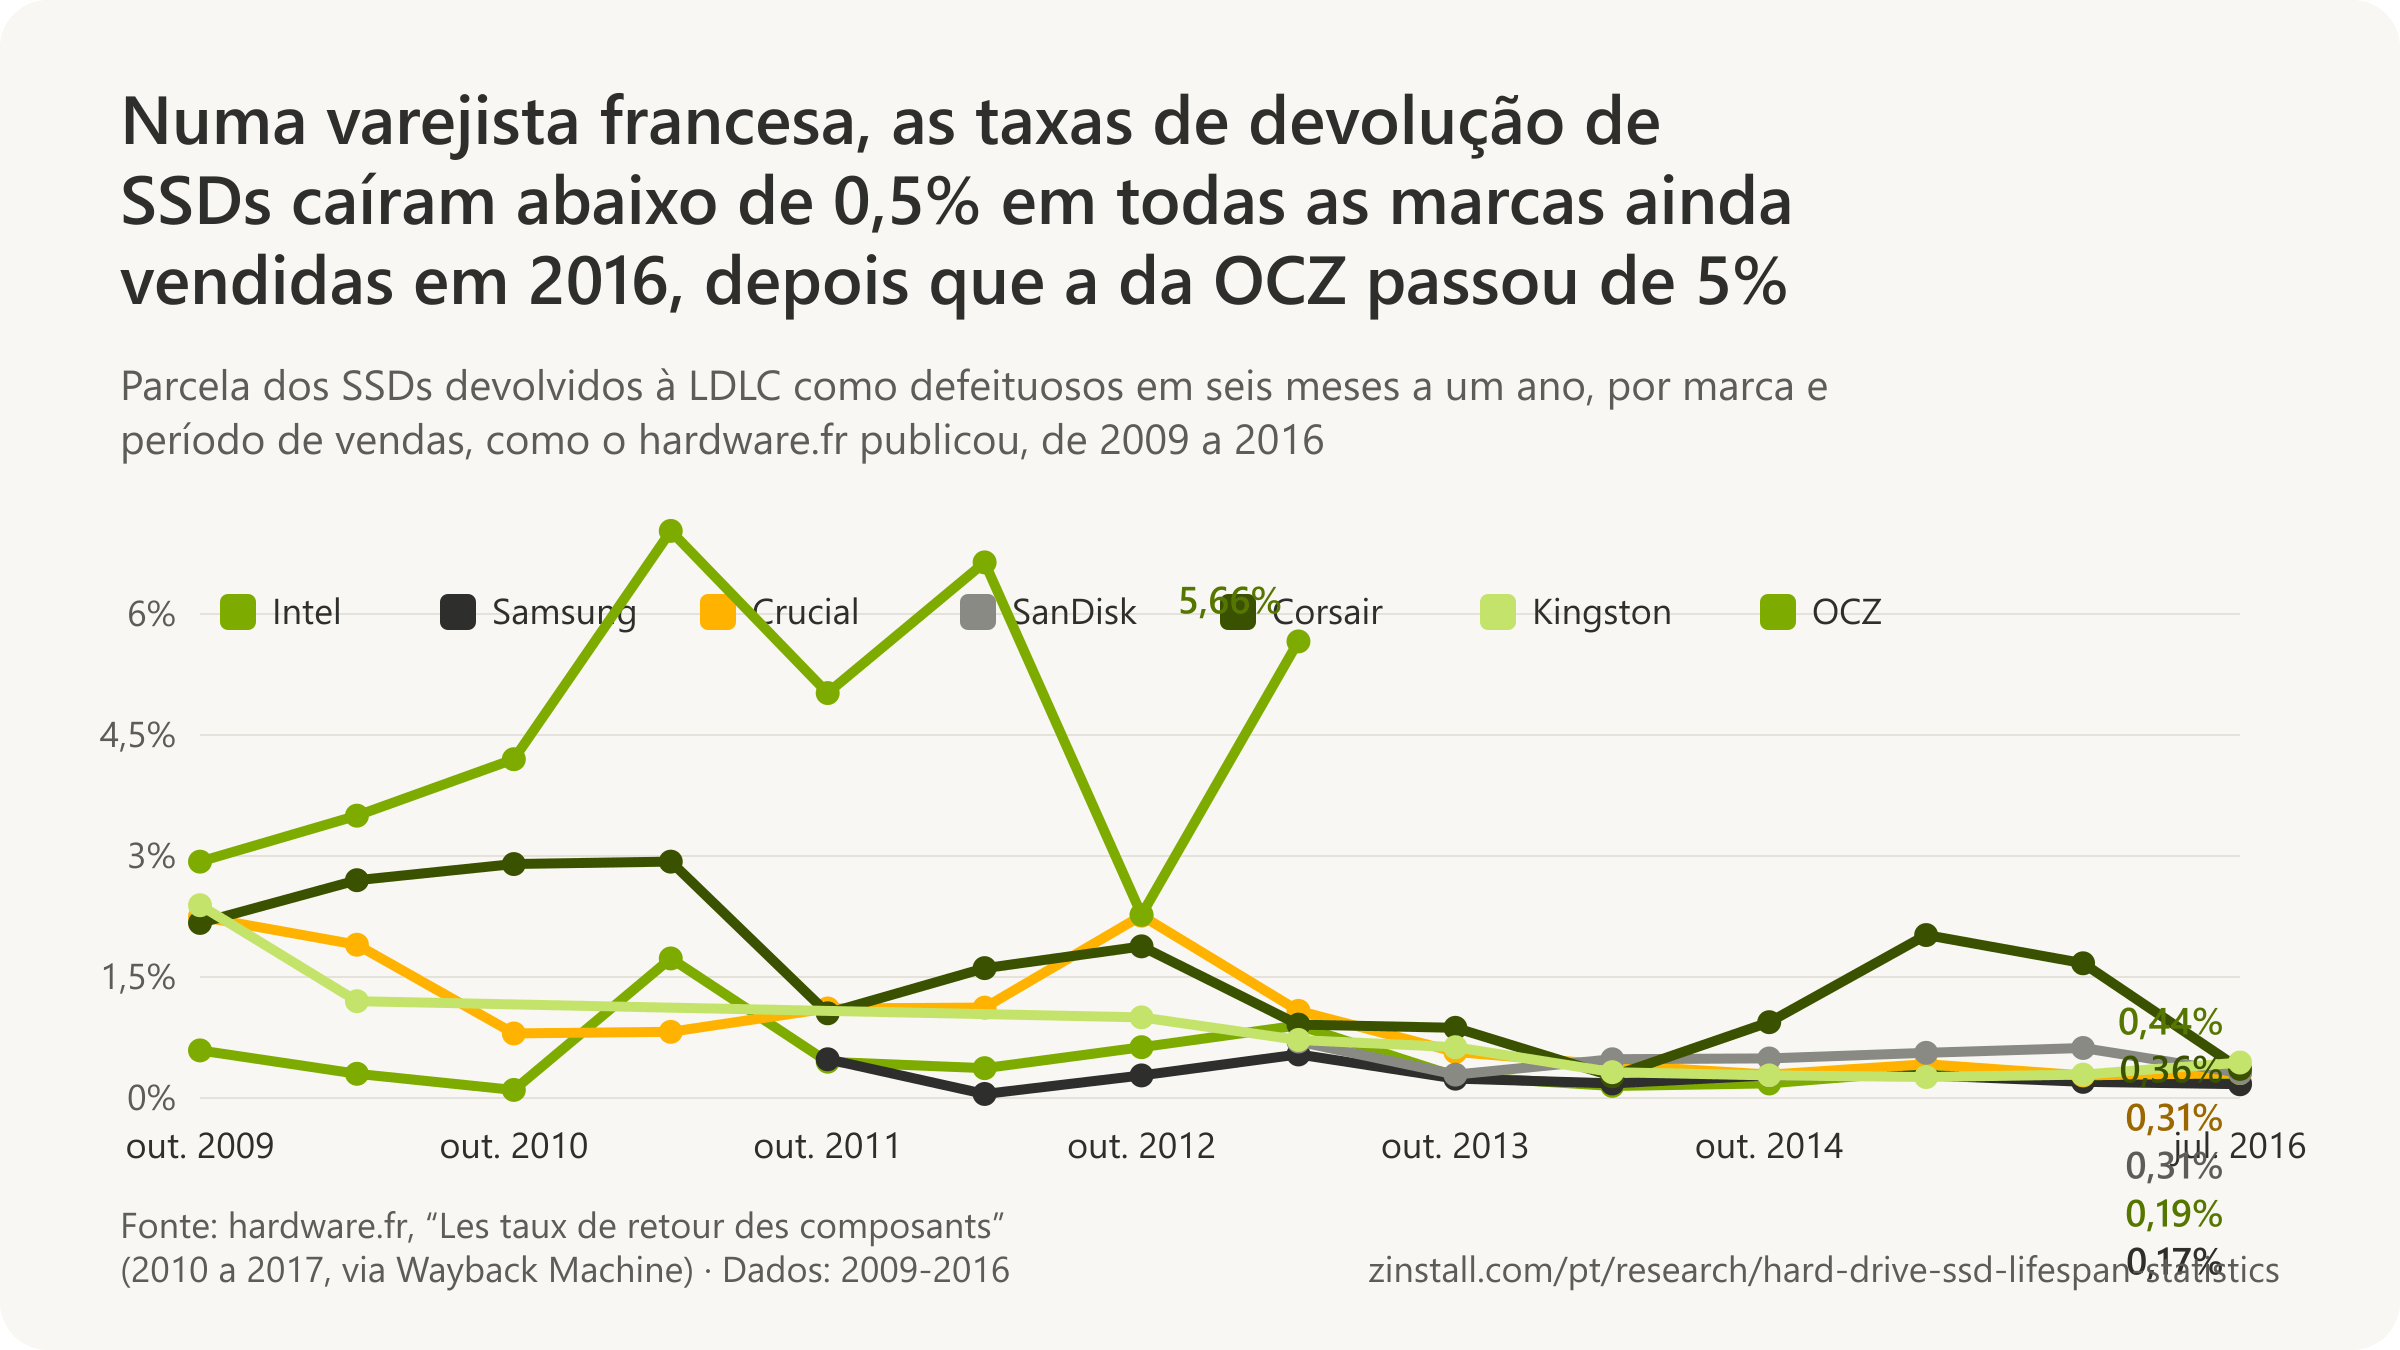
| SSD OCZ Octane 128GB: devolvidos a uma varejista francesa, 2012 | 52,07% |
Fontes: Backblaze (2015-2026); University of Essex and Sungkyunkwan University; Hardware.fr (2017, 2013, 2010)
Guias relacionados: Um HD antigo para um PC novo · Um PC novo com SSD
Mais estatísticas (51)
Os rankings de marcas mudam com os modelos que um parque compra: todo fabricante já teve modelos bons e ruins. No parque da Backblaze, onde todas as unidades trabalham do mesmo jeito, as unidades atuais da Western Digital foram as que menos falharam e as unidades envelhecidas da HGST as que mais falharam, enquanto uma análise acadêmica de 2026 dos mesmos dados, que manteve constantes a idade, a capacidade e a temperatura, concluiu que as unidades da HGST eram as menos propensas a falhar. Numa grande varejista francesa, as quatro marcas ainda vendidas em 2016 voltaram com defeito a cerca de um por cento. O modelo pesa mais que a marca.
O parque da Backblaze por fabricante

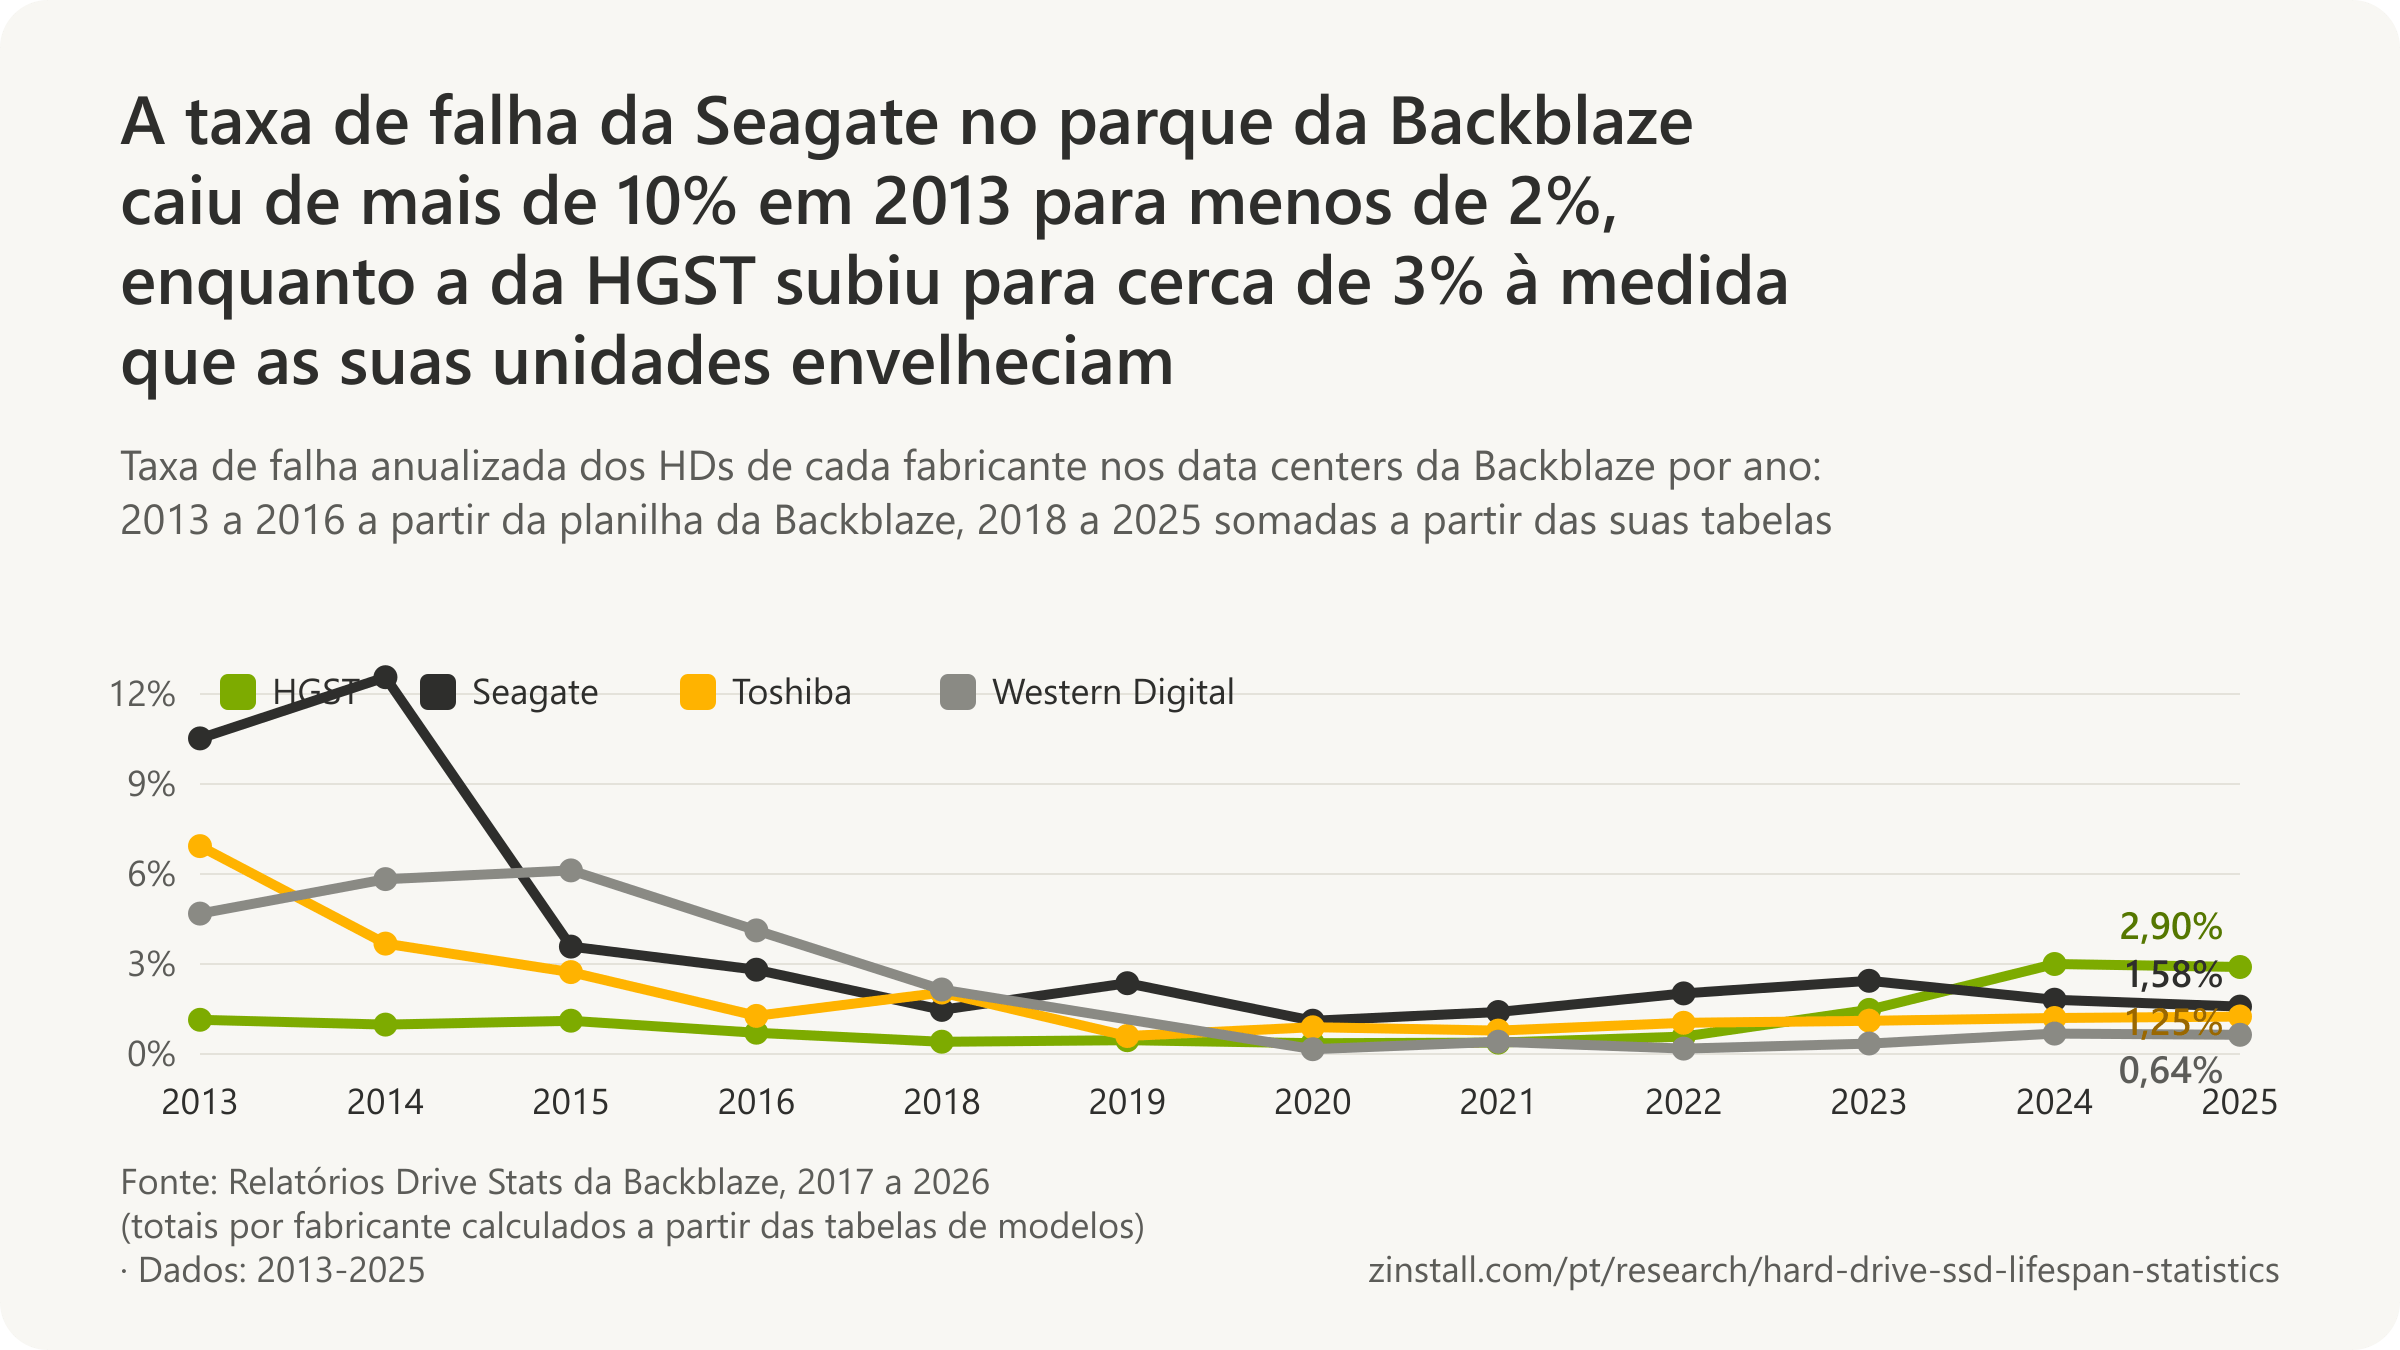
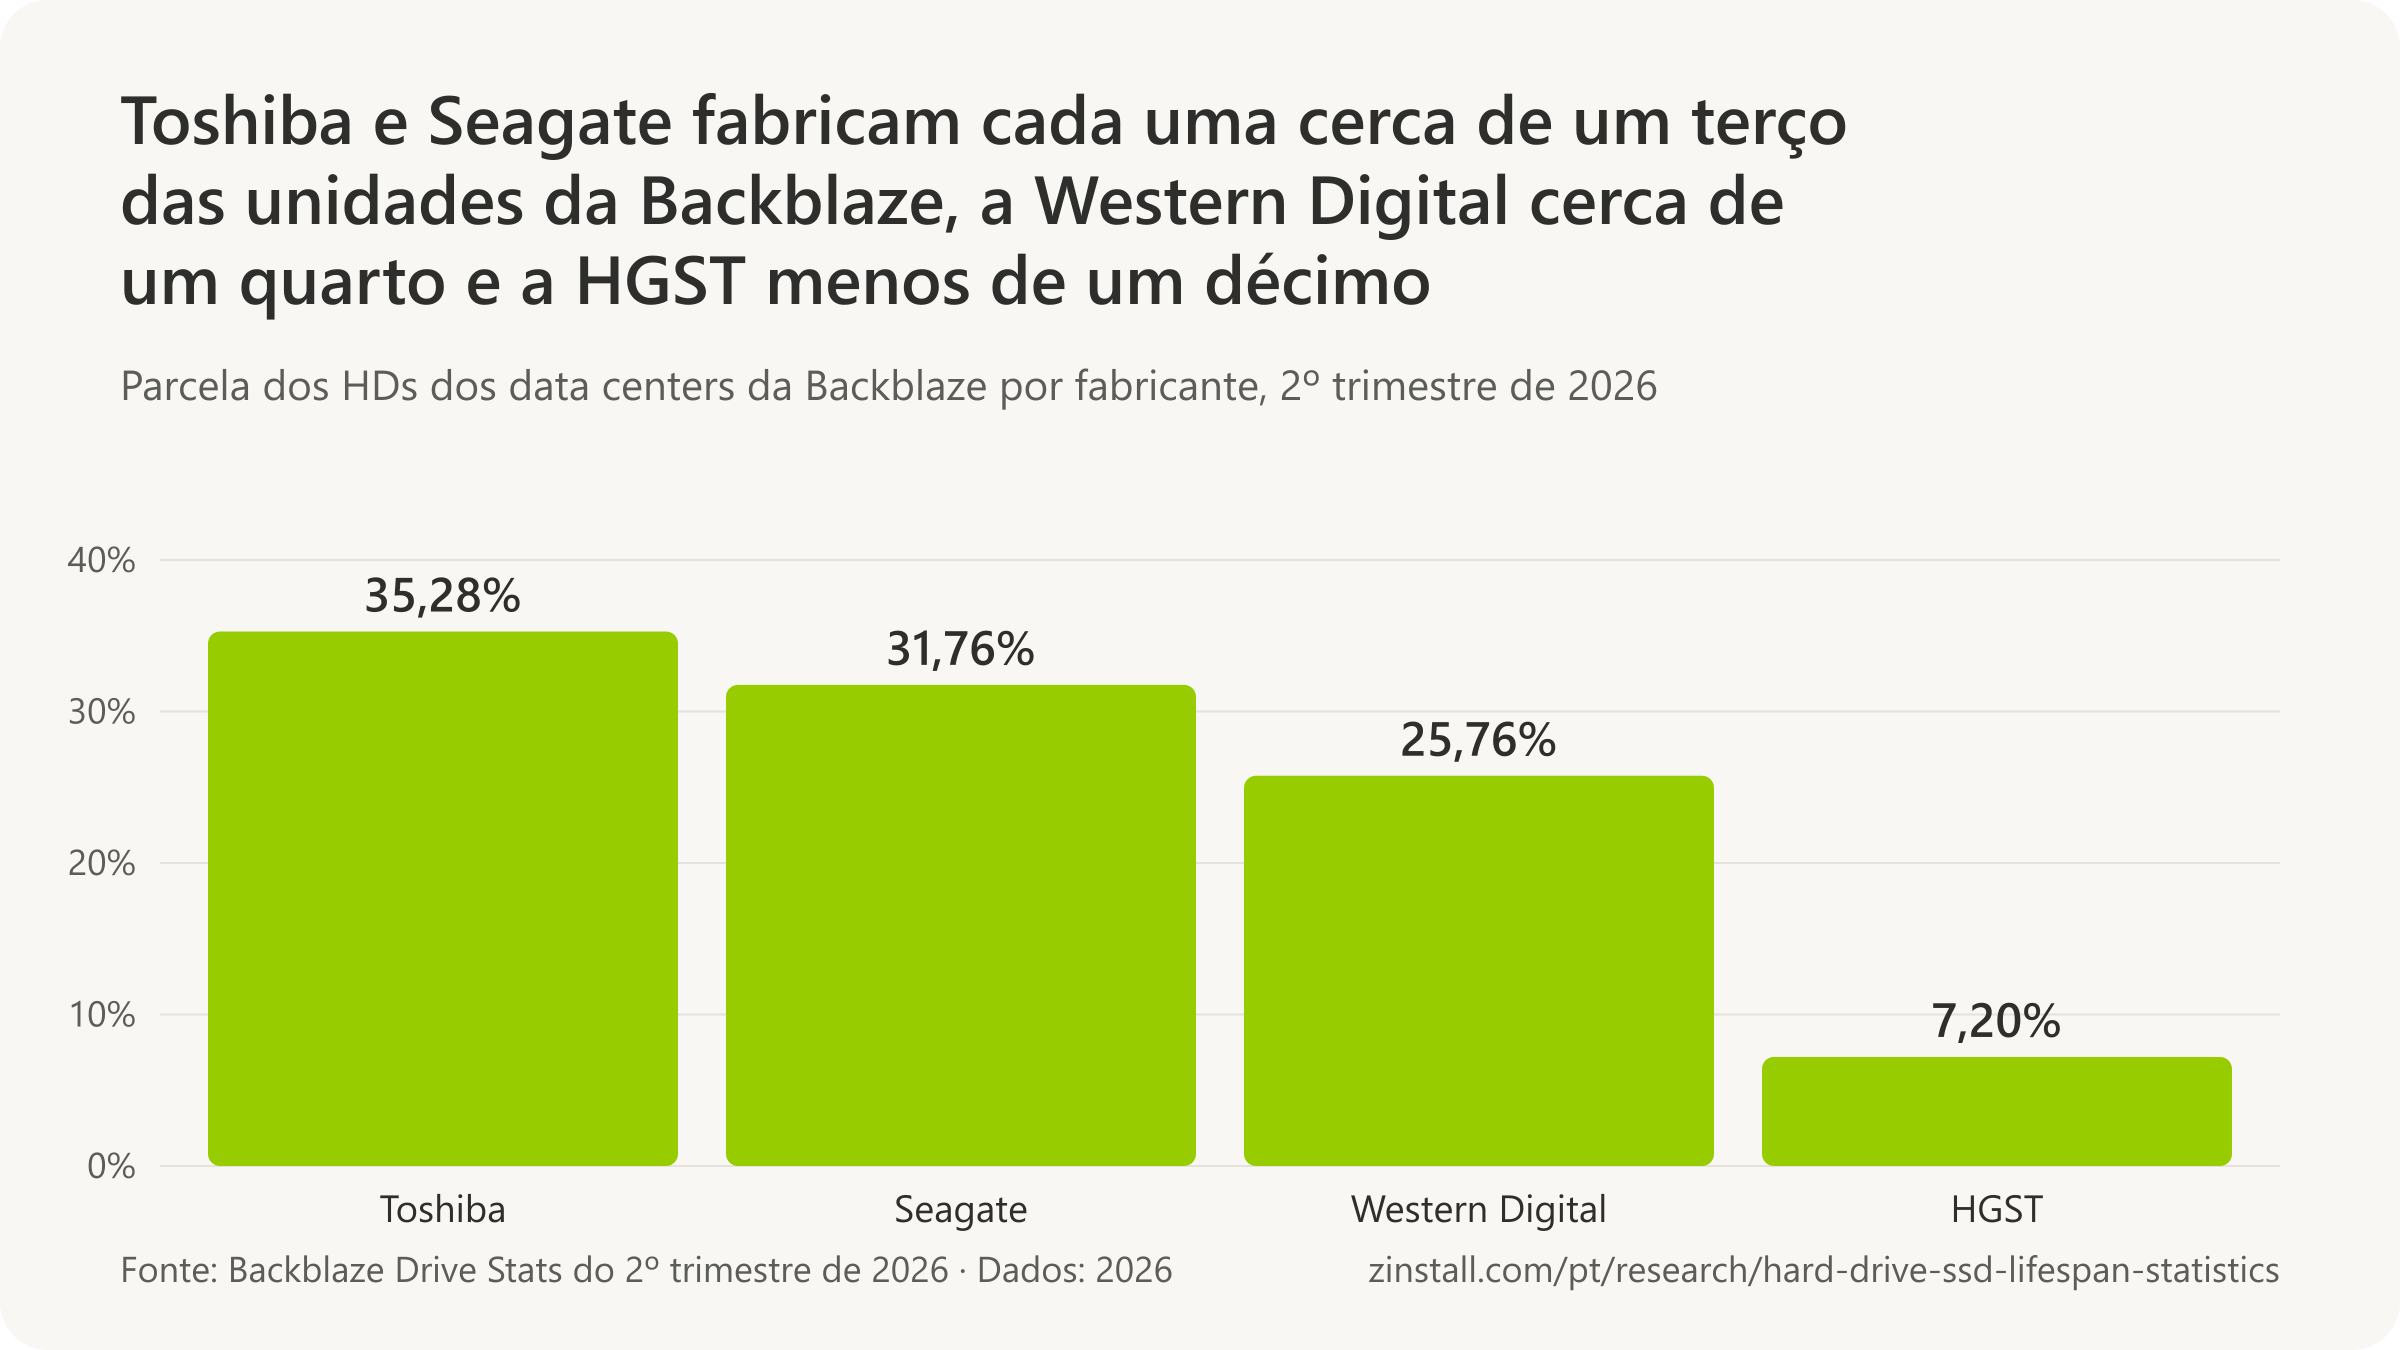
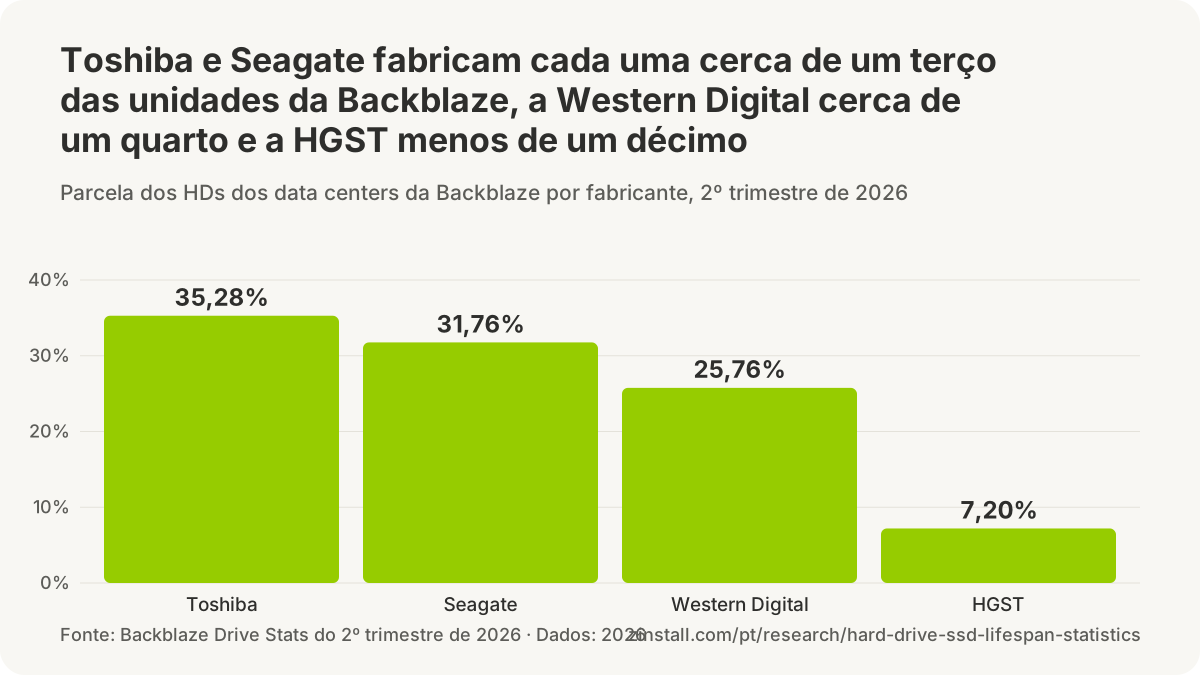
- 2,07% dos HDs Seagate dos data centers da Backblaze falharam no 2º trimestre de 2026, em base anualizada (falhas por unidade-ano), 573 falhas entre 112.567 unidades, somadas a partir da tabela de modelos da Backblaze (dados da Backblaze, 2026).
- 4,72% dos HDs HGST (a antiga linha Hitachi da Western Digital) dos data centers da Backblaze falharam no 2º trimestre de 2026, em base anualizada (falhas por unidade-ano), 296 falhas entre 25.489 unidades, somadas a partir da tabela de modelos da Backblaze (dados da Backblaze, 2026).
- 1,40% dos HDs Toshiba dos data centers da Backblaze falharam no 2º trimestre de 2026, em base anualizada (falhas por unidade-ano), 424 falhas entre 125.050 unidades, somadas a partir da tabela de modelos da Backblaze (dados da Backblaze, 2026).
- 0,92% dos HDs Western Digital (marca WDC) dos data centers da Backblaze falharam no 2º trimestre de 2026, em base anualizada (falhas por unidade-ano), 205 falhas entre 91.309 unidades, somadas a partir da tabela de modelos da Backblaze (dados da Backblaze, 2026).

Com idade, capacidade e temperatura constantes
- Os HDs da HGST falharam a cerca de 41% da taxa da Seagate e os da Western Digital a cerca de 52%, enquanto os da Toshiba ficaram cerca de 7% acima dos da Seagate, mantendo constantes a idade, a capacidade e a temperatura, em 443.156 unidades dos data centers da Backblaze (University of Essex e Sungkyunkwan University, 2026).
- Cada terabyte extra de capacidade reduziu a taxa de falha em 3,4%, mantendo constantes a idade, o fabricante e o formato, em 443.156 HDs dos data centers da Backblaze (University of Essex e Sungkyunkwan University, 2026).
Os melhores e os piores modelos
- 6,30% dos HDs Toshiba MG08ACA16TEY (16TB) da Backblaze falharam, em base anualizada, em 2025, a mais alta entre os modelos com mais de um milhão de dias-unidade em 2025, 318 falhas em 1.843.841 dias-unidade em 5.197 unidades (Backblaze, 2026).
- 3,95% dos HDs HGST HUH721212ALN604 (12TB) da Backblaze falharam, em base anualizada, em 2025, a mais alta sem uma causa pontual conhecida entre os modelos com mais de um milhão de dias-unidade, 393 falhas em 3.628.418 dias-unidade em 10.195 unidades (Backblaze, 2026).
- 0,47% dos HDs WDC WUH722222ALE6L4 (22TB) da Backblaze falharam, em base anualizada, em 2025, a menor taxa entre os modelos com mais de um milhão de dias-unidade, 177 falhas em 13.612.879 dias-unidade em 44.577 unidades (Backblaze, 2026).
- 0,54% dos HDs Seagate ST16000NM001G (16TB) da Backblaze falharam, em base anualizada, em 2025, a menor taxa entre os modelos com mais de três anos e mais de um milhão de dias-unidade, 182 falhas em 12.381.689 dias-unidade em 34.563 unidades (Backblaze, 2026).
- 0,49% dos HDs HGST HMS5C4040BLE640 (4TB) da Backblaze falharam, em base anualizada, em 2025, o modelo mais antigo do parque em 2025, com 8,6 anos em média, 5 falhas em 375.277 dias-unidade em 4.121 unidades (Backblaze, 2026).
- 5,66% dos HDs Seagate ST10000NM0086 (10TB) da Backblaze falharam, em base anualizada, em 2025, entre as taxas mais altas de todos os modelos em 2025, 57 falhas em 367.460 dias-unidade em 1.044 unidades (Backblaze, 2026).
- 5,88% é a taxa de falha anualizada de todo o tempo de serviço dos HDs Seagate ST14000NM0138 (14TB) da Backblaze em 30 de junho de 2026, a mais alta de todos os modelos listados, 464 falhas em 2.878.064 dias-unidade (Backblaze, 2026).
- 0,54% é a taxa de falha anualizada de todo o tempo de serviço dos HDs WDC WUH721414ALE6L4 (14TB) da Backblaze em 30 de junho de 2026, a menor taxa de todo o tempo de serviço entre os modelos com mais de 10 milhões de dias-unidade, 254 falhas em 17.127.349 dias-unidade (Backblaze, 2026).
- 1,07% é a taxa de falha anualizada de todo o tempo de serviço dos HDs Toshiba MG07ACA14TA (14TB) da Backblaze em 30 de junho de 2026, o modelo com mais dias-unidade na tabela, 2.293 falhas em 78.387.008 dias-unidade (Backblaze, 2026).
- 3 de 31 modelos de HD na tabela do 2º trimestre de 2026 da Backblaze foram pontos fora da curva estatísticos, acima de uma taxa de falha anualizada de 6,95%, o pior deles um modelo Seagate de 10TB, com 9,33% (Backblaze, 2026).
- 97% das unidades HGST de 4TB (HMS5C4040BLE640) da Backblaze tinham expectativa de continuar funcionando após seis anos, pelas suas curvas de sobrevivência de Kaplan-Meier (Backblaze, 2022).
- 81% das unidades Seagate de 4TB (ST4000DM000) da Backblaze tinham expectativa de continuar funcionando após seis anos, pelas suas curvas de sobrevivência de Kaplan-Meier (Backblaze, 2022).
- 95% das unidades Seagate de 8TB de consumo (ST8000DM002) da Backblaze tinham expectativa de continuar funcionando após cinco anos, pelas suas curvas de sobrevivência de Kaplan-Meier (Backblaze, 2022).
- 93,6% das unidades Seagate de 8TB corporativas (ST8000NM0055) da Backblaze tinham expectativa de continuar funcionando após cinco anos, pelas suas curvas de sobrevivência de Kaplan-Meier (Backblaze, 2022).
- 98% das unidades de 12TB da Backblaze (três modelos HGST e Seagate) tinham expectativa de continuar funcionando após dois anos, pelas suas curvas de sobrevivência de Kaplan-Meier (Backblaze, 2022).
- 97% das unidades Toshiba de 14TB (MG07ACA14TA) da Backblaze tinham expectativa de continuar funcionando após três anos, pelas suas curvas de sobrevivência de Kaplan-Meier (Backblaze, 2022).
O HD de 3 TB da Seagate

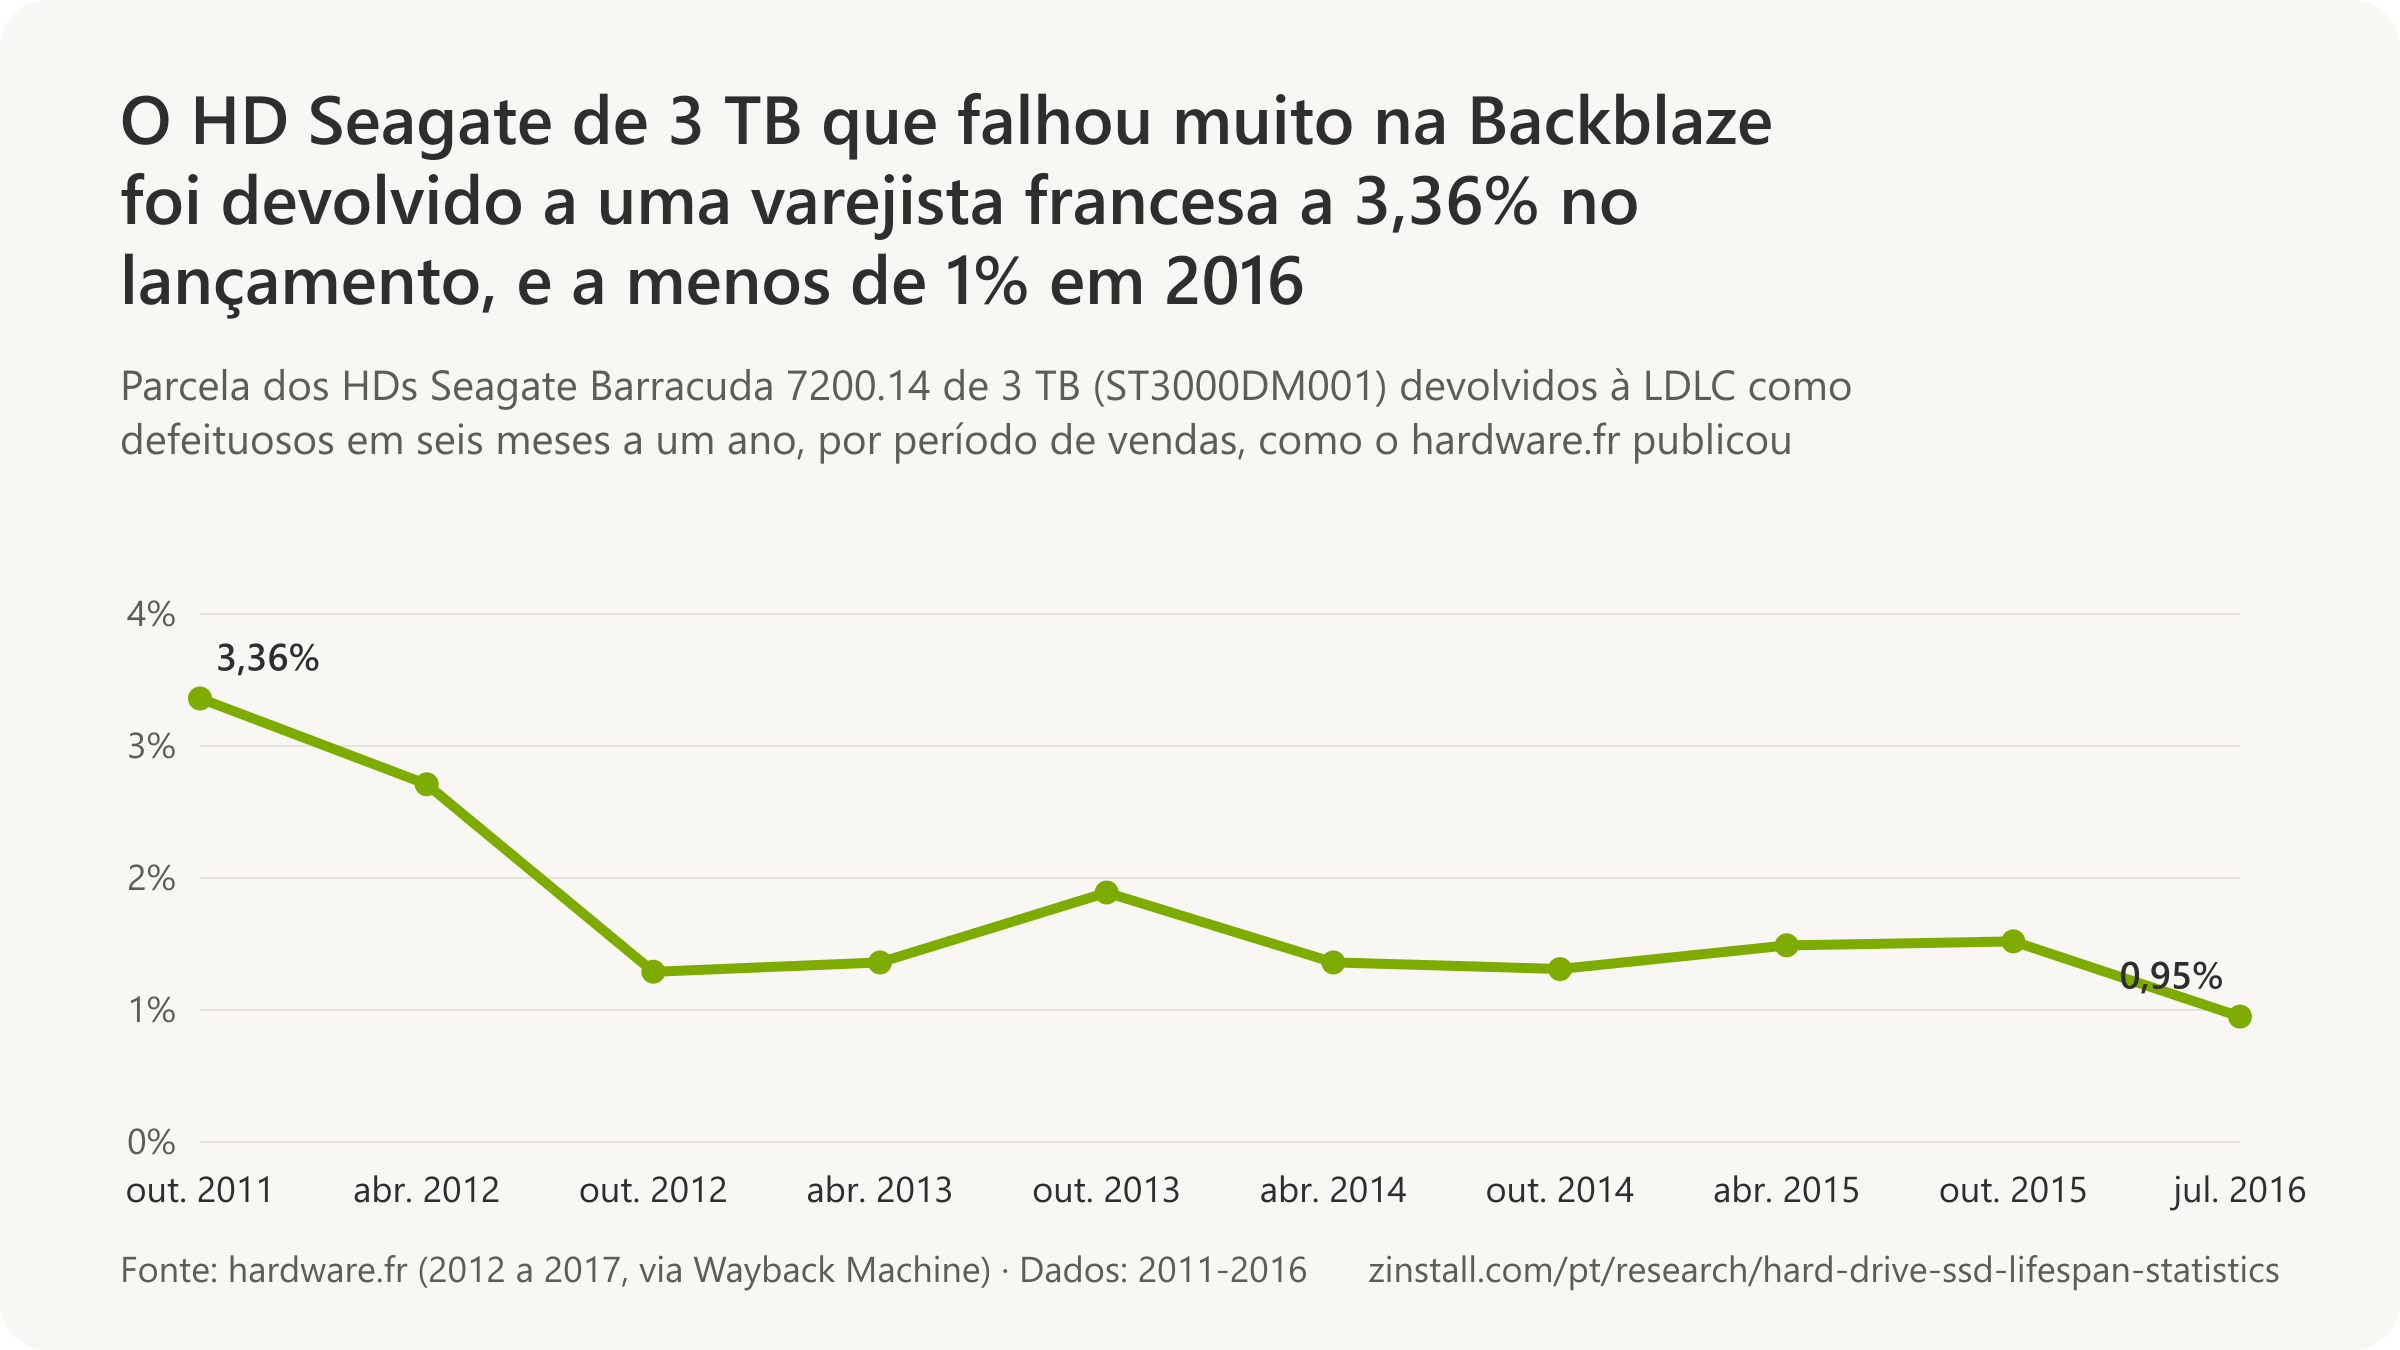
- 47,2% dos HDs Seagate de 3TB (ST3000DM001) que a Backblaze instalou em 2012 falharam durante 2014, depois de 2,7% em 2012 e 5,4% em 2013 (Backblaze, 2015).
- 43,1% dos HDs Seagate Barracuda 7200.14 de 3TB da Backblaze falharam, em base anualizada, em 2014, o pior entre os modelos com muitas unidades na sua tabela de 2014 (Backblaze, 2015).
- 15,7% dos HDs Seagate Barracuda 7200.14 de 3TB da Backblaze estavam falhando por ano em meados de 2014, contra cerca de 9% até 2013 (Backblaze, 2014).
Tipos de unidade: capacidade, hélio, linha corporativa e gravação sobreposta (shingled)

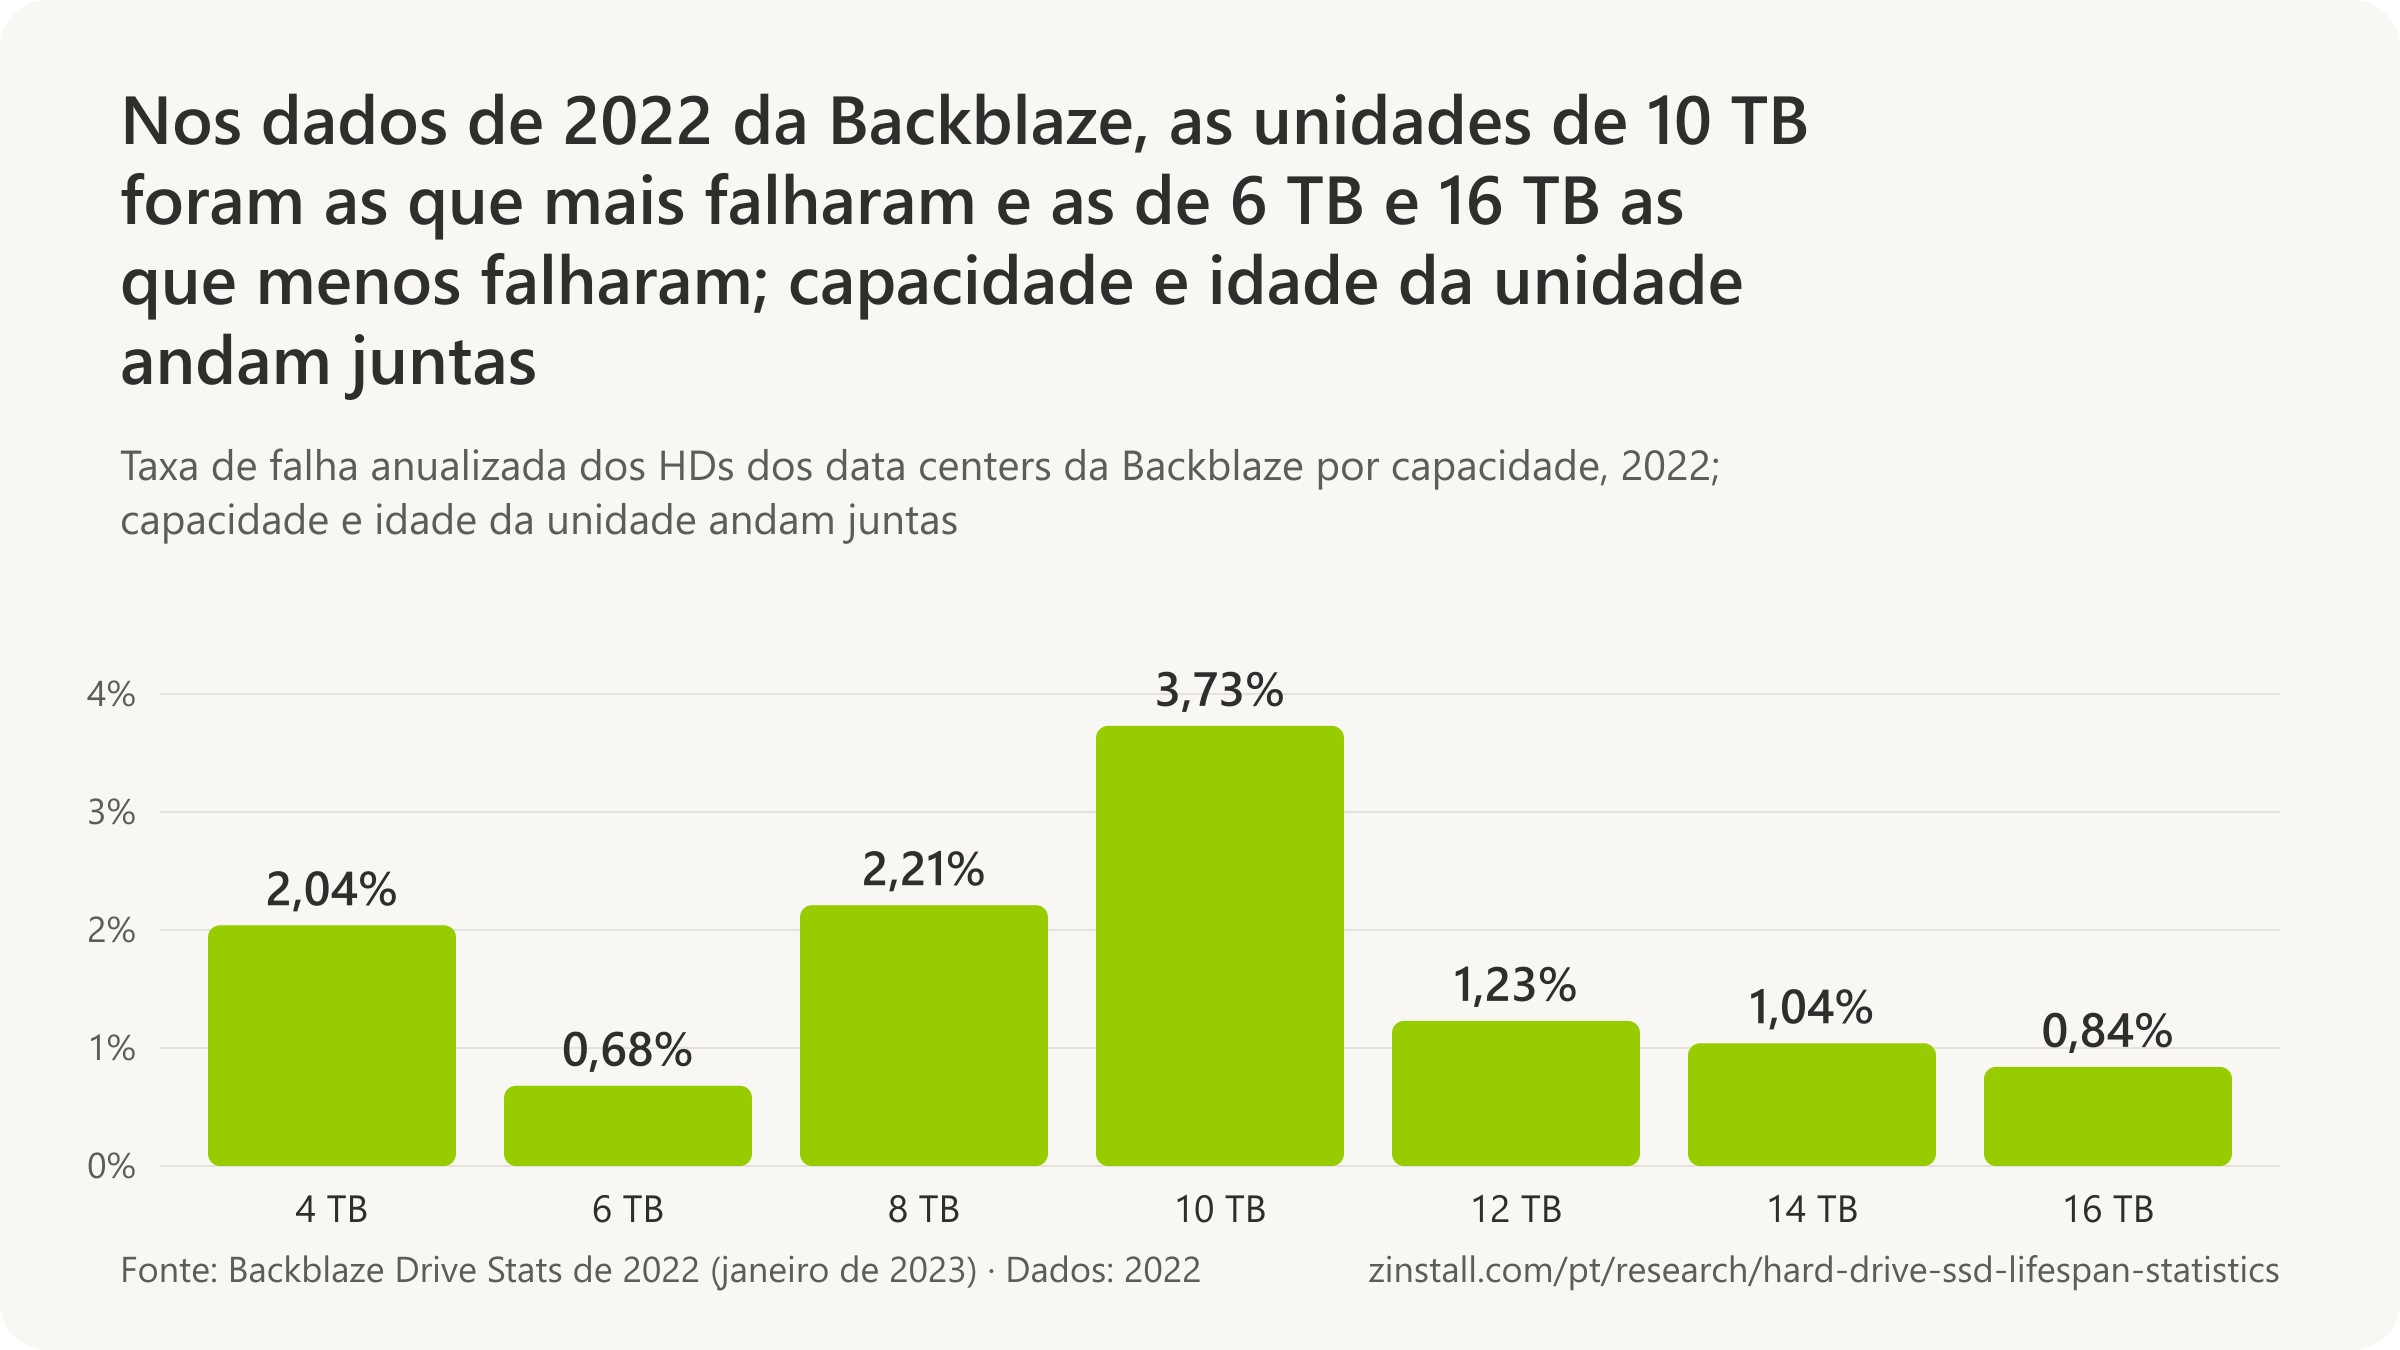
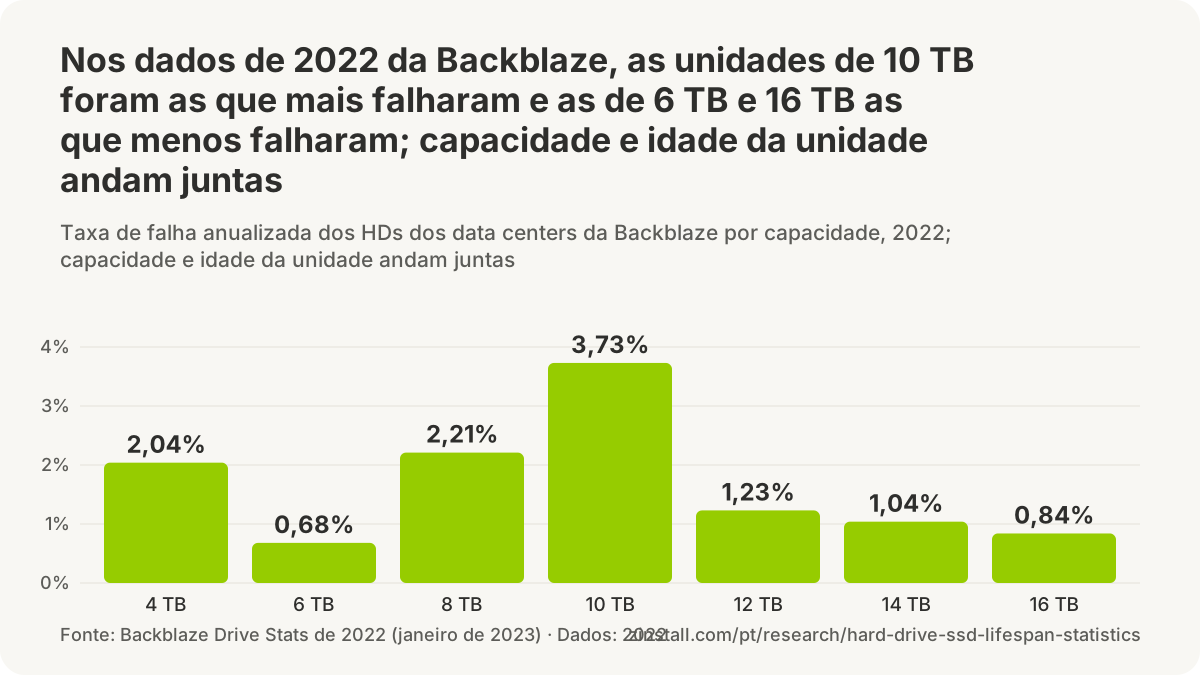
- 2,33% dos HDs de 12TB ou menos dos data centers da Backblaze falharam em 2025, em base anualizada (falhas por unidade-ano), 1.987 falhas entre 89.939 unidades (dados da Backblaze, 2026).
- 1,10% dos HDs de 14TB a 16TB dos data centers da Backblaze falharam em 2025, em base anualizada (falhas por unidade-ano), 1.919 falhas entre 177.041 unidades (dados da Backblaze, 2026).
- 0,72% dos HDs de 20TB ou mais dos data centers da Backblaze falharam em 2025, em base anualizada (falhas por unidade-ano), 411 falhas entre 77.216 unidades (dados da Backblaze, 2026).
- 0,85% das unidades com mais de 20TB recém-instaladas pela Backblaze falharam, em base anualizada, como conjunto no 1º trimestre de 2026 (Backblaze, 2026).
- 2,12% dos HDs de 4TB a 10TB da Backblaze falharam, em base anualizada, em 2022, contra 1,07% das suas unidades de 12TB a 16TB, sendo as unidades menores muito mais antigas (Backblaze, 2023).
- 1,03% dos HDs com hélio de 8TB a 12TB da Backblaze falharam por ano (taxa anualizada de todo o tempo de serviço), contra 1,06% das suas unidades de 8TB com ar (Backblaze, 2018).
- 1,61% era a taxa de falha anualizada das unidades de 8TB com ar da Backblaze quando elas tinham um número de dias-unidade semelhante ao das suas unidades com hélio, contra cerca de 1,06% das unidades com hélio, como dizia o texto de 2018 da Backblaze, e 1,03% na sua tabela (Backblaze, 2018).
- 4,6% dos HDs de classe corporativa da Backblaze falharam por ano, contra 4,2% das suas unidades de consumo, na sua comparação de 2013 (Backblaze, 2013).
- 4,2% dos HDs de linha de consumo nos Storage Pods da Backblaze falharam por ano na sua primeira medição em todo o parque, 613 falhas em 14.719 unidades-ano (Backblaze, 2013).
- 0,97% das unidades Seagate de 8TB corporativas da Backblaze falharam por ano (taxa anualizada de todo o tempo de serviço), contra 1,03% da versão de consumo da mesma capacidade (Backblaze, 2018).
- Havia 0 HDs de gravação sobreposta (SMR) no parque da Backblaze em 2026; todas as unidades das suas tabelas de falhas usam gravação convencional (CMR) (Backblaze, 2026).
- A Seagate classifica os seus HDs de desktop BarraCuda CMR de 3,5 polegadas (12 TB a 24 TB) para uma carga de trabalho de 120 TB por ano (Seagate, 2026).
- A Seagate classifica os seus HDs de desktop BarraCuda SMR de 3,5 polegadas (4 TB e 8 TB, 5.400 rpm) para uma carga de trabalho de 55 TB por ano, menos da metade dos 120 TB dos seus modelos CMR (Seagate, 2026).
- A Seagate afirma que todos os HDs para NAS IronWolf usam gravação magnética convencional (CMR), e não gravação sobreposta (SMR) (Seagate, 2022).
- A linha WD Blue de HDs de desktop de 3,5 polegadas da WD lista gravação SMR (sobreposta) em 5 dos seus 18 modelos, de 2 TB, 3 TB, 4 TB e 6 TB, ao lado de modelos CMR das mesmas capacidades (Western Digital, 2025).
- A ficha técnica dos HDs de desktop P300 da Toshiba lista gravação SMR (sobreposta) para todos os três modelos P300 atuais, de 2 TB, 4 TB e 6 TB (Toshiba, 2025).
- A Western Digital diz que os seus dados de muitas gerações de unidades mostram taxas de falha quase idênticas para HDs de 3 pratos e 6 cabeças até 10 pratos e 20 cabeças, com uma dada carga de trabalho (Western Digital, 2023).
Taxas de devolução numa varejista francesa

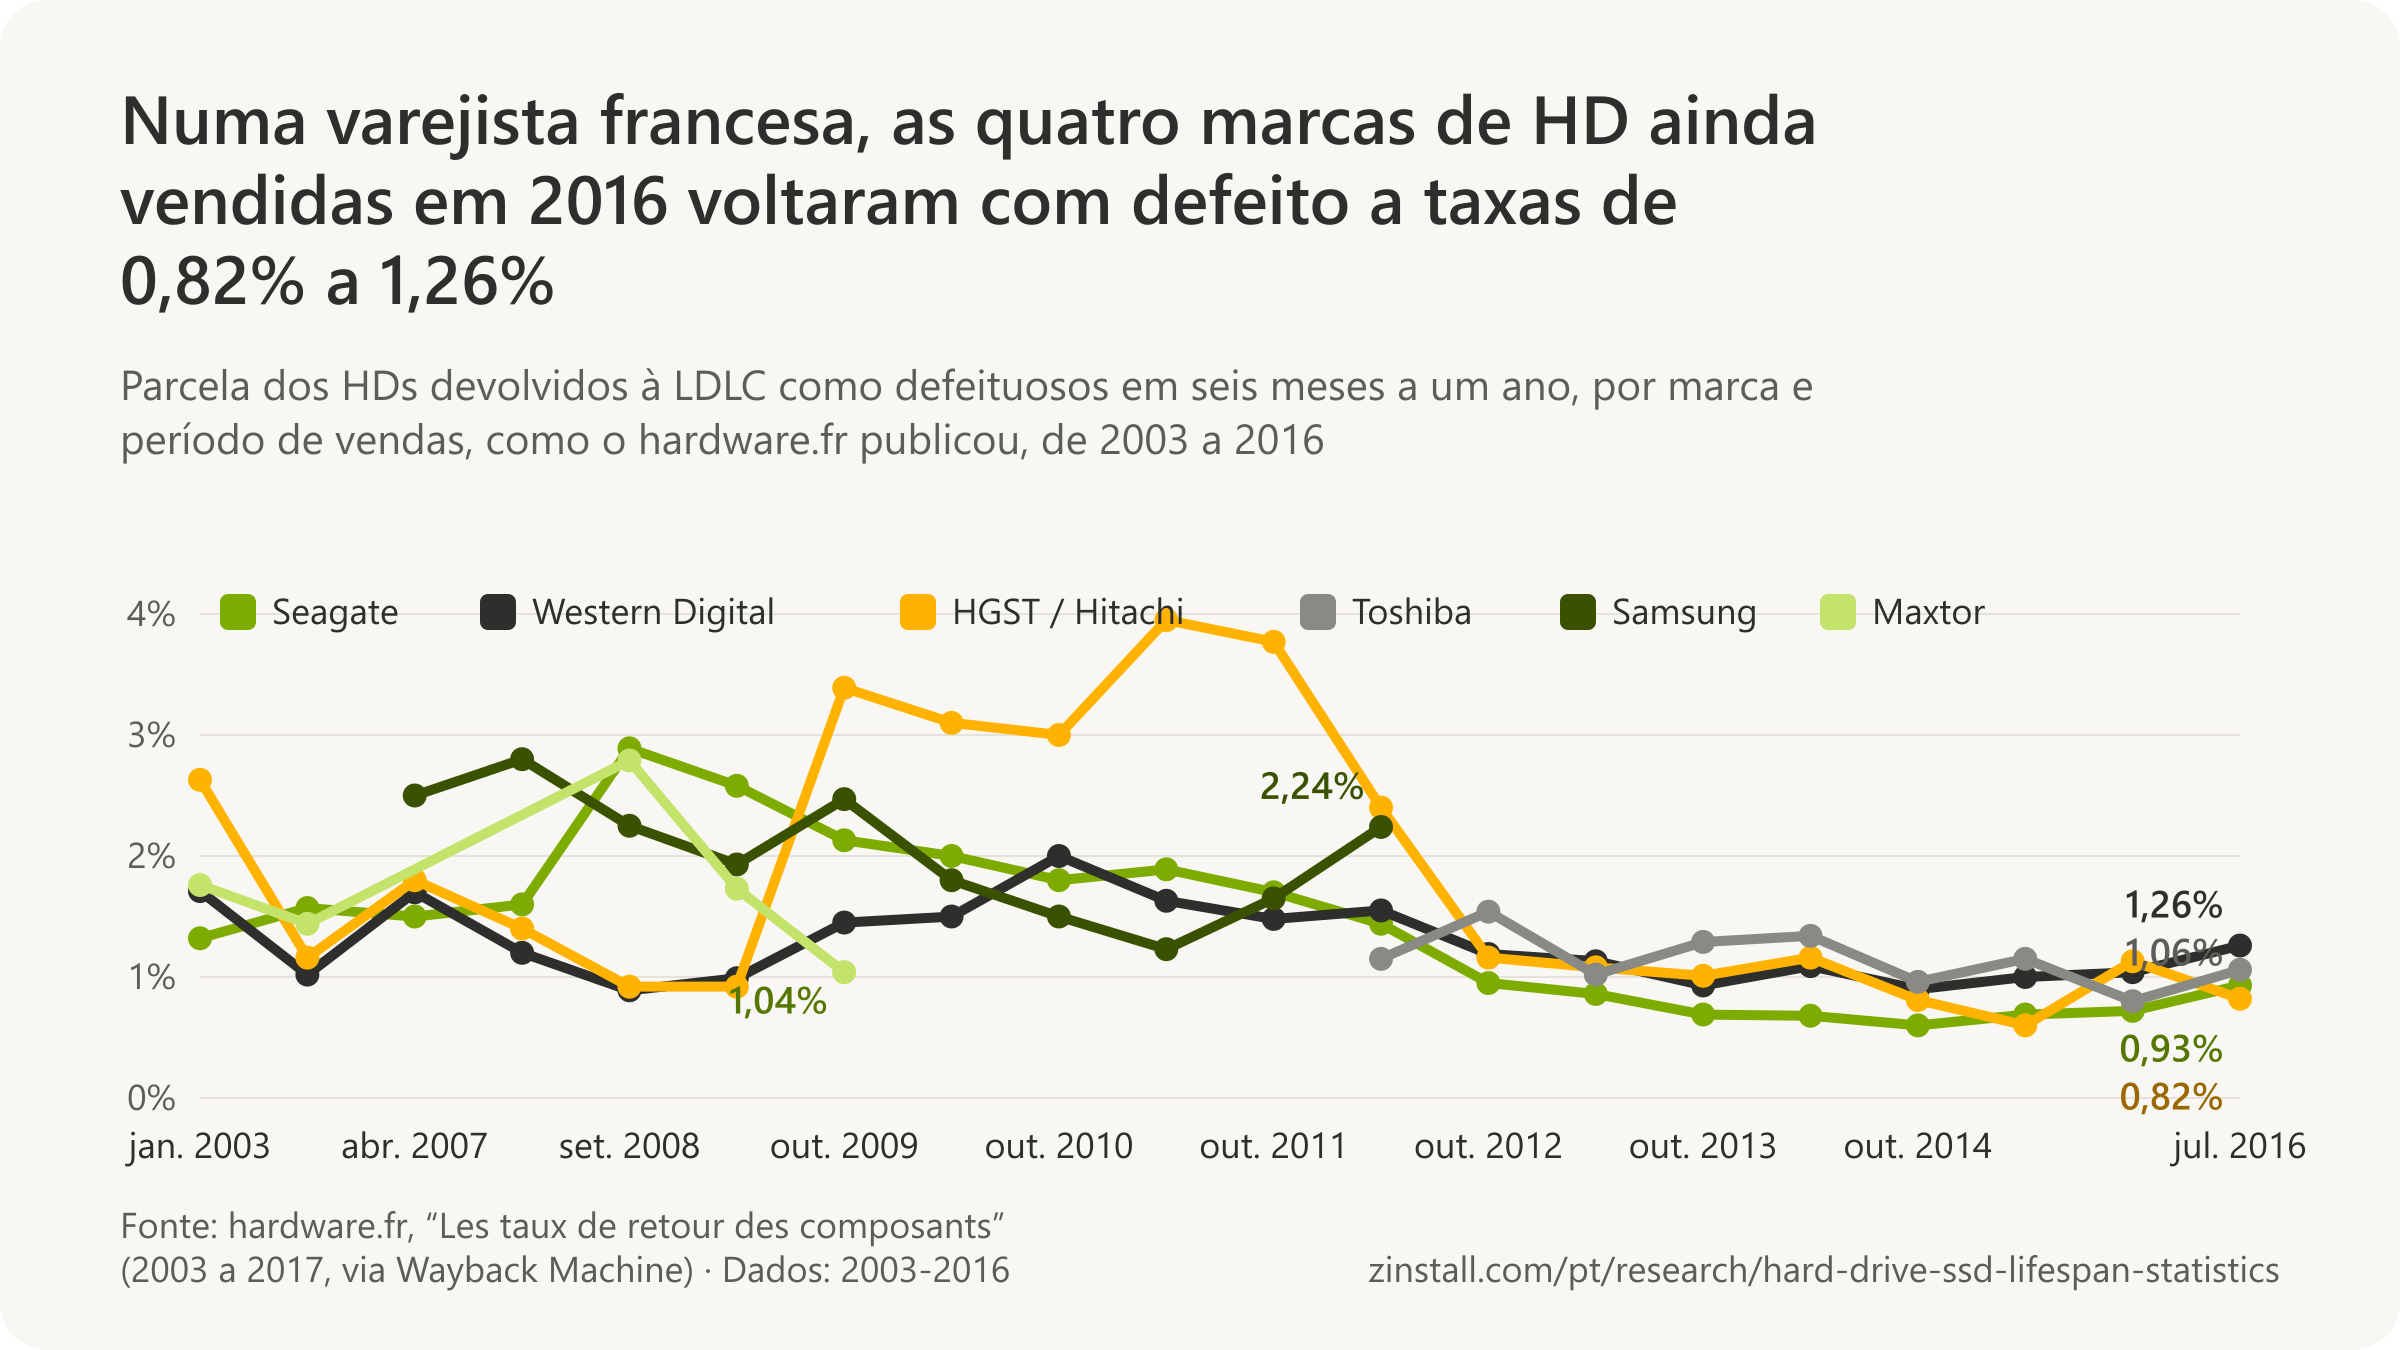
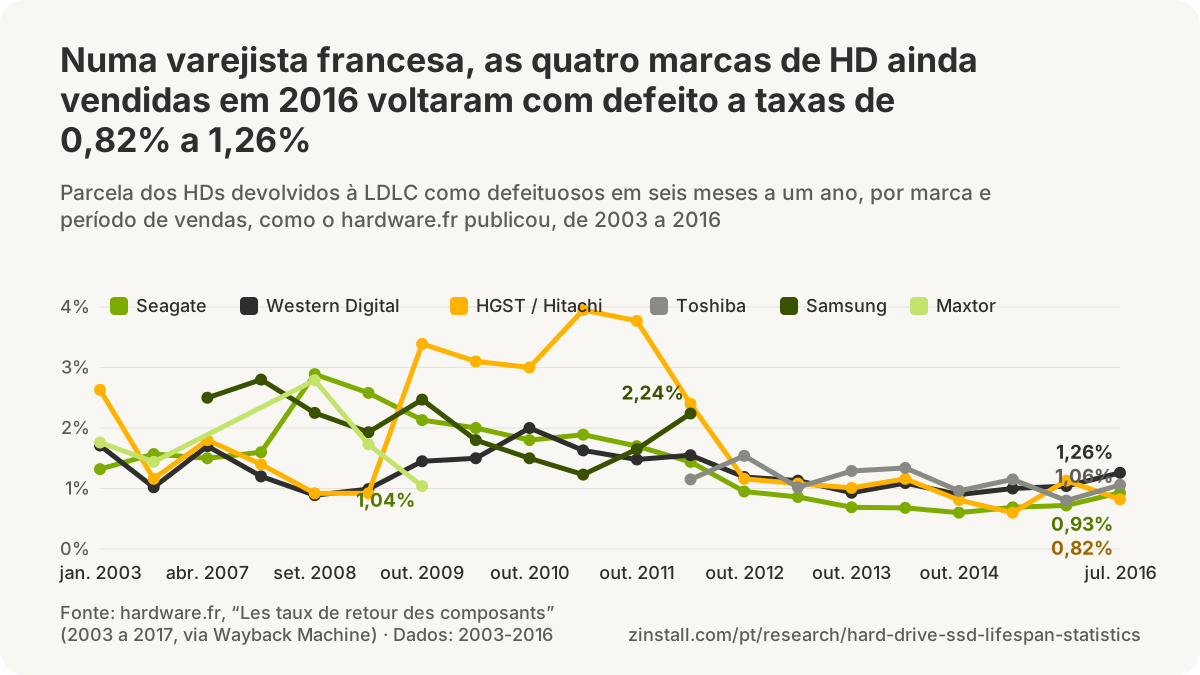

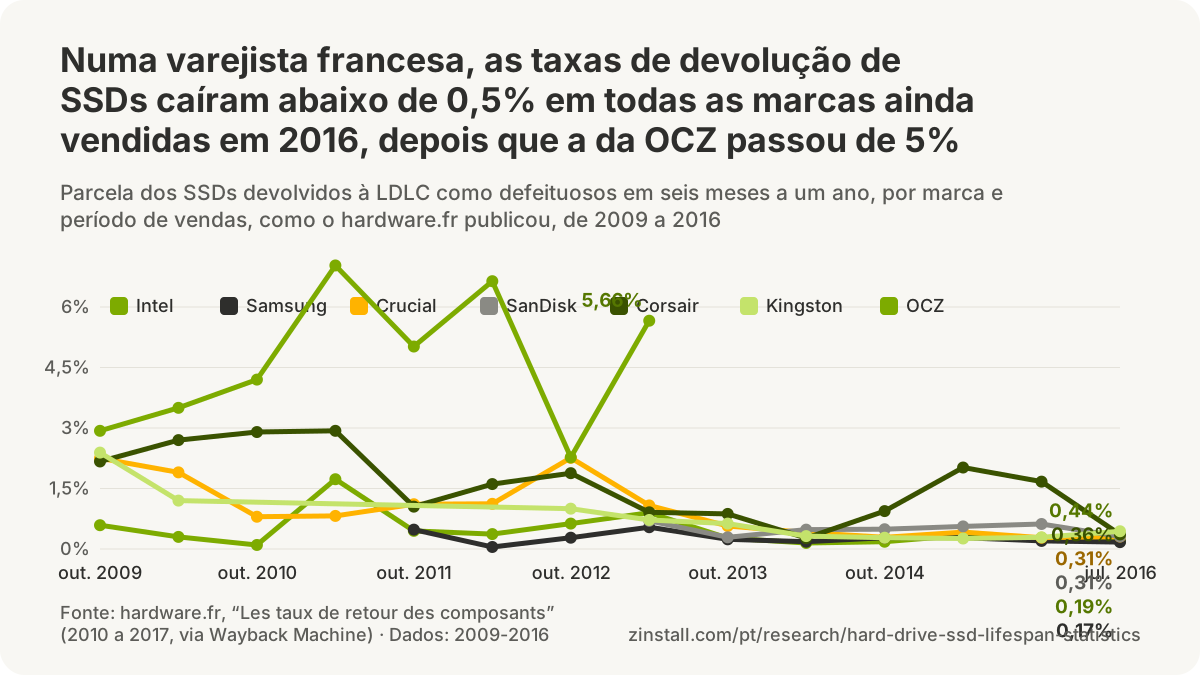
- 0,16% dos SSDs Plextor vendidos por uma grande varejista on-line francesa de abril de 2012 a outubro de 2012 foram devolvidos a ela como defeituosos em 6 a 12 meses de uso, pela contagem do hardware.fr (hardware.fr, 2013).
- 39% dos HDs Seagate Barracuda 7200.11 de 500GB vendidos por uma grande varejista on-line francesa de abril a setembro de 2009 foram devolvidos a ela como defeituosos em 6 a 12 meses, depois do bug de firmware do modelo (hardware.fr, 2010).
- 52,07% dos SSDs OCZ Octane SATA 2 de 128GB vendidos por uma grande varejista on-line francesa de abril a outubro de 2012 foram devolvidos a ela como defeituosos em 6 a 12 meses, assim como 45,26% dos OCZ Petrol de 128GB (hardware.fr, 2013).
- 10% dos HDs Seagate Desktop HDD de 6TB vendidos por uma grande varejista on-line francesa no segundo semestre de 2016 foram devolvidos a ela como defeituosos em até um ano, numa amostra de menos de 200 unidades, a pior unidade do último dossiê do hardware.fr (hardware.fr, 2017).
- 9,71% dos HDs WD Caviar Black de 2TB (WD2001FASS) vendidos por uma grande varejista on-line francesa de outubro de 2009 a abril de 2010 foram devolvidos a ela como defeituosos em 6 a 12 meses, o pior dos HDs de 2TB listados (hardware.fr, 2010).
- 1,9% dos 18.533 HDs IDE de 7200 rpm que a LDLC, uma grande varejista on-line francesa, vendeu nos primeiros meses de 2003 foram devolvidos a ela como defeituosos em no máximo 6 meses de uso, pela contagem do hardware.fr (hardware.fr, 2003).
As contagens de marcas dos laboratórios de recuperação
Fontes: Backblaze (2013-2026); University of Essex and Sungkyunkwan University; Seagate Technology (2022, 2026); Western Digital (2023, 2025); Toshiba Electronics Europe; Hardware.fr (2003-2017); Gillware Data Recovery
HDs e SSDs dão sinais antes de falhar?
23,3% dos HDs que falharam num parque de nuvem não deram nenhum aviso nos cinco atributos SMART monitorados (Backblaze, 2016).

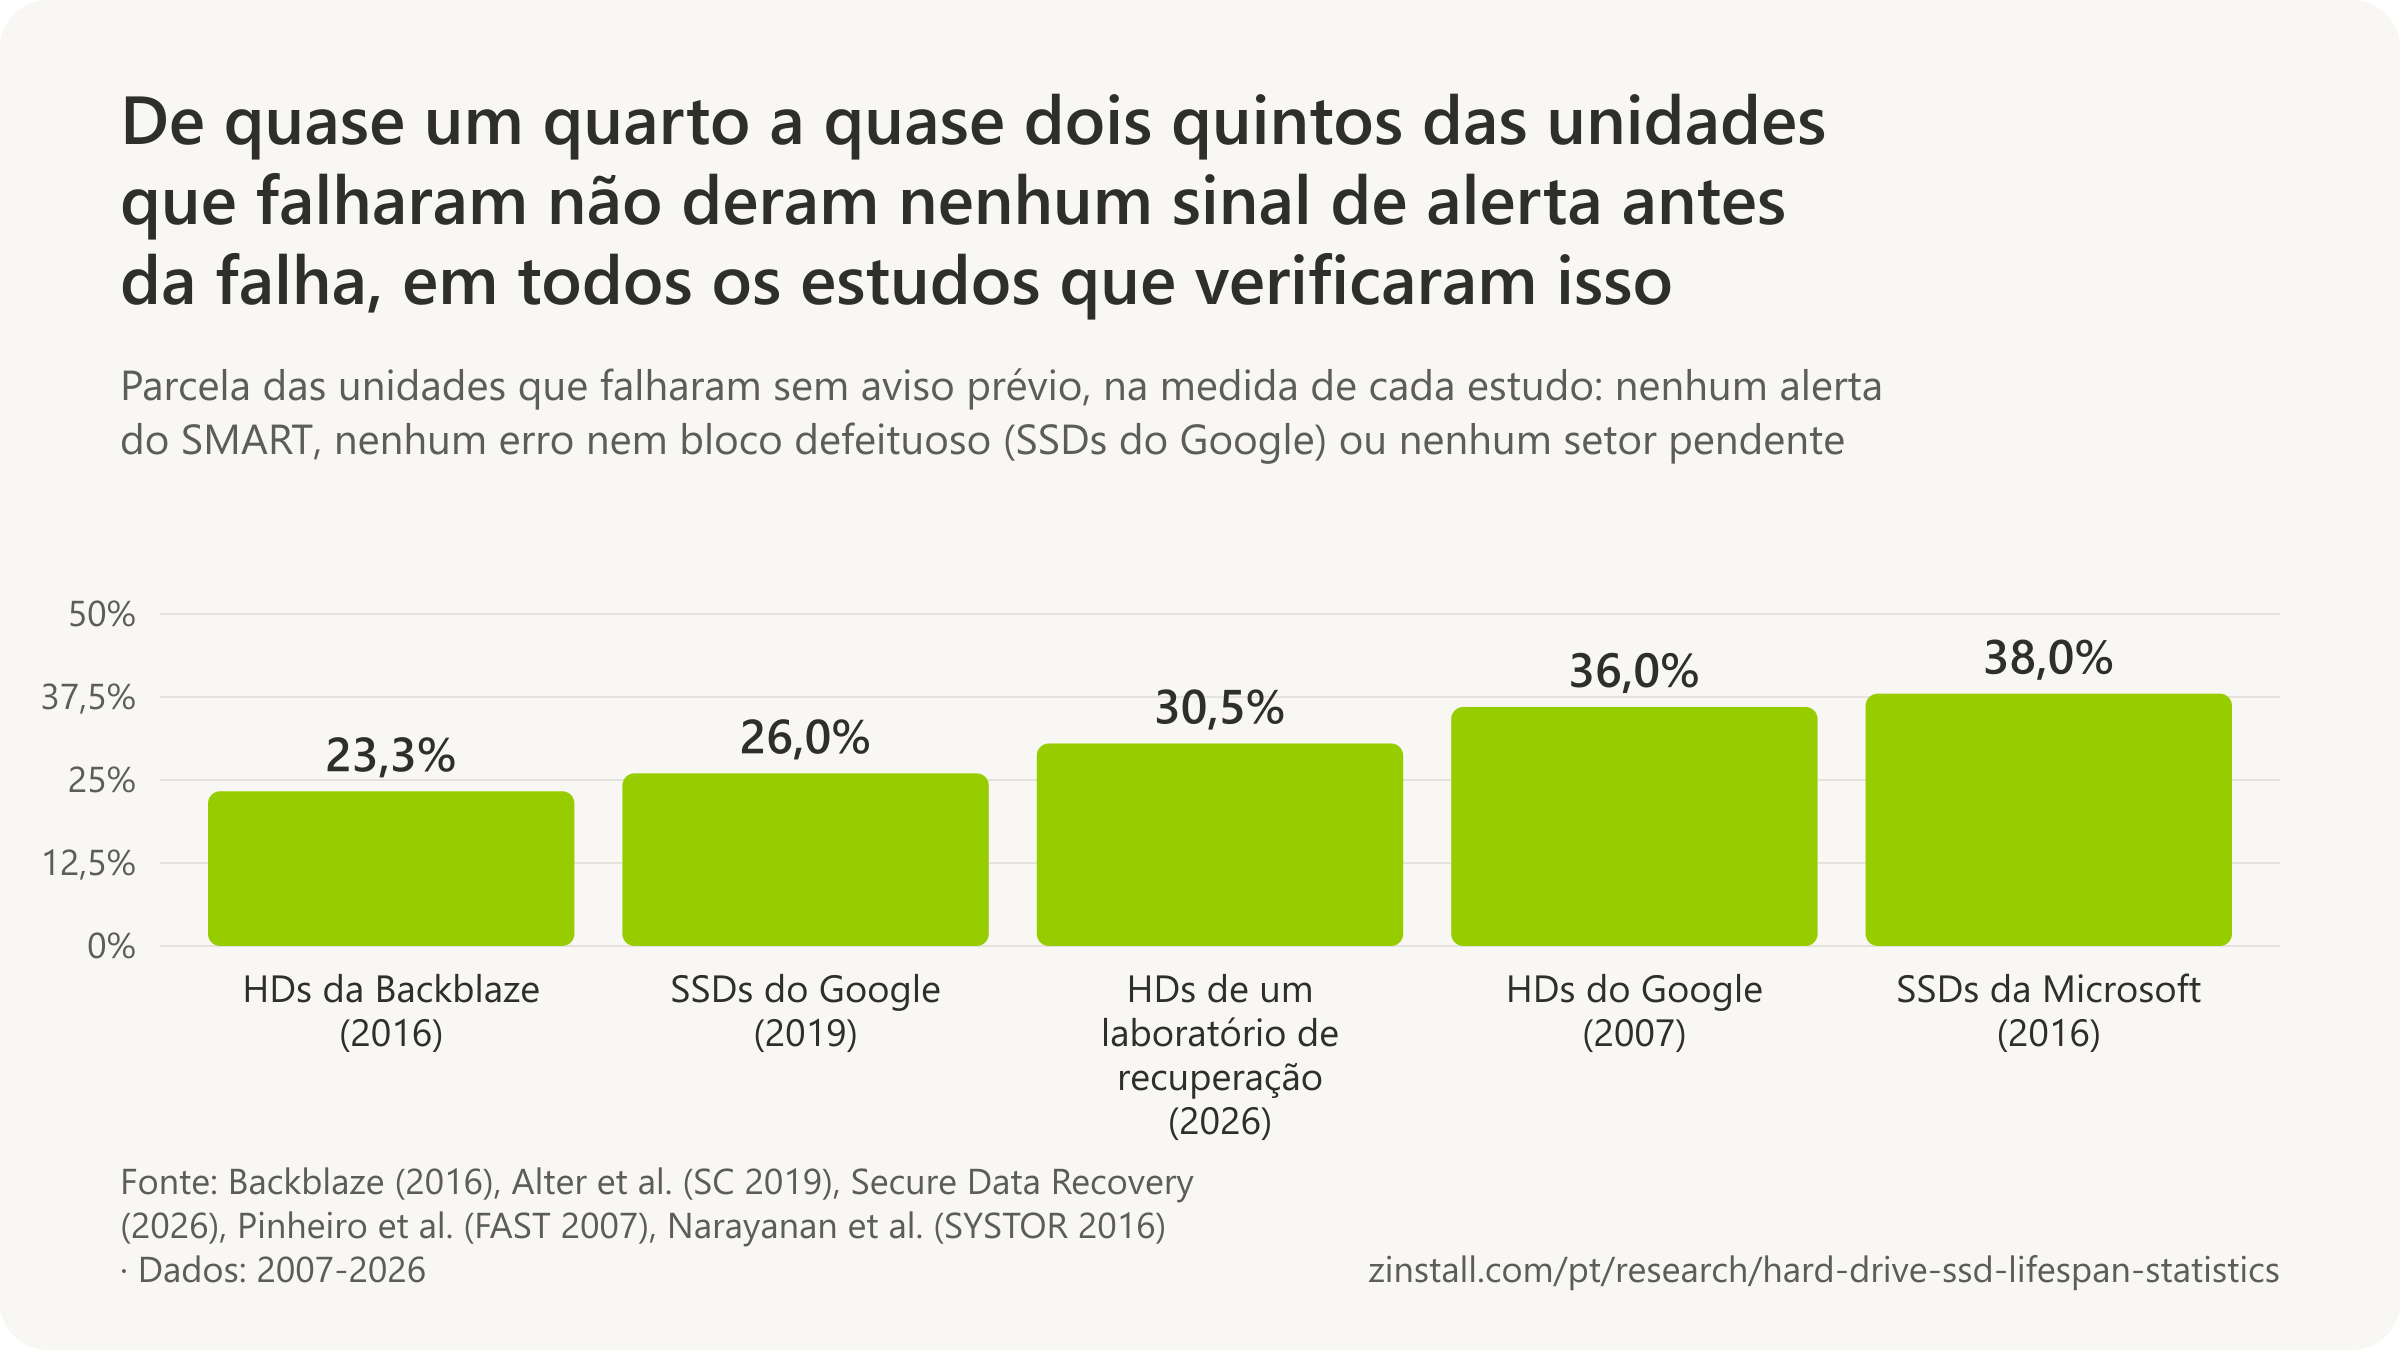
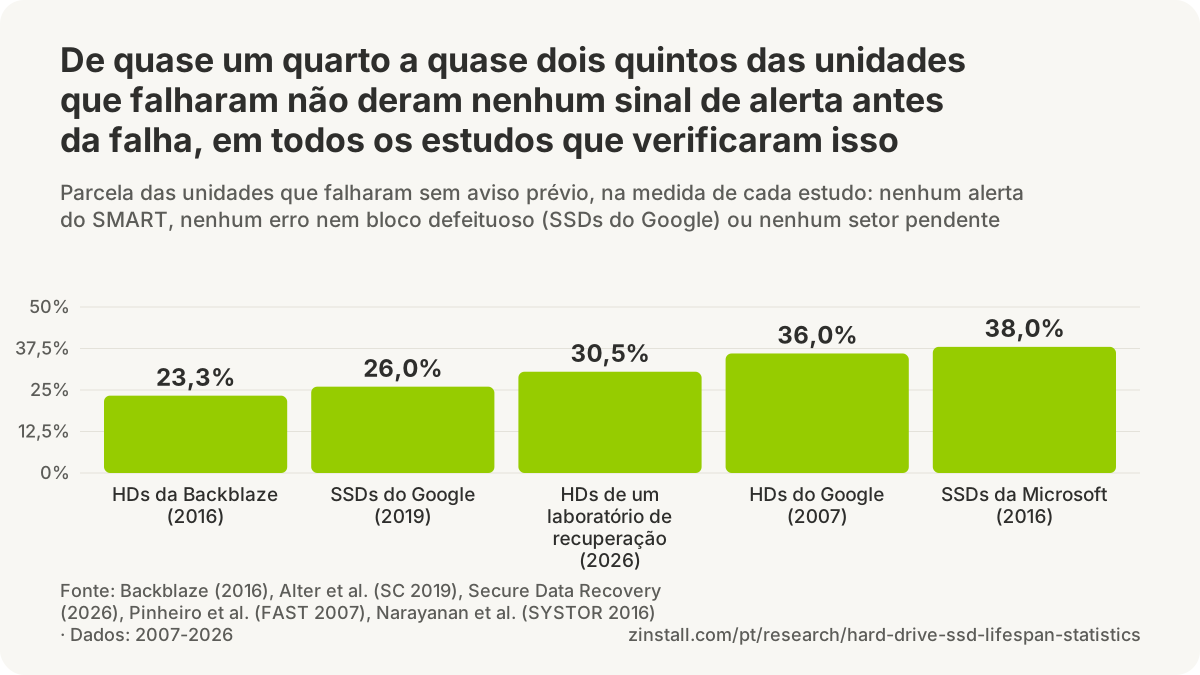
- 38% dos SSDs que falharam em grandes data centers não mostraram antes nenhum de quatro sinais de alerta do SMART (Narayanan et al., 2016).
- Depois do primeiro erro de varredura, um HD dos data centers do Google tinha 39 vezes mais chance de falhar em até 60 dias.
- Mais de 36% das unidades que falharam nos data centers do Google não tinham nenhum erro do SMART.
- 67,1% das unidades da NetApp com um setor ilegível aos 12 meses tinham desenvolvido outro aos 18 meses.
- Metade das unidades que acabaram falhando falhou em até dois dias depois de passar de 200 setores realocados, num modelo dos sistemas da EMC.
| Fonte e medida | Número |
|---|---|
| Backblaze: unidades que falharam e mostraram um aviso do SMART | 76,7% |
| Backblaze: unidades funcionando que mostram o mesmo aviso | 4,2% |
| Google: unidades que falharam sem nenhum dos quatro sinais mais fortes | mais de 56% |
| Google: depois de um primeiro setor realocado | mais de 14 vezes |
| IBM: substituições previstas com um mês de antecedência a partir de dados do SMART | 73-75% |
| Microsoft: SSDs com um sintoma do SMART contra os sem sintoma | 3 a 20 vezes |
| Google: SSDs que falharam sem erros nem blocos defeituosos antes | 26% |
| Um laboratório de recuperação dos EUA: unidades que falharam sem setores pendentes | 30,5% |
| Google: chance de um SSD ter outro erro incorrigível no mês seguinte | quase 30% contra 2% |
| NetApp: unidades que desenvolveram setores ilegíveis em 32 meses | 3,45% |
Fontes: Backblaze; ACM, Proceedings of the 9th ACM International Systems and Storage Conference; Google; NetApp and University of Wisconsin-Madison; EMC Corporation and Datrium; IBM Research Zurich; ACM / IEEE, Proceedings of the International Conference; Secure Data Recovery Services; USENIX, Proceedings of the 14th USENIX Conference on File and Storage Technologies
Guias relacionados: Mensagem “Windows detected a hard disk problem” · Um HD com setores defeituosos
Mais estatísticas (39)
Muitas vezes, mas não de forma confiável. O SMART, o automonitoramento que toda unidade informa, sinaliza com antecedência a maioria das unidades que estão falhando, e o primeiro setor defeituoso ou erro de varredura de uma unidade multiplica a chance de ela falhar em breve. Mas, em todos os grandes estudos, de um quarto a dois quintos das unidades que falharam não deram nenhum aviso, tanto HDs quanto SSDs.
Unidades que falharam sem dar aviso
- 76,7% dos HDs que falharam no data center da Backblaze tinham pelo menos um de cinco atributos SMART de alerta acima de zero, contra 4,2% das unidades em funcionamento (Backblaze, 2016).
- 4,2% dos HDs em funcionamento no data center da Backblaze mostravam pelo menos um dos cinco atributos SMART de alerta acima de zero (Backblaze, 2016).
- Mais de 56% dos HDs que falharam não tinham nenhuma contagem em nenhum dos quatro sinais SMART mais ligados à falha (erros de varredura, realocações, realocações offline, contagens em observação), nos data centers do Google (Google, 2007).
HDs: o que o SMART e os setores defeituosos preveem
- 47,0% dos HDs que falharam no data center da Backblaze tinham registrado gravações com a cabeça alta demais (high-fly writes, SMART 189), contra 16,4% das unidades em funcionamento (Backblaze, 2016).
- 5 das mais de 70 estatísticas SMART são as que a Backblaze usava em 2014 para marcar HDs para substituição, porque são consistentes entre os fabricantes e preveem falhas (Backblaze, 2014).
- Cerca de 40% dos HDs que falharam tinham uma contagem de setores realocados, o alerta SMART mais comum entre eles, à frente dos erros de busca (cerca de 30%) e das realocações offline (cerca de 27%), nos data centers do Google (Google, 2007).
- Os HDs tinham 39 vezes mais chance de falhar em até 60 dias depois do primeiro erro de varredura do SMART do que as unidades sem erros de varredura, nos data centers do Google (Google, 2007).
- Os HDs com um ou mais erros de varredura do SMART tinham dez vezes mais chance de falhar que as unidades sem esses erros, medida em taxas de falha anualizadas nos data centers do Google (Google, 2007).
- Pouco mais de 70% dos HDs ainda funcionavam oito meses depois do primeiro erro de varredura do SMART, nos data centers do Google (Google, 2007).
- Cerca de 9% dos HDs tinham contagem de setores realocados acima de zero, nos data centers do Google (Google, 2007).
- Os HDs tinham mais de 14 vezes mais chance de falhar em até 60 dias depois do primeiro setor realocado do que as unidades sem nenhum, nos data centers do Google (Google, 2007).
- Cerca de 85% dos HDs ainda funcionavam oito meses depois do primeiro setor realocado, nos data centers do Google (Google, 2007).
- Os HDs tinham mais de 21 vezes mais chance de falhar em até 60 dias depois da primeira realocação offline (um setor defeituoso encontrado pela varredura em segundo plano) do que as unidades sem nenhuma, nos data centers do Google (Google, 2007).
- Os HDs tinham 16 vezes mais chance de falhar em até 60 dias depois da primeira contagem em observação (setor suspeito) do que as unidades sem nenhuma, nos data centers do Google (Google, 2007).
- Mais de 50% dos HDs falharam depois que a contagem de setores realocados passou de 40, contra 1,7% das unidades sem nenhum setor realocado, num modelo SATA em appliances de backup da EMC (EMC, 2015).
- Metade dos HDs que acabaram falhando falhou em até dois dias depois que a contagem de setores realocados passou de 200, num modelo SATA em appliances de backup da EMC (EMC, 2015).
- De 73% a 75% das substituições de HDs foram previstas com um mês de antecedência a partir de dados do SMART pelo modelo da IBM, em dois modelos de unidade dos data centers da Backblaze (IBM Research, 2016).
- 3,45% dos HDs (53.820 de 1,53 milhão) desenvolveram pelo menos um setor ilegível (erro latente de setor) ao longo de 32 meses em sistemas de armazenamento da NetApp instalados em clientes (NetApp, 2007).
- 8,5% dos HDs nearline (ATA de classe desktop) desenvolveram setores ilegíveis ao longo de 32 meses, contra 1,9% das unidades de classe corporativa, em sistemas de armazenamento da NetApp (NetApp, 2007).
- 3,2% dos HDs nearline desenvolveram pelo menos um setor ilegível em até 12 meses após o envio, contra 1,5% das unidades de classe corporativa, em sistemas de armazenamento da NetApp (NetApp, 2007).
- Quase 20% das unidades de um modelo de HD nearline desenvolveram setores ilegíveis em até 24 meses após o envio, enquanto os modelos nearline variaram de 5% a 20% (NetApp, 2007).
- 67,1% dos HDs que tinham um setor ilegível até os 12 meses de idade desenvolveram pelo menos mais um até os 18 meses, enquanto apenas 1,8% de todas as unidades desenvolveram o primeiro nesse intervalo, em sistemas de armazenamento da NetApp (NetApp, 2007).
- Mais de 60% dos setores ilegíveis nos HDs foram encontrados pela varredura de mídia em segundo plano (scrubbing), e não por leituras dos usuários, em sistemas de armazenamento da NetApp que varrem cada unidade pelo menos a cada duas semanas (NetApp, 2007).
- 9,5% dos HDs nearline desenvolveram setores ilegíveis por ano, em média, contra 1,4% das unidades corporativas, em sistemas de armazenamento da NetApp (University of Wisconsin e NetApp, 2008).
- De 0,6% a 1,8% dos HDs desenvolveram setores ilegíveis por mês, conforme o modelo, entre 72.878 unidades de três modelos em sete data centers do Google (University of Toronto, 2012).
- 25,2% dos HDs Seagate ST3000DM001 de 3 TB tinham setores realocados, contra 0,24% a 11,8% em seis outros modelos comuns, entre as unidades da Backblaze analisadas pela Universidade de Toronto (University of Toronto, 2017).
SSDs: erros, blocos defeituosos e avisos


- 65% das falhas de HD num data center da Microsoft quente, mas seco, mostraram erros SMART de “pré-falha” (como setores realocados), 2% erros de “idade avançada” e 33% defeitos de controladora ou de conexão (Microsoft e Rutgers University, 2016).
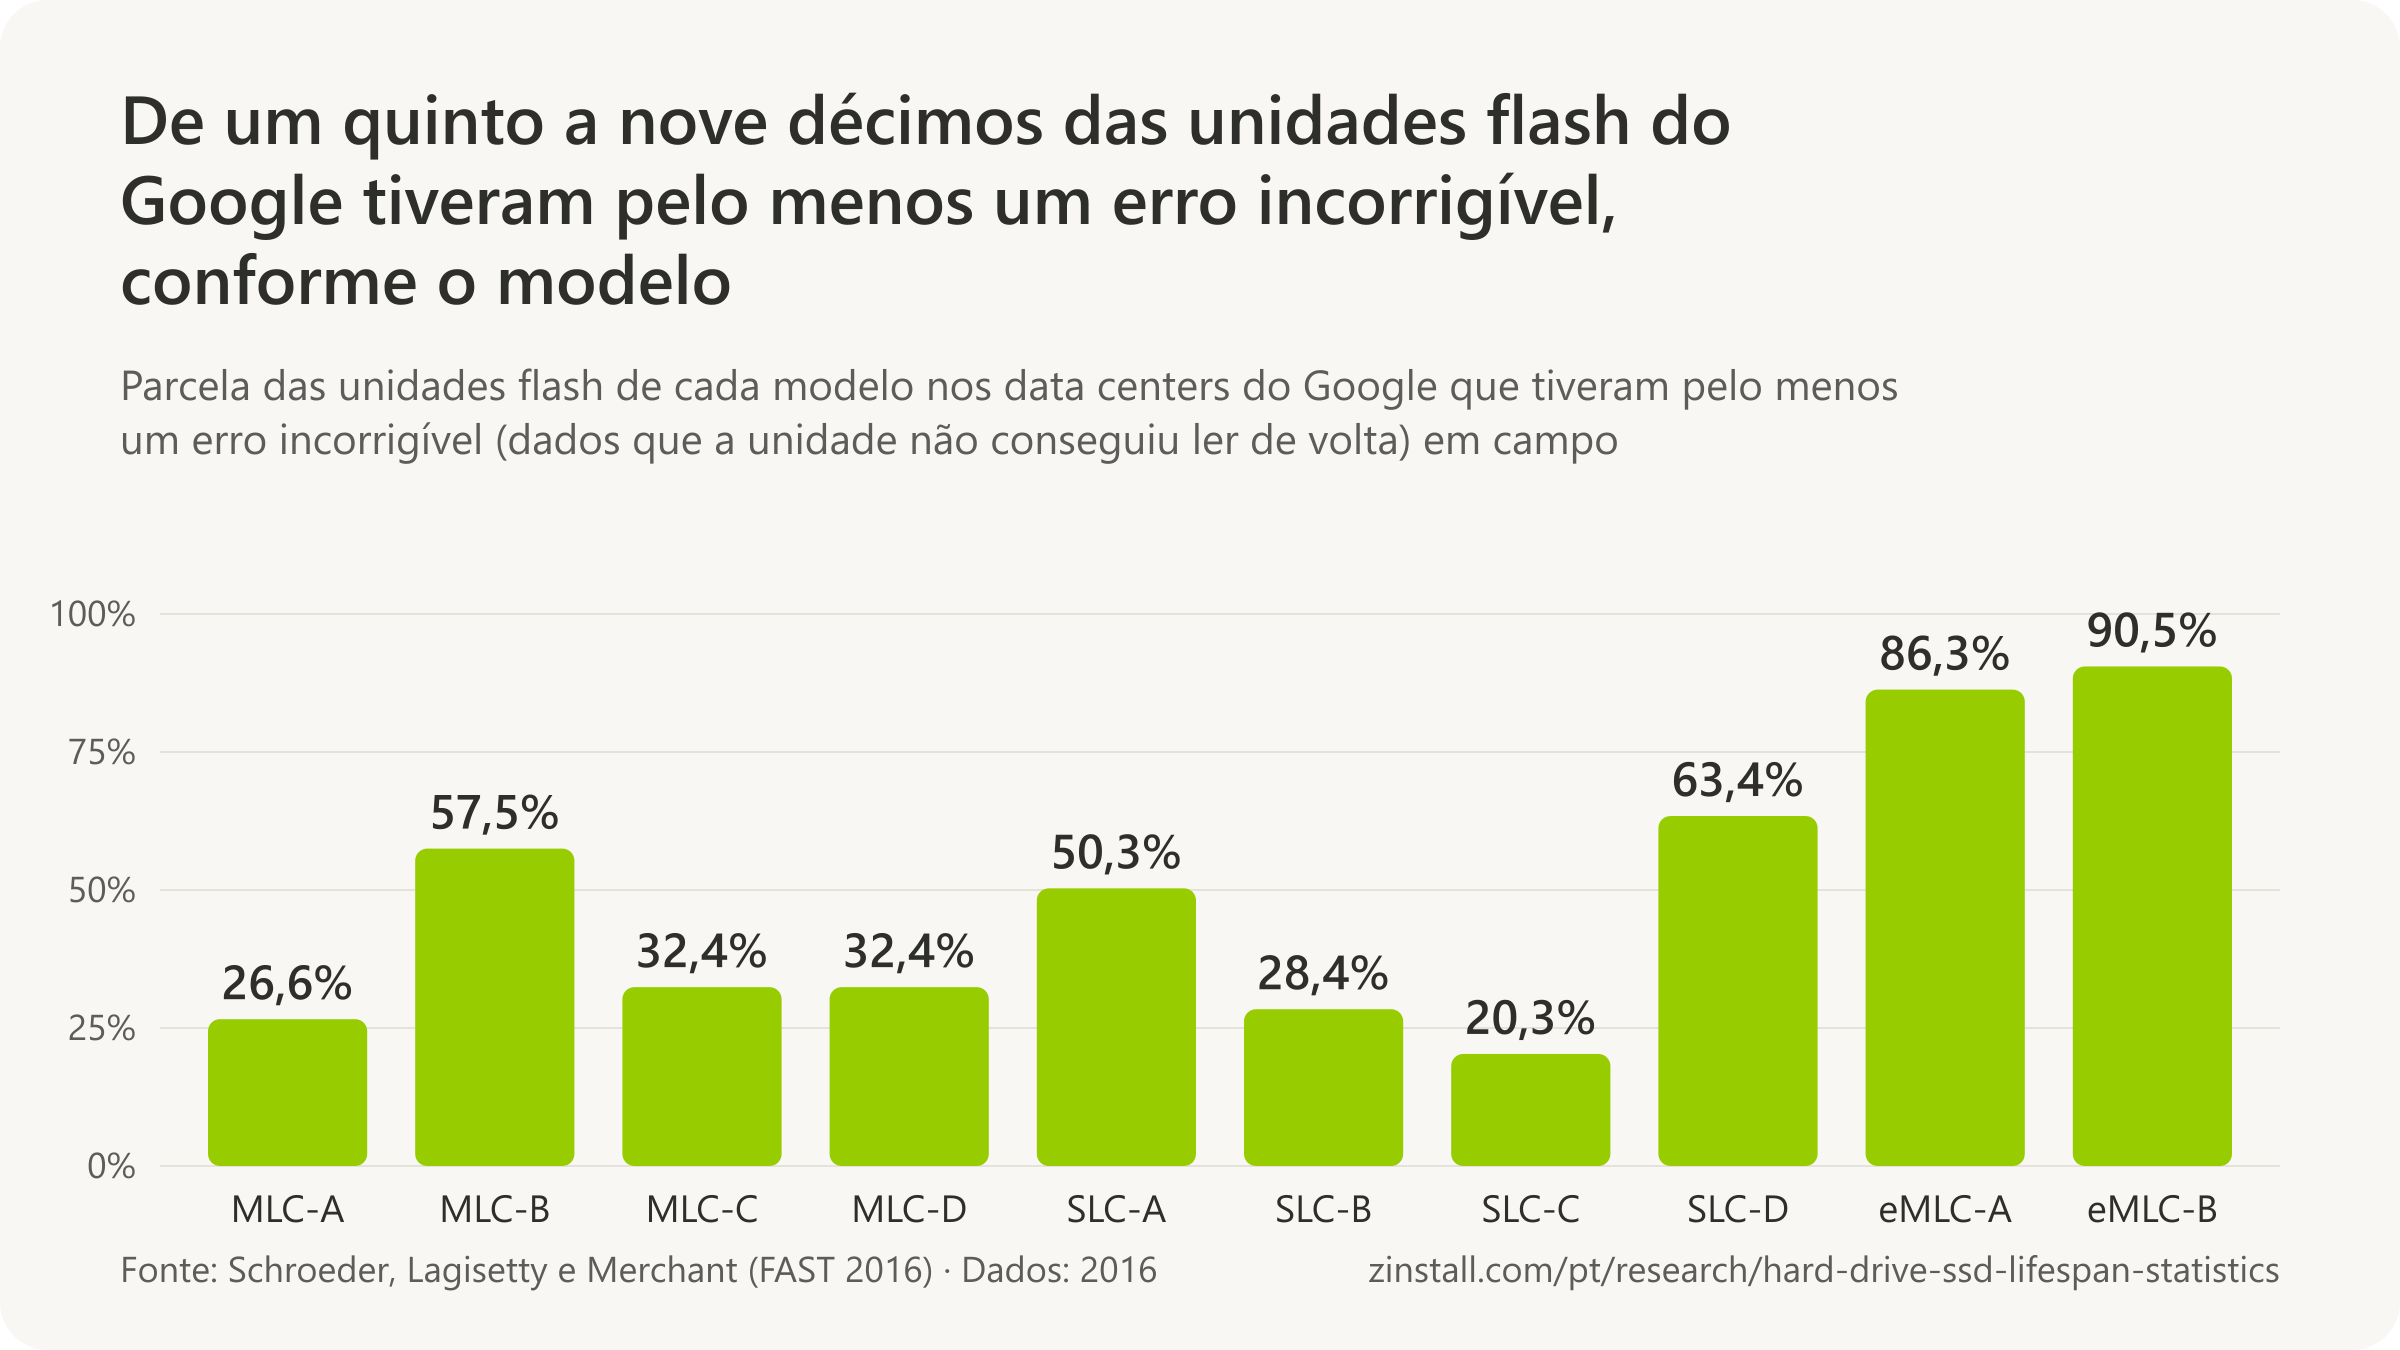
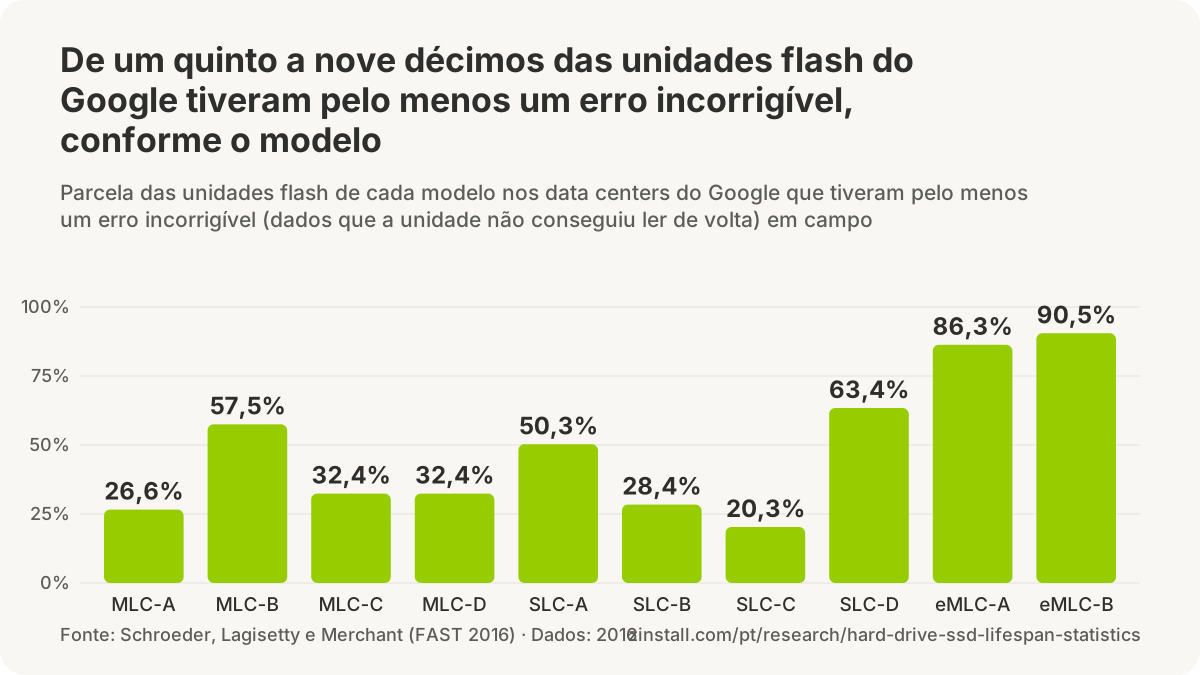
- Mais de 80% das unidades flash eMLC de classe corporativa mais novas nos data centers do Google desenvolveram erros incorrigíveis em campo, embora nenhuma os tivesse desenvolvido nos testes acelerados do Google antes de 15.000 ciclos de programação/apagamento (Schroeder et al., 2016).
- Em 2 a 6 de cada 1.000 dias de operação de uma unidade flash de data center do Google ocorreu um erro incorrigível, conforme o modelo (Schroeder et al., 2016).
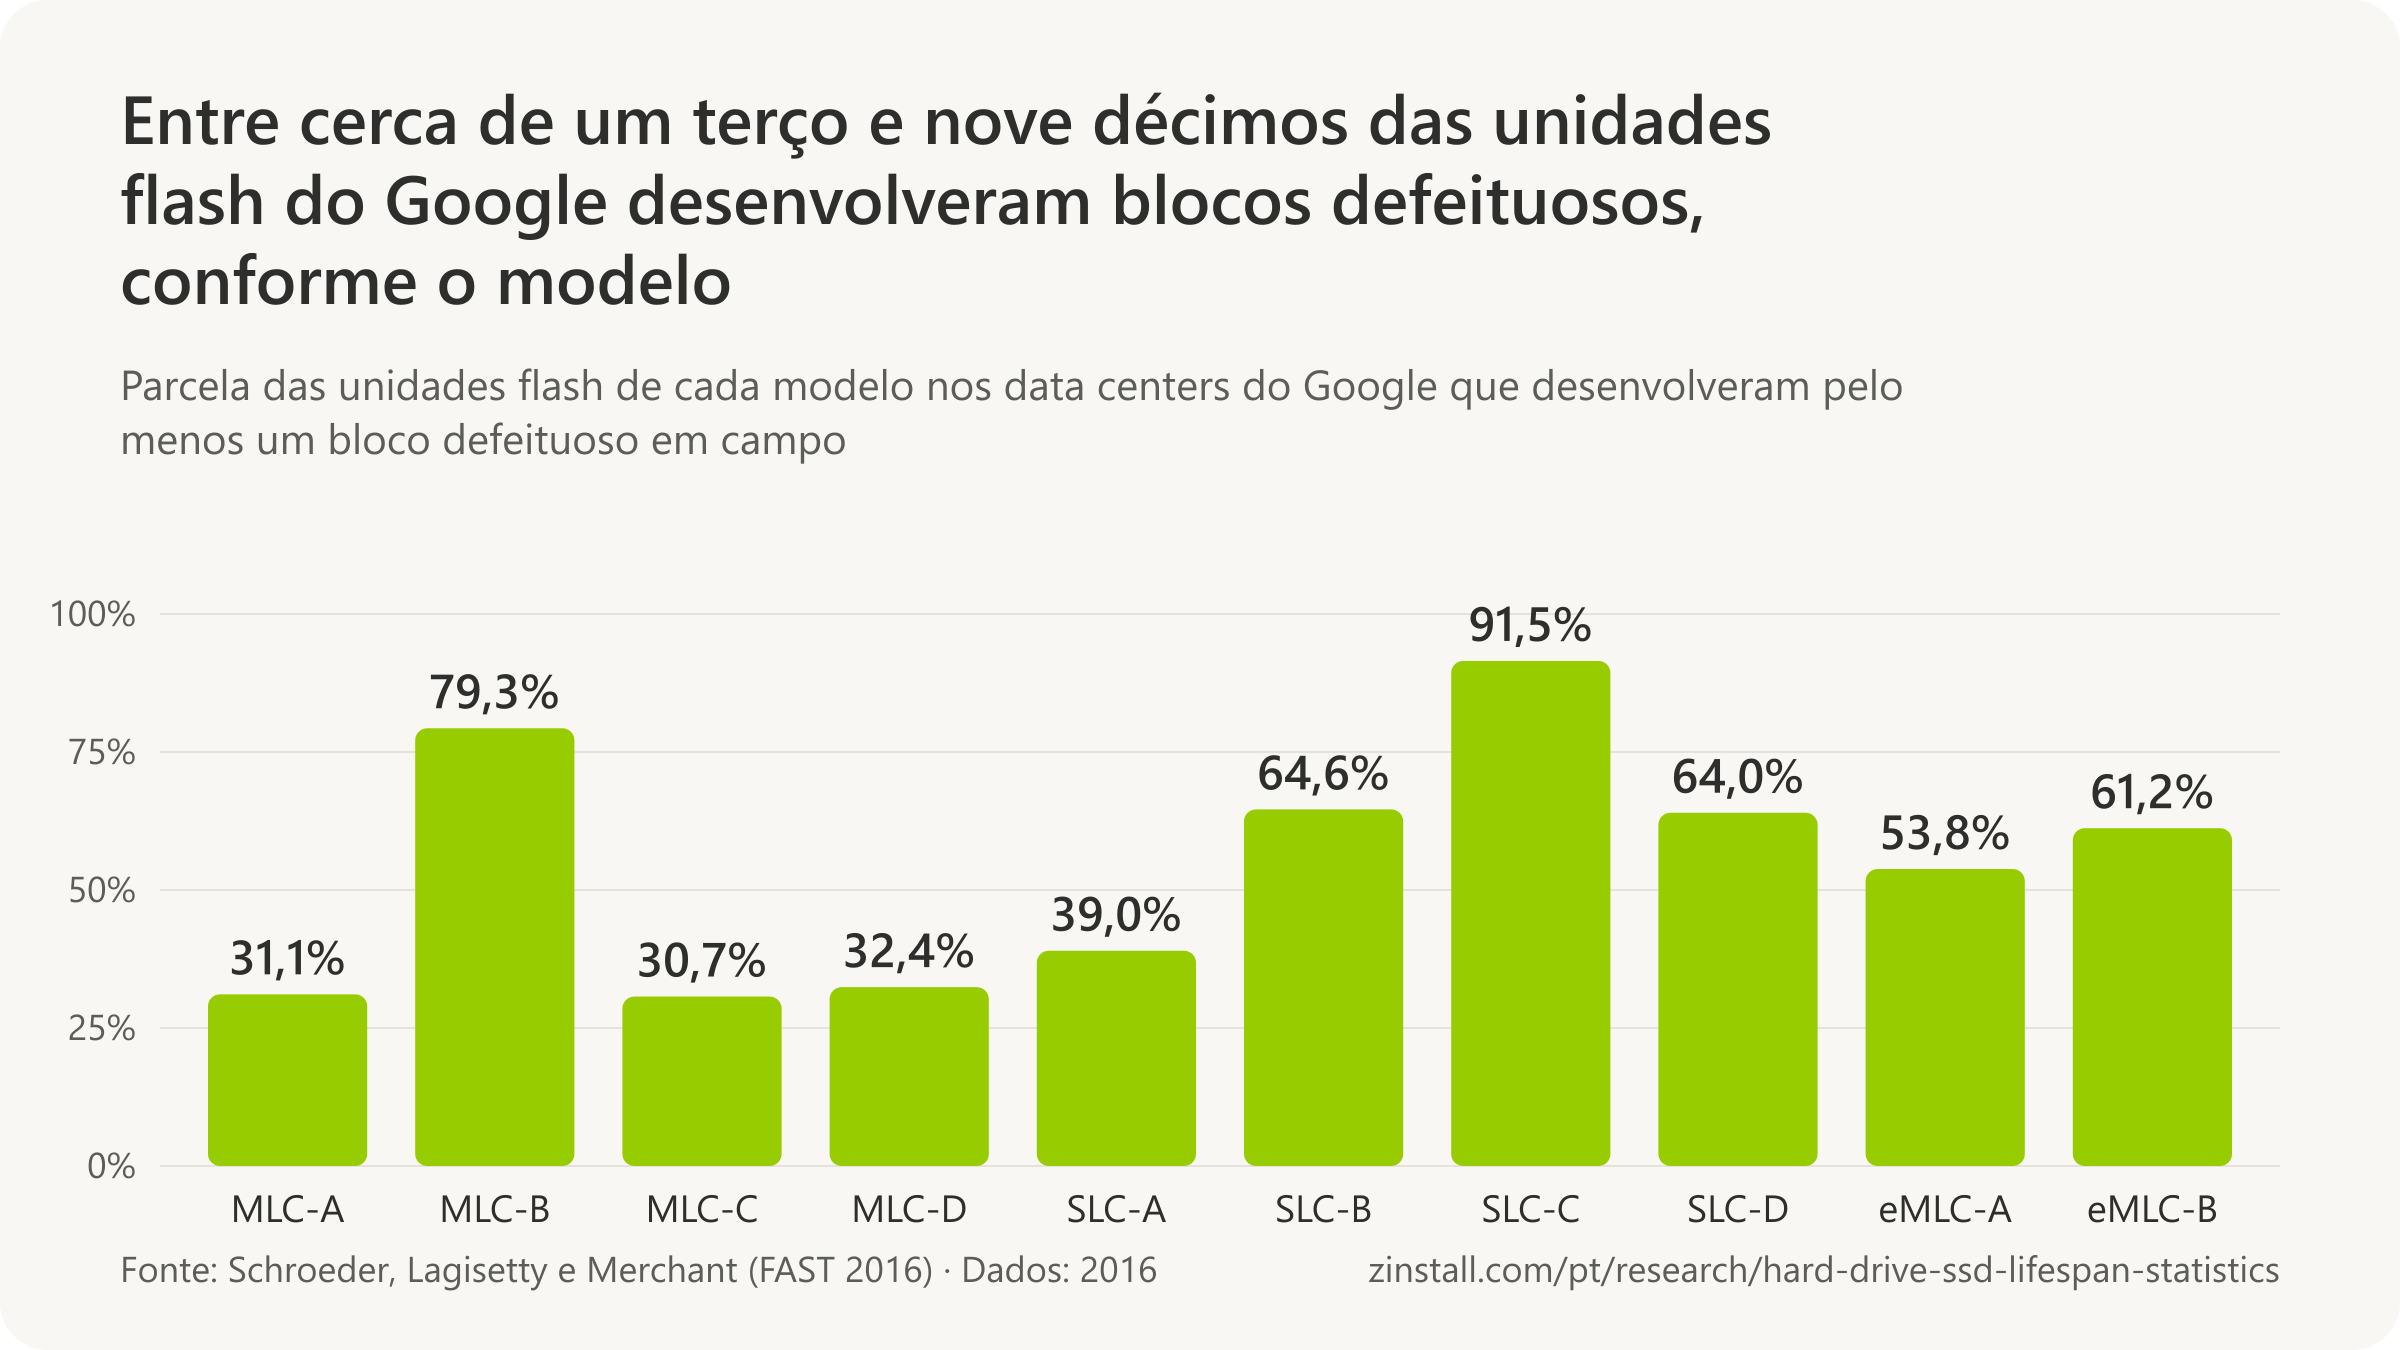
- Depois que 2 a 4 blocos defeituosos apareciam numa unidade flash dos data centers do Google, havia 50% de chance de que centenas de outros viessem em seguida (Schroeder et al., 2016).
- De 2% a 7% das unidades flash nos data centers do Google desenvolveram um chip de flash com falha nos primeiros quatro anos, conforme o modelo (Schroeder et al., 2016).
- De 6% a 9% das unidades flash da maioria dos modelos nos data centers do Google precisaram de reparo por um técnico em algum momento dos primeiros quatro anos, e de 26% a 30% nos dois piores modelos (Schroeder et al., 2016).
- Uma unidade flash de data center do Google tinha uma chance de quase 30% de ter um erro incorrigível no mês seguinte a um erro desse tipo, contra uma chance de 2% num mês qualquer (Schroeder et al., 2016).
- Cerca de dois terços dos chips de flash declarados defeituosos nas unidades dos data centers do Google tiveram falha em mais de 5% dos seus blocos, além da garantia dos fabricantes dos chips de no máximo 2% dentro dos ciclos de programação/apagamento nominais (Schroeder et al., 2016).
- De 4,2% a 34,1% dos SSDs flash nos servidores do Facebook tinham relatado pelo menos um erro incorrigível até novembro de 2014, conforme a plataforma de servidor (Meza et al., 2015).
- Os SSDs dos data centers da Microsoft que mostraram um sinal de alerta do SMART falharam com frequência 3 a 20 vezes maior que os que não mostraram, sendo os erros de dados o sinal mais forte (Narayanan et al., 2016).
- De 8% a 22% dos SSDs dos data centers da Microsoft falharam em até nove meses depois de relatar o primeiro erro de dados, conforme o modelo (Narayanan et al., 2016).
- Os SSDs corporativos nos sistemas de armazenamento da NetApp que tinham registrado nem que fosse um erro de bloco irrecuperável foram substituídos com frequência significativamente maior que os 99,04% de unidades que não tinham registrado nenhum (Maneas et al., 2020).
Fontes: Backblaze (2014, 2016); Google; EMC Corporation and Datrium; IBM Research Zurich; NetApp and University of Wisconsin-Madison; University of Wisconsin-Madison, NetApp and University of Toronto; University of Toronto, with Google data; University of Toronto and Microsoft Research; Rutgers University, GoDaddy and Microsoft; USENIX, Proceedings of the 14th USENIX Conference on File and Storage Technologies; ACM, Proceedings of the 2015 ACM SIGMETRICS International Conference on Measurement and Modeling of Computer Systems; ACM, Proceedings of the 9th ACM International Systems and Storage Conference; USENIX, Proceedings of the 18th USENIX Conference on File and Storage Technologies; USENIX, Proceedings of the 2019 USENIX Annual Technical Conference
O que faz os HDs falharem mais cedo?
Cada 1 °C a mais de temperatura da unidade elevou a taxa de falha em 2,1%, em 443.156 unidades de data center (University of Essex, 2026).

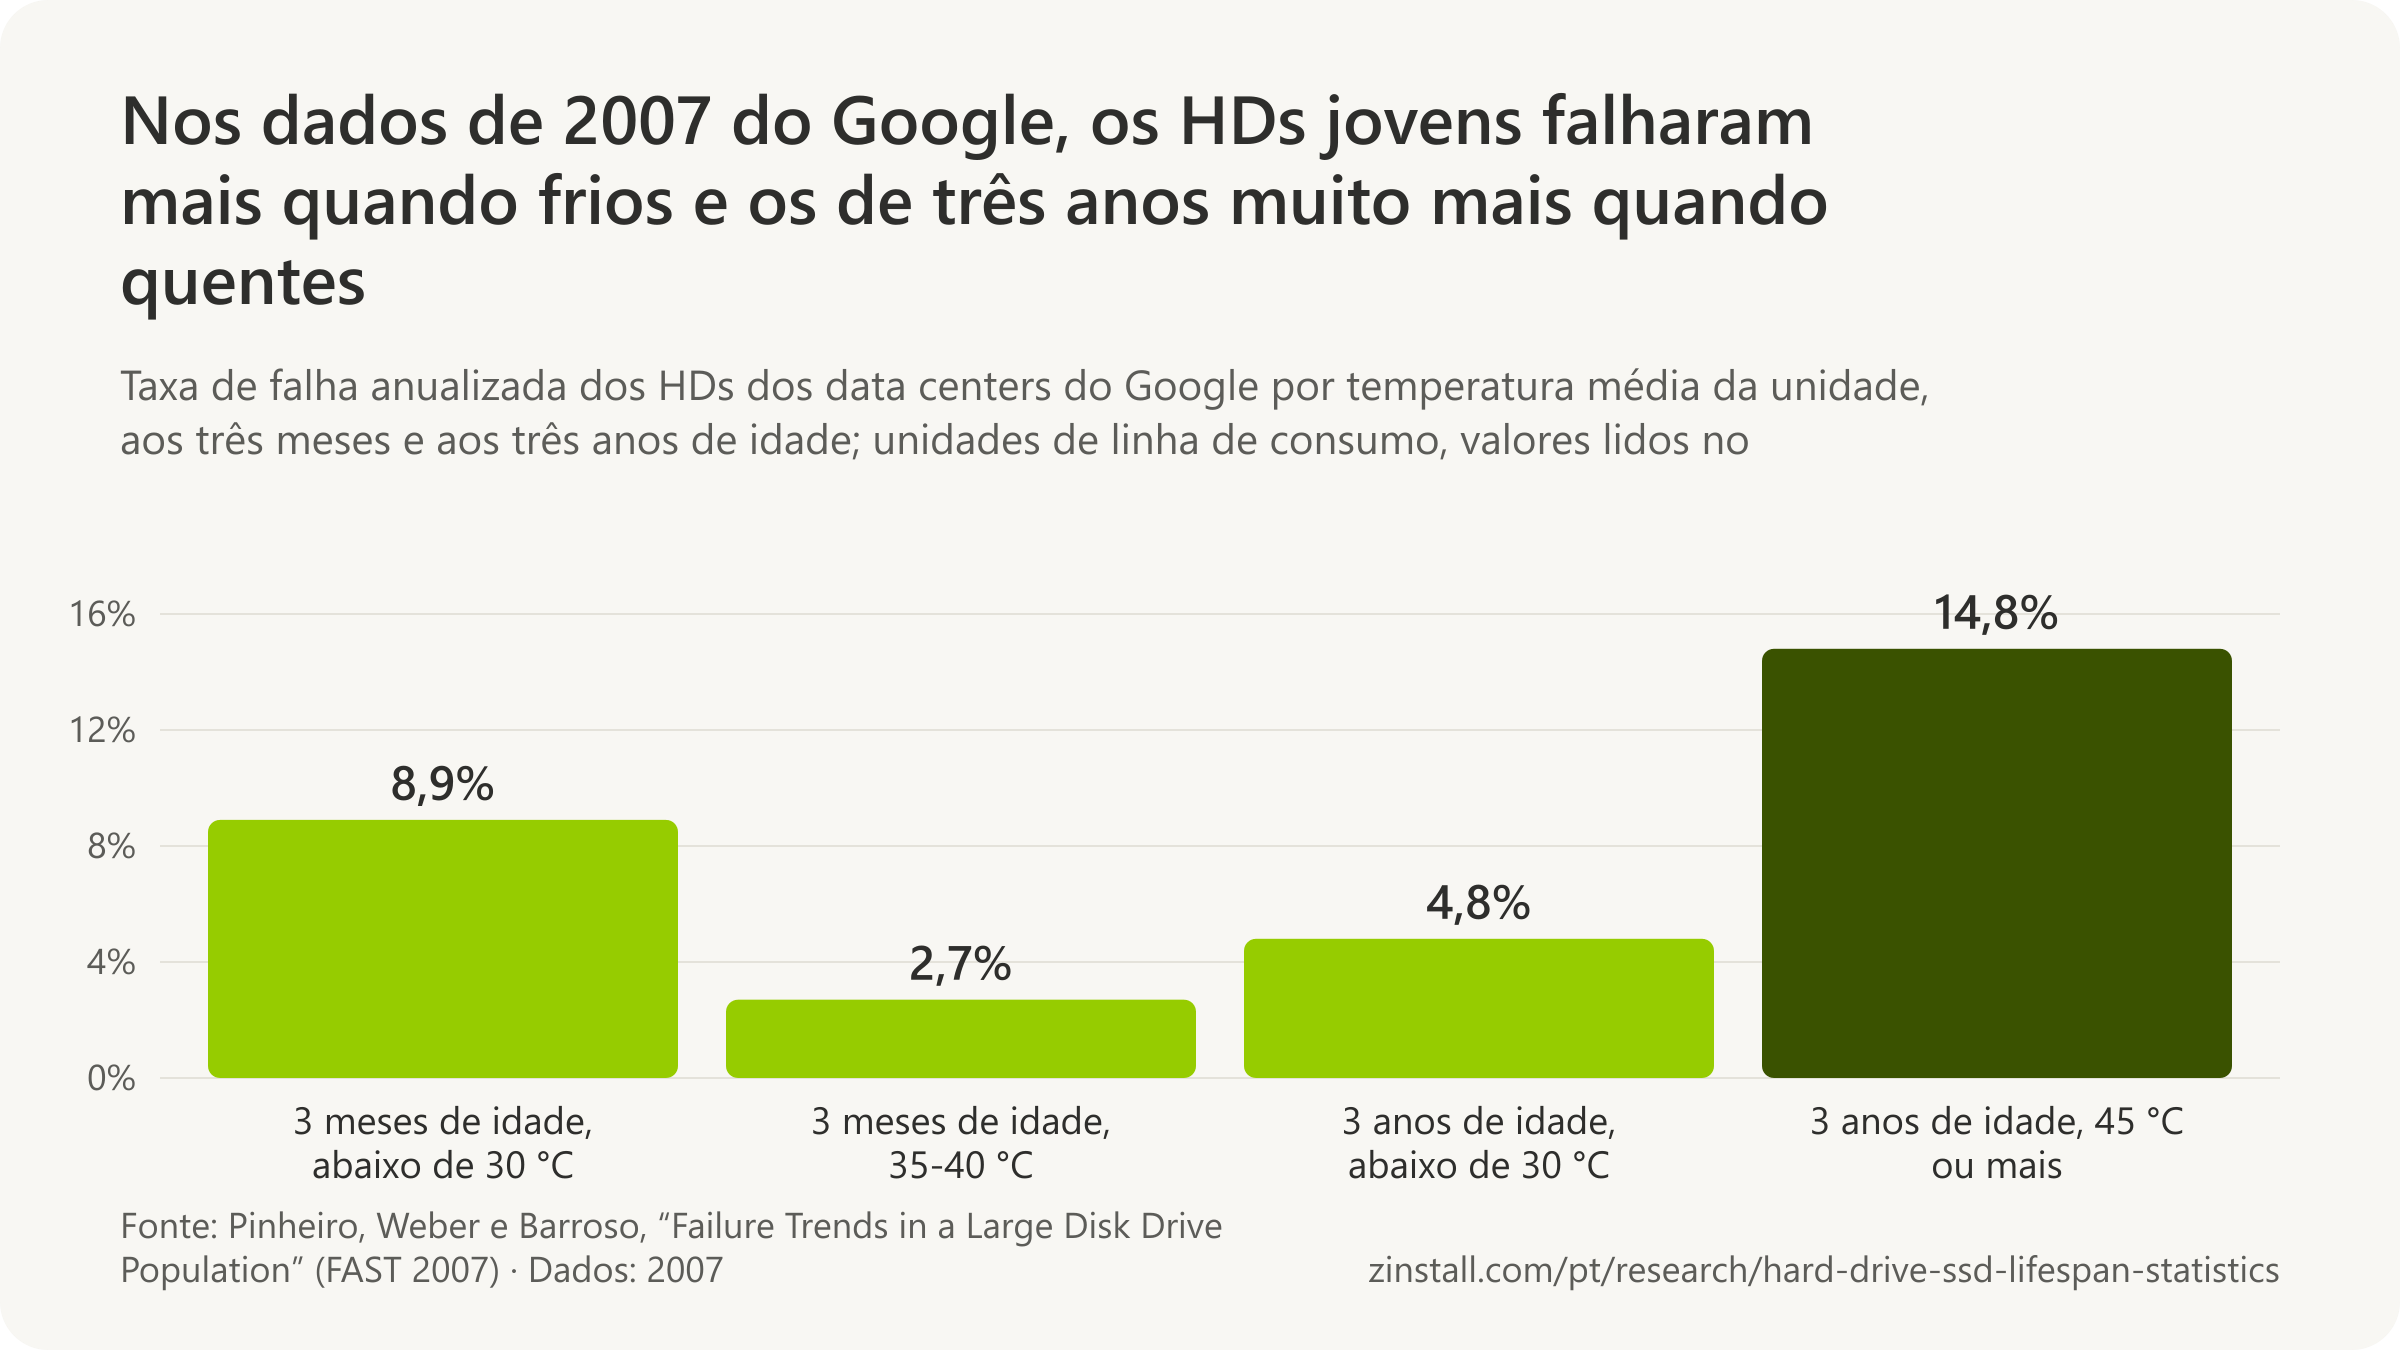
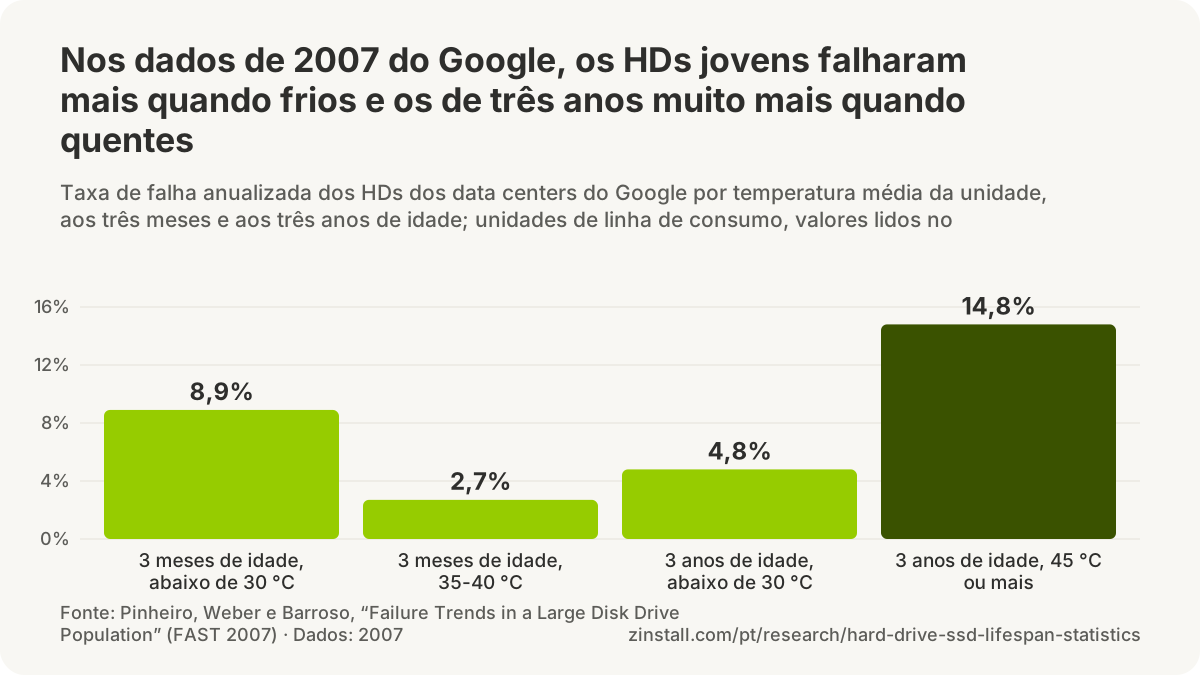
- Os HDs falharam até 260% mais em data centers úmidos, resfriados com ar externo, do que num data center seco.
- As unidades novas muito usadas dos data centers do Google falharam a cerca de 10,4% ao ano nos primeiros três meses, e as pouco usadas a 3,8%.
- De 63% a 66% das unidades com falha de três modelos nos sistemas da EMC falharam no quarto ano: unidades instaladas juntas falharam juntas.
- Um som de 110 decibéis ou mais pode danificar HDs, e um bico de supressão de incêndio chega a cerca de 130.
- 81,97% dos casos de HD num laboratório de recuperação dos EUA envolveram danos físicos, contra 18,03% de problemas de software.
| Fonte e constatação | Número |
|---|---|
| Backblaze: correlação entre temperatura e falha, 2014 | 0,0 |
| Toronto: aumento das falhas mensais por grau, 2012 | 0,001 ponto por °C |
| Microsoft: falhas de controladora ou de conexão num local úmido | 66% |
| Carnegie Mellon: duas falhas no intervalo de uma hora, em comparação com o modelo | 4 vezes |
| Facebook: o segundo SSD de um servidor também falhou | 39,8-59,9% |
| NetApp: um segundo SSD substituído no mesmo grupo RAID em até uma semana | 9,39% (mais de 180 vezes o normal) |
| Backblaze: unidades em servidores de armazenamento mais antigos contra mais novos | 0,99% |
| Microsoft: o mesmo modelo de SSD em dois projetos de servidor | 14 vezes |
| Gillware: casos de recuperação com falha mecânica | 48,7% |
| ING, Bucareste: data center fora do ar após um teste do sistema de supressão de incêndio | 10 horas |
Fontes: University of Essex and Sungkyunkwan University; Rutgers University, GoDaddy and Microsoft; Google; EMC Corporation and Datrium; Siemens AG, released; Secure Data Recovery Services; Backblaze (2024, 2014); University of Toronto, with Google data; Carnegie Mellon University; ACM, Proceedings of the 2015 ACM SIGMETRICS International Conference on Measurement and Modeling of Computer Systems; USENIX, Proceedings of the 18th USENIX Conference on File and Storage Technologies; ACM, Proceedings of the 9th ACM International Systems and Storage Conference; Gillware Data Recovery; Motherboard, quoting ING Bank Romania's press release and spokeswoman
Guias relacionados: Mensagem “Windows detected a hard disk problem” · Backup em um HD externo
Mais estatísticas (45)
Calor, umidade, uso intenso e o servidor em volta da unidade mudaram as taxas de falha nos grandes estudos, embora nem sempre na direção esperada: nos dados do Google, as unidades jovens falharam mais quando estavam frias. As falhas também vêm em lotes, já que unidades compradas juntas tendem a falhar juntas. Os laboratórios de recuperação, que veem as unidades que as pessoas lhes enviam, encontram principalmente danos físicos: cabeças com defeito, setores defeituosos e pratos danificados.
Temperatura e umidade
- 0,0 foi a correlação que a Backblaze encontrou entre a temperatura de operação e a falha em mais de 34.000 HDs de data center (Backblaze, 2014).
- 34,6% das unidades de um modelo Seagate de 1,5TB falharam por ano quando funcionavam mais quentes que a média do modelo, contra 15,6% quando mais frias, o único efeito claro do calor no estudo de 2014 da Backblaze (Backblaze, 2014).
- 354 das 259.533 unidades de dados da Backblaze passaram da temperatura máxima do fabricante por pelo menos um dia no verão recorde de calor de 2023 no hemisfério norte, e 2 delas falharam no trimestre (Backblaze, 2023).
- Cerca de um milésimo de por cento a mais de HDs por mês devia falhar para cada 1 °C de aumento da temperatura abaixo de 50 °C, contra taxas mensais típicas de falha de 0,1% a 0,2%, nos data centers do Google (University of Toronto, 2012).
- As oscilações de temperatura tiveram uma ligação mais forte e mais consistente com o surgimento de setores ilegíveis nos HDs do que a temperatura média, nos três modelos de unidade estudados em data centers do Google (University of Toronto, 2012).
- Os HDs em data centers úmidos da Microsoft com free cooling tiveram uma taxa de falha anualizada até 260% maior (5,4% contra 1,5%) do que num data center seco resfriado por chillers, enquanto os locais quentes, mas secos, ficaram perto de 2% (Microsoft e Rutgers University, 2016).
- 66% das falhas de HD num data center úmido da Microsoft com free cooling foram falhas da placa controladora ou de conexão, contra 33% num data center quente, mas seco, o que os autores associam à condensação e à corrosão (Microsoft e Rutgers University, 2016).
- Cada 1 °C a mais de temperatura média da unidade elevou a taxa de falha em 2,1%, ou cerca de 23% para 10 °C, em 443.156 HDs dos data centers da Backblaze (University of Essex e Sungkyunkwan University, 2026).
- Os SSDs flash mais quentes falharam com mais frequência nos servidores do Facebook, mas as unidades que reduziam o próprio desempenho (throttling) quando esquentavam evitaram em grande parte esse efeito (Meza et al., 2015).
- SSDs ociosos aquecidos em até 28 °C por unidades vizinhas ocupadas nos racks da Alibaba mostraram 57% mais erros de dispositivo depois de 128 horas nos testes da Alibaba (Xu et al., 2019).
Carga de trabalho e ciclos de liga/desliga
- 27,7 ciclos de liga/desliga, em média, tinham sido registrados pelos HDs com falha da Backblaze, contra 10,2 das suas unidades em funcionamento, uma ligação que a Backblaze disse ainda não conseguir explicar (Backblaze, 2016).
- Cerca de 10,4% dos HDs muito usados falharam nos primeiros três meses, em base anualizada, contra cerca de 3,8% das unidades pouco usadas, nos data centers do Google (Google, 2007).
- Cerca de 5,2% dos HDs de três anos pouco usados falharam em base anualizada, um pouco mais que os 4,6% dos muito usados, nos data centers do Google (Google, 2007).
- Muitos ciclos de liga/desliga elevaram a taxa de falha anualizada dos HDs de três anos ou mais em mais de 2 pontos percentuais, enquanto as unidades mais novas não mostraram nenhuma ligação, nos data centers do Google (Google, 2007).
- Ler dados não desgastou de forma mensurável os SSDs de servidor do Facebook: as unidades que mais tinham lido dados não mostraram aumento estatisticamente significativo de falhas (Meza et al., 2015).
- Os modelos de SSD mais antigos dos data centers da Microsoft falharam com frequência 2 a 4 vezes maior quando muito gravados do que quando pouco gravados, enquanto um modelo mais novo e maior não mostrou ligação clara com as gravações (Narayanan et al., 2016).
- Os 15% a 20% de SSDs mais usados num serviço de armazenamento da Alibaba Cloud tiveram até 77,3% mais erros de dispositivo e uma taxa de falha até 18,7% maior que as unidades com uso equilibrado (Xu et al., 2019).
- As aplicações de análise de dados e de armazenamento em rede rodavam em 3,2% dos SSDs dos data centers da Alibaba, mas responderam por 9,5% dos SSDs com falha em 2018 e 2019 (Han et al., 2021).
Falhas em lotes
- Duas falhas de HD na mesma hora num cluster de 765 nós eram quatro vezes mais prováveis do que o modelo padrão prevê, um risco para as reconstruções de RAID (Carnegie Mellon University, 2007).
- Cerca de um terço das falhas de HD veio em rajadas, 90% delas espalhadas por vários racks, entre mais de 32.000 unidades do sistema de armazenamento do supercomputador Summit ao longo de 2,75 anos (Oak Ridge National Laboratory, 2023).
- Os 10% dos SSDs de servidor do Facebook com mais erros responderam por mais de 80% de todos os erros incorrigíveis em todas as plataformas (Meza et al., 2015).
- 99,8% dos SSDs de servidor do Facebook que tiveram um erro numa semana também tiveram um erro na semana seguinte (Meza et al., 2015).
- Quando um dos dois SSDs de um servidor do Facebook falhava, o outro também tinha falhado em 39,8% a 59,9% dos casos, conforme a plataforma, contra 27,3% esperados numa plataforma se as falhas fossem independentes (Meza et al., 2015).
- Depois que um SSD era substituído num grupo RAID da NetApp, havia 9,39% de chance de outra substituição no mesmo grupo em até uma semana, mais de 180 vezes a chance numa semana qualquer (Maneas et al., 2020).
O servidor em volta da unidade
- 0,99% dos HDs dos vaults Storage Pod 5.0, mais antigos, da Backblaze falharam, em base anualizada, no 3º trimestre de 2023, contra 2,14% nos seus vaults 6.0, mais novos, embora as unidades dos 5.0 tivessem cerca do dobro da idade (Backblaze, 2024).
- O mesmo modelo de SSD falhou com frequência 14 vezes maior num projeto de servidor da Microsoft do que em outro, o que mostra que o servidor em volta de uma unidade afeta a sua taxa de falha (Narayanan et al., 2016).
Ruído e vibração
- Os HDs podem ser danificados por níveis sonoros de 110 decibéis ou mais e pelas vibrações que eles causam, segundo experimentos da Siemens Corporate Technology com o ruído dos bicos de supressão de incêndio a gás em data centers (Siemens, 2016).
- Cerca de 130 decibéis, tão alto quanto a decolagem de um caça, é o ruído de um bico convencional de extinção de incêndio a gás pelas medições da Siemens, contra os menos de 100 decibéis para os quais o seu bico mais silencioso foi projetado (Siemens, 2016).
- O principal data center do ING Bank em Bucareste levou 10 horas para voltar a funcionar depois que o ruído de um teste de supressão de incêndio com gás inerte danificou vários servidores e equipamentos de armazenamento em 10 de setembro de 2016, cortando os serviços de cartão e de banco on-line durante esse tempo (Motherboard, 2016).
- O ruído de uma descarga do sistema de supressão de incêndio com gás inerte no data center da DigiPlex perto de Estocolmo, em 18 de abril de 2018, destruiu discos de servidores e deixou as bolsas da Nasdaq Nordic fora do ar até a tarde (The Register, 2018).
Modos de falha e o que os laboratórios de recuperação veem

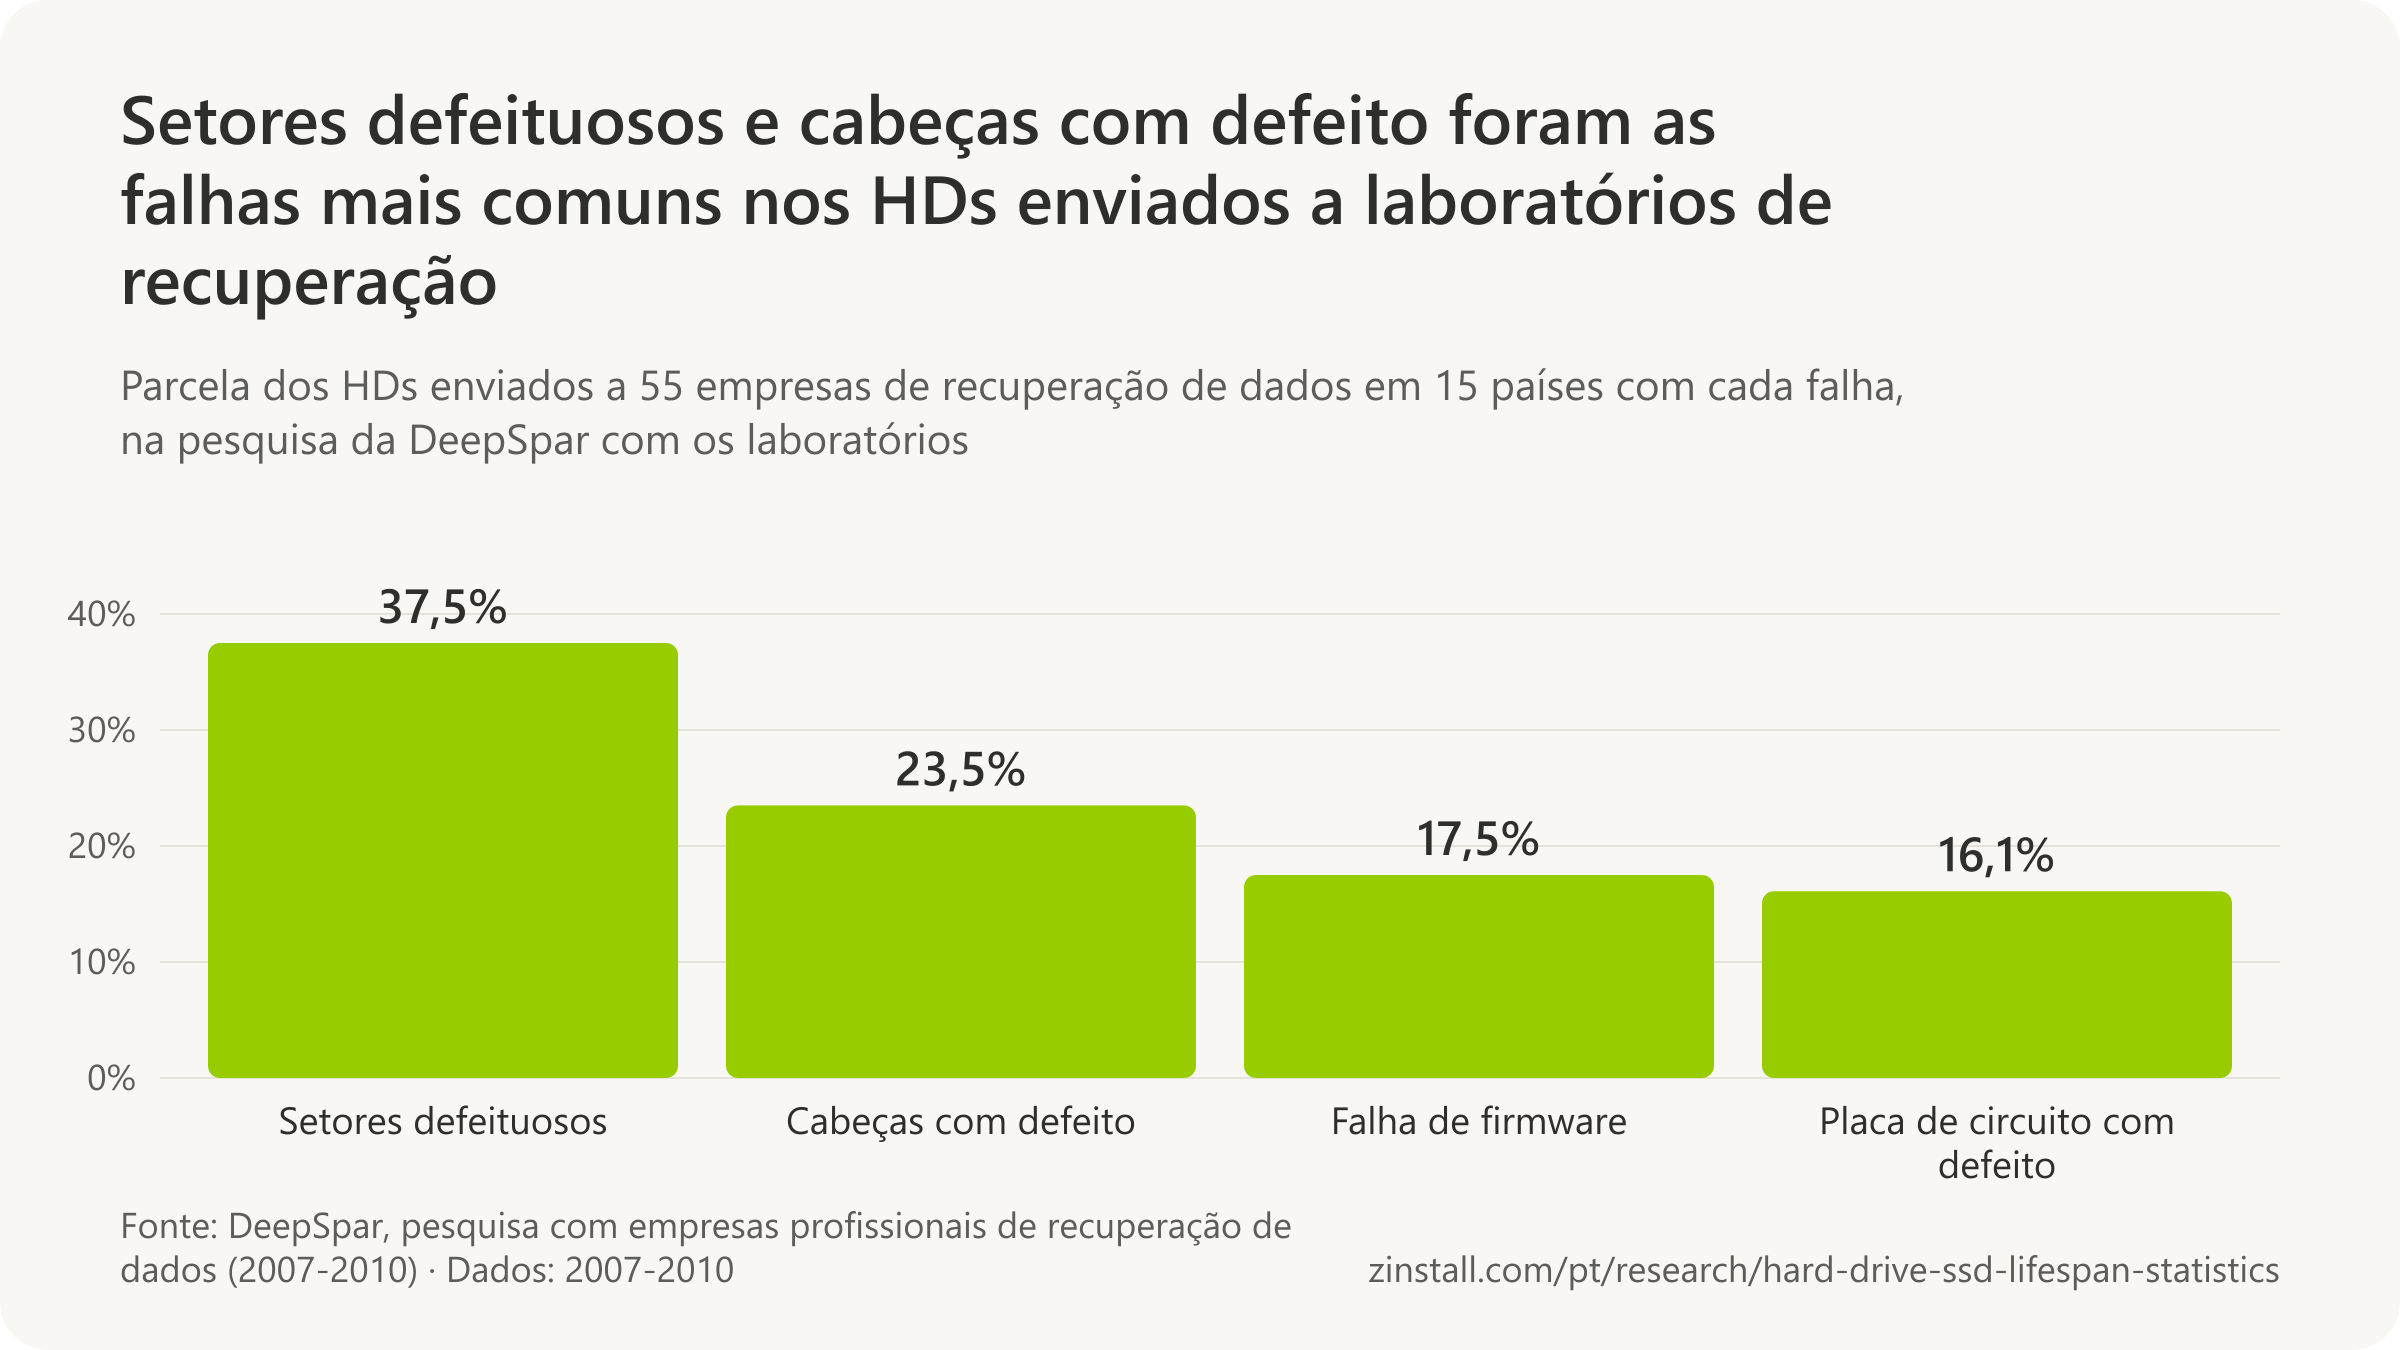
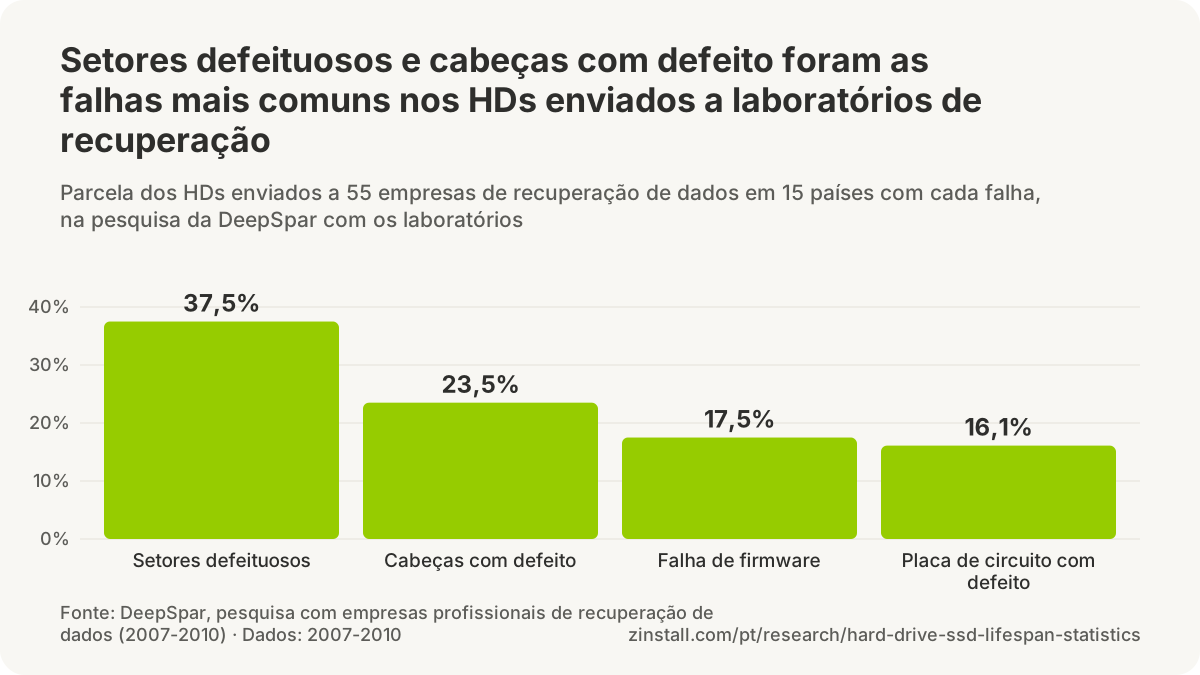
- 0,86% dos HDs SATA nearline desenvolveram corrupção silenciosa de dados (blocos cujo checksum não batia mais) ao longo de 41 meses, contra 0,065% das unidades corporativas, em sistemas de armazenamento da NetApp (University of Wisconsin e NetApp, 2008).
- 8% das corrupções silenciosas de dados nos HDs foram descobertas durante a reconstrução do RAID, quando dados podem ser perdidos, entre mais de 400.000 casos em sistemas de armazenamento da NetApp (University of Wisconsin e NetApp, 2008).
- 44,1% das falhas do modelo de HD mais comum foram corrupções de dados e 19,1% requisições de E/S com falha, enquanto no segundo modelo os erros de requisição de E/S lideraram, com 45,5%, nos data centers da Alibaba Cloud (Chinese University of Hong Kong e Alibaba, 2019).
- Em 0,22% do tempo, um HD funcionou pelo menos duas vezes mais devagar que os seus pares no mesmo grupo RAID, em 458.482 unidades em sistemas de clientes da NetApp (University of Chicago e NetApp, 2016).
- 26% dos HDs tiveram pelo menos um período em que funcionaram duas vezes mais devagar que os seus pares no RAID, em cerca de 87 dias, em 458.482 unidades em sistemas de clientes da NetApp (University of Chicago e NetApp, 2016).
- 88,14% dos casos de recuperação registrados pela Gillware ao longo de algumas semanas de 2016 eram HDs e 2,03% SSDs, entre 295 casos, pela contagem da própria empresa (Gillware, 2016).
- 48,66% dos casos de recuperação registrados pela Gillware em 2016 envolveram uma falha mecânica, 21,14% firmware, 15,44% degradação da mídia magnética e 12,75% falha elétrica, contra 1,01% lógicos, pela contagem da própria empresa (Gillware, 2016).
- 70% das falhas de HD que a DriveSavers viu nos seus laboratórios de recuperação foram danos na mídia, incluindo choques de cabeça (head crashes), 18% falhas da placa de circuito, 11% cabeças presas (stiction) e 1% falhas do motor, pela contagem da DriveSavers publicada pela Backblaze (Backblaze, 2019).
- 18% das falhas de HD que a DriveSavers viu nos seus laboratórios de recuperação foram falhas da placa de circuito, pela contagem da DriveSavers publicada pela Backblaze (Backblaze, 2019).
- 81,97% dos casos de recuperação de HD numa amostra da Secure Data Recovery envolveram danos físicos e 18,03% problemas de software (lógicos), pela contagem da própria empresa (Secure Data Recovery, 2024).
- 60,62% dos casos de recuperação de SSD numa amostra da Secure Data Recovery envolveram danos físicos e 39,38% problemas de software (lógicos), pela contagem da própria empresa (Secure Data Recovery, 2024).
- 50% das falhas de HD entre cerca de 30.000 unidades enviadas à Payam Data Recovery, na Austrália, de 2020 a 2025 vieram de danos físicos, como quedas, e 50% de defeitos mecânicos ou eletrônicos (Payam Data Recovery, 2025).
- O Seagate ST2000LM007 e o Western Digital WD20SDRW, unidades de 2TB comuns em HDs portáteis e externos, lideraram todas as três listas de falhas (choques de cabeça, falhas de cabeça, setores defeituosos) entre as unidades enviadas à Payam Data Recovery de 2020 a 2025 (Payam Data Recovery, 2025).
- O gerente sênior de recuperação de dados da Ontrack disse em 2016 que as taxas de falha de SSDs e de HDs são semelhantes, embora eles falhem de formas diferentes (Ontrack, 2016).
Fontes: Backblaze (2014-2024); University of Toronto, with Google data; Rutgers University, GoDaddy and Microsoft; University of Essex and Sungkyunkwan University; ACM, Proceedings of the 2015 ACM SIGMETRICS International Conference on Measurement and Modeling of Computer Systems; USENIX, Proceedings of the 2019 USENIX Annual Technical Conference; Google; ACM, Proceedings of the 9th ACM International Systems and Storage Conference; USENIX, Proceedings of the 19th USENIX Conference on File and Storage Technologies; Carnegie Mellon University; Oak Ridge National Laboratory; USENIX, Proceedings of the 18th USENIX Conference on File and Storage Technologies; Siemens AG, released; Motherboard, quoting ING Bank Romania's press release and spokeswoman; The Register; University of Wisconsin-Madison, NetApp and University of Toronto; The Chinese University of Hong Kong and Alibaba; University of Chicago and NetApp; Gillware Data Recovery; Secure Data Recovery Services; Payam Data Recovery; Ontrack; DeepSpar Data Recovery Systems
Quantos terabytes um SSD pode gravar antes de se desgastar?
Um SSD Samsung 850 Pro de 256 GB gravou cerca de 9,1 PB antes de falhar, 60 vezes a sua classificação (c't, 2017).

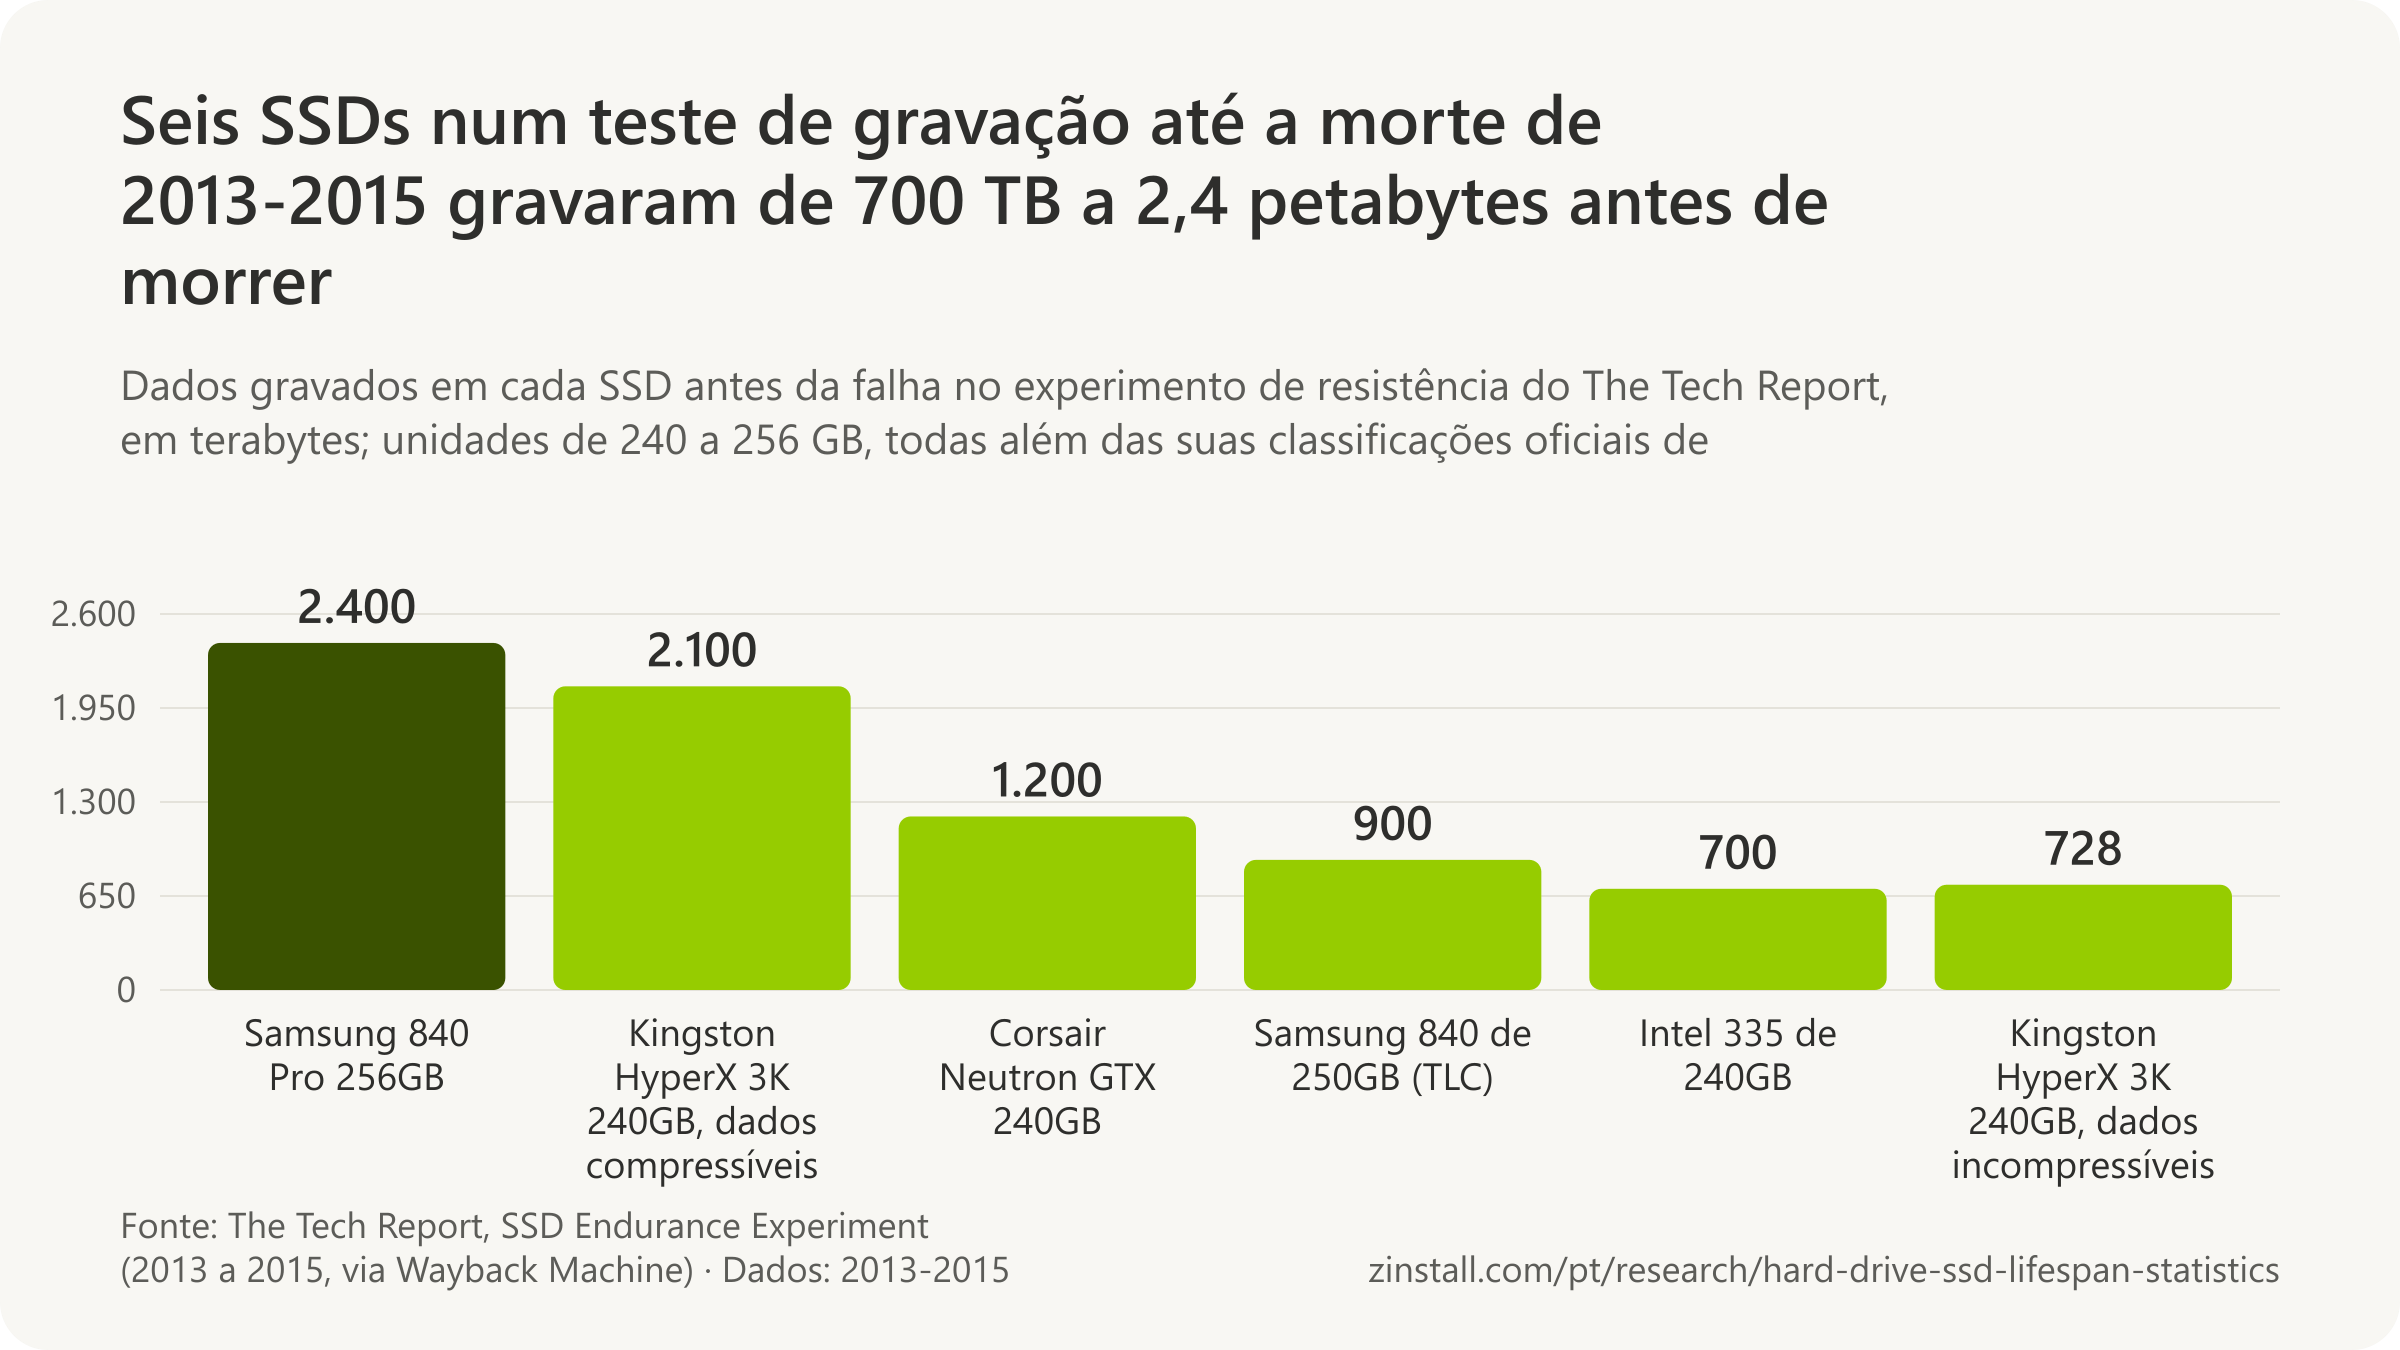
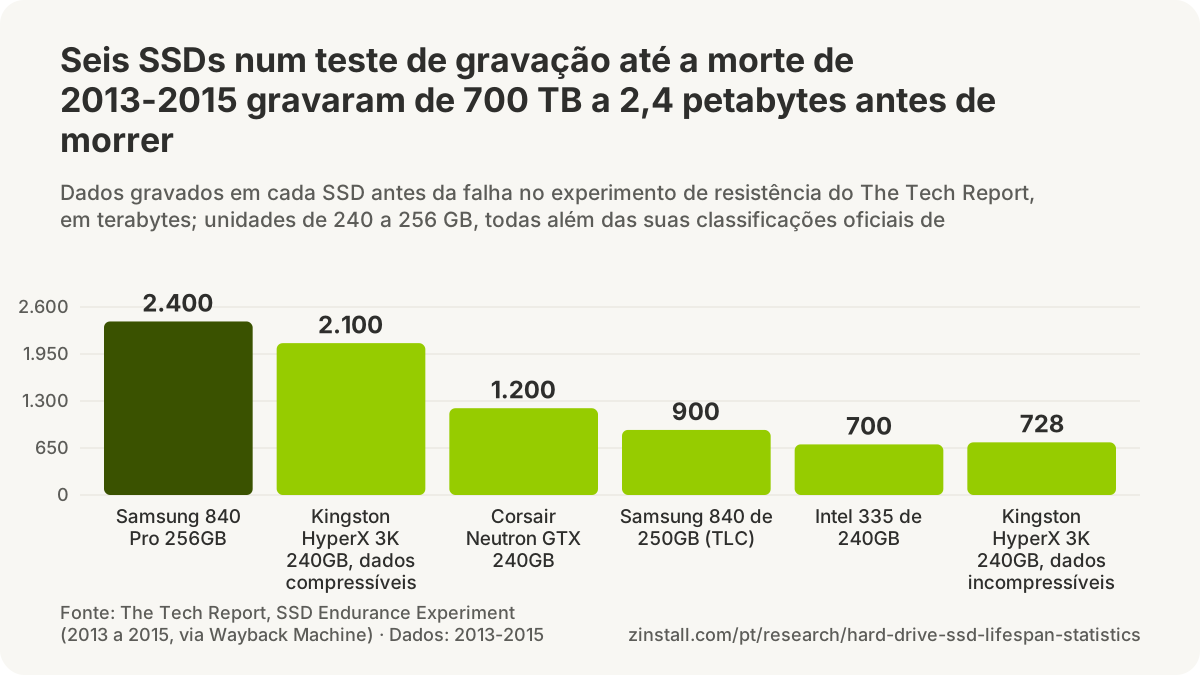
- Todos os seis SSDs de um teste de gravação até a morte de 2013-2015 gravaram centenas de terabytes além das suas classificações oficiais.
- 60% dos SSDs corporativos dos sistemas da NetApp usaram menos de 1% do seu desgaste nominal por ano.
- Uma classificação de 600 TBW em cinco anos permite cerca de 329 GB de gravações por dia.
- Os 20 GB por dia durante cinco anos que a Intel supunha somam 36,5 TB, cerca de 6% de uma classificação de 600 TBW.
- Os SSDs de consumo de 1 TB têm classificações de 220 a 800 TBW, uma faixa de quase quatro vezes.
| Unidade ou fonte e medida | Número |
|---|---|
| Samsung 990 PRO 2 TB | 1.200 TBW |
| Samsung 990 PRO 4 TB | 2.400 TBW |
| Samsung 860 PRO 1 TB (modelo mais antigo) | 1.200 TBW |
| Samsung 850 PRO 1 TB (modelo mais antigo, garantia de dez anos) | 10 anos |
| SSD de data center Micron 7450 PRO | 1 DWPD |
| Intel SSD 320: as gravações por dia que a Intel supunha, 2011 | até 20 GB por dia |
| O que a Sandisk diz que um usuário doméstico grava por dia (sem medição citada) | 20-40 GB por dia |
| JEDEC: SSDs que podem falhar até o fim da sua resistência nominal | 3% |
| c't: flash além dos ciclos de gravação especificados | 3 a 30 vezes |
| Google: ciclos de gravação nominais que os seus SSDs MLC tinham usado | 18-32% do desgaste nominal (MLC) |
Fontes: heise online / c't magazin (2021, 2017); The Tech Report (2015a, 2015b); USENIX, Proceedings of the 20th USENIX Conference on File and Storage Technologies; Samsung Electronics (2026, 2022); Intel Corporation; Crucial, Kingston, Samsung, Sandisk, SK hynix; Micron Technology; Sandisk; JEDEC Solid State Technology Association; USENIX, Proceedings of the 14th USENIX Conference on File and Storage Technologies
Guias relacionados: Um PC novo com SSD · Clonar ou transferir
Mais estatísticas (65)
Todo SSD tem uma resistência nominal expressa no total de dados gravados, o seu TBW, que é o limite da garantia, e não uma previsão de quando ele vai morrer. Os testes de gravação até a morte levaram unidades muito além das suas classificações, e, em data centers, as unidades usaram uma pequena parte da resistência nominal antes de ser aposentadas. Ninguém publica quanto um PC típico grava num ano: as suposições dos fabricantes são tudo o que existe.
Testes de gravação até a morte

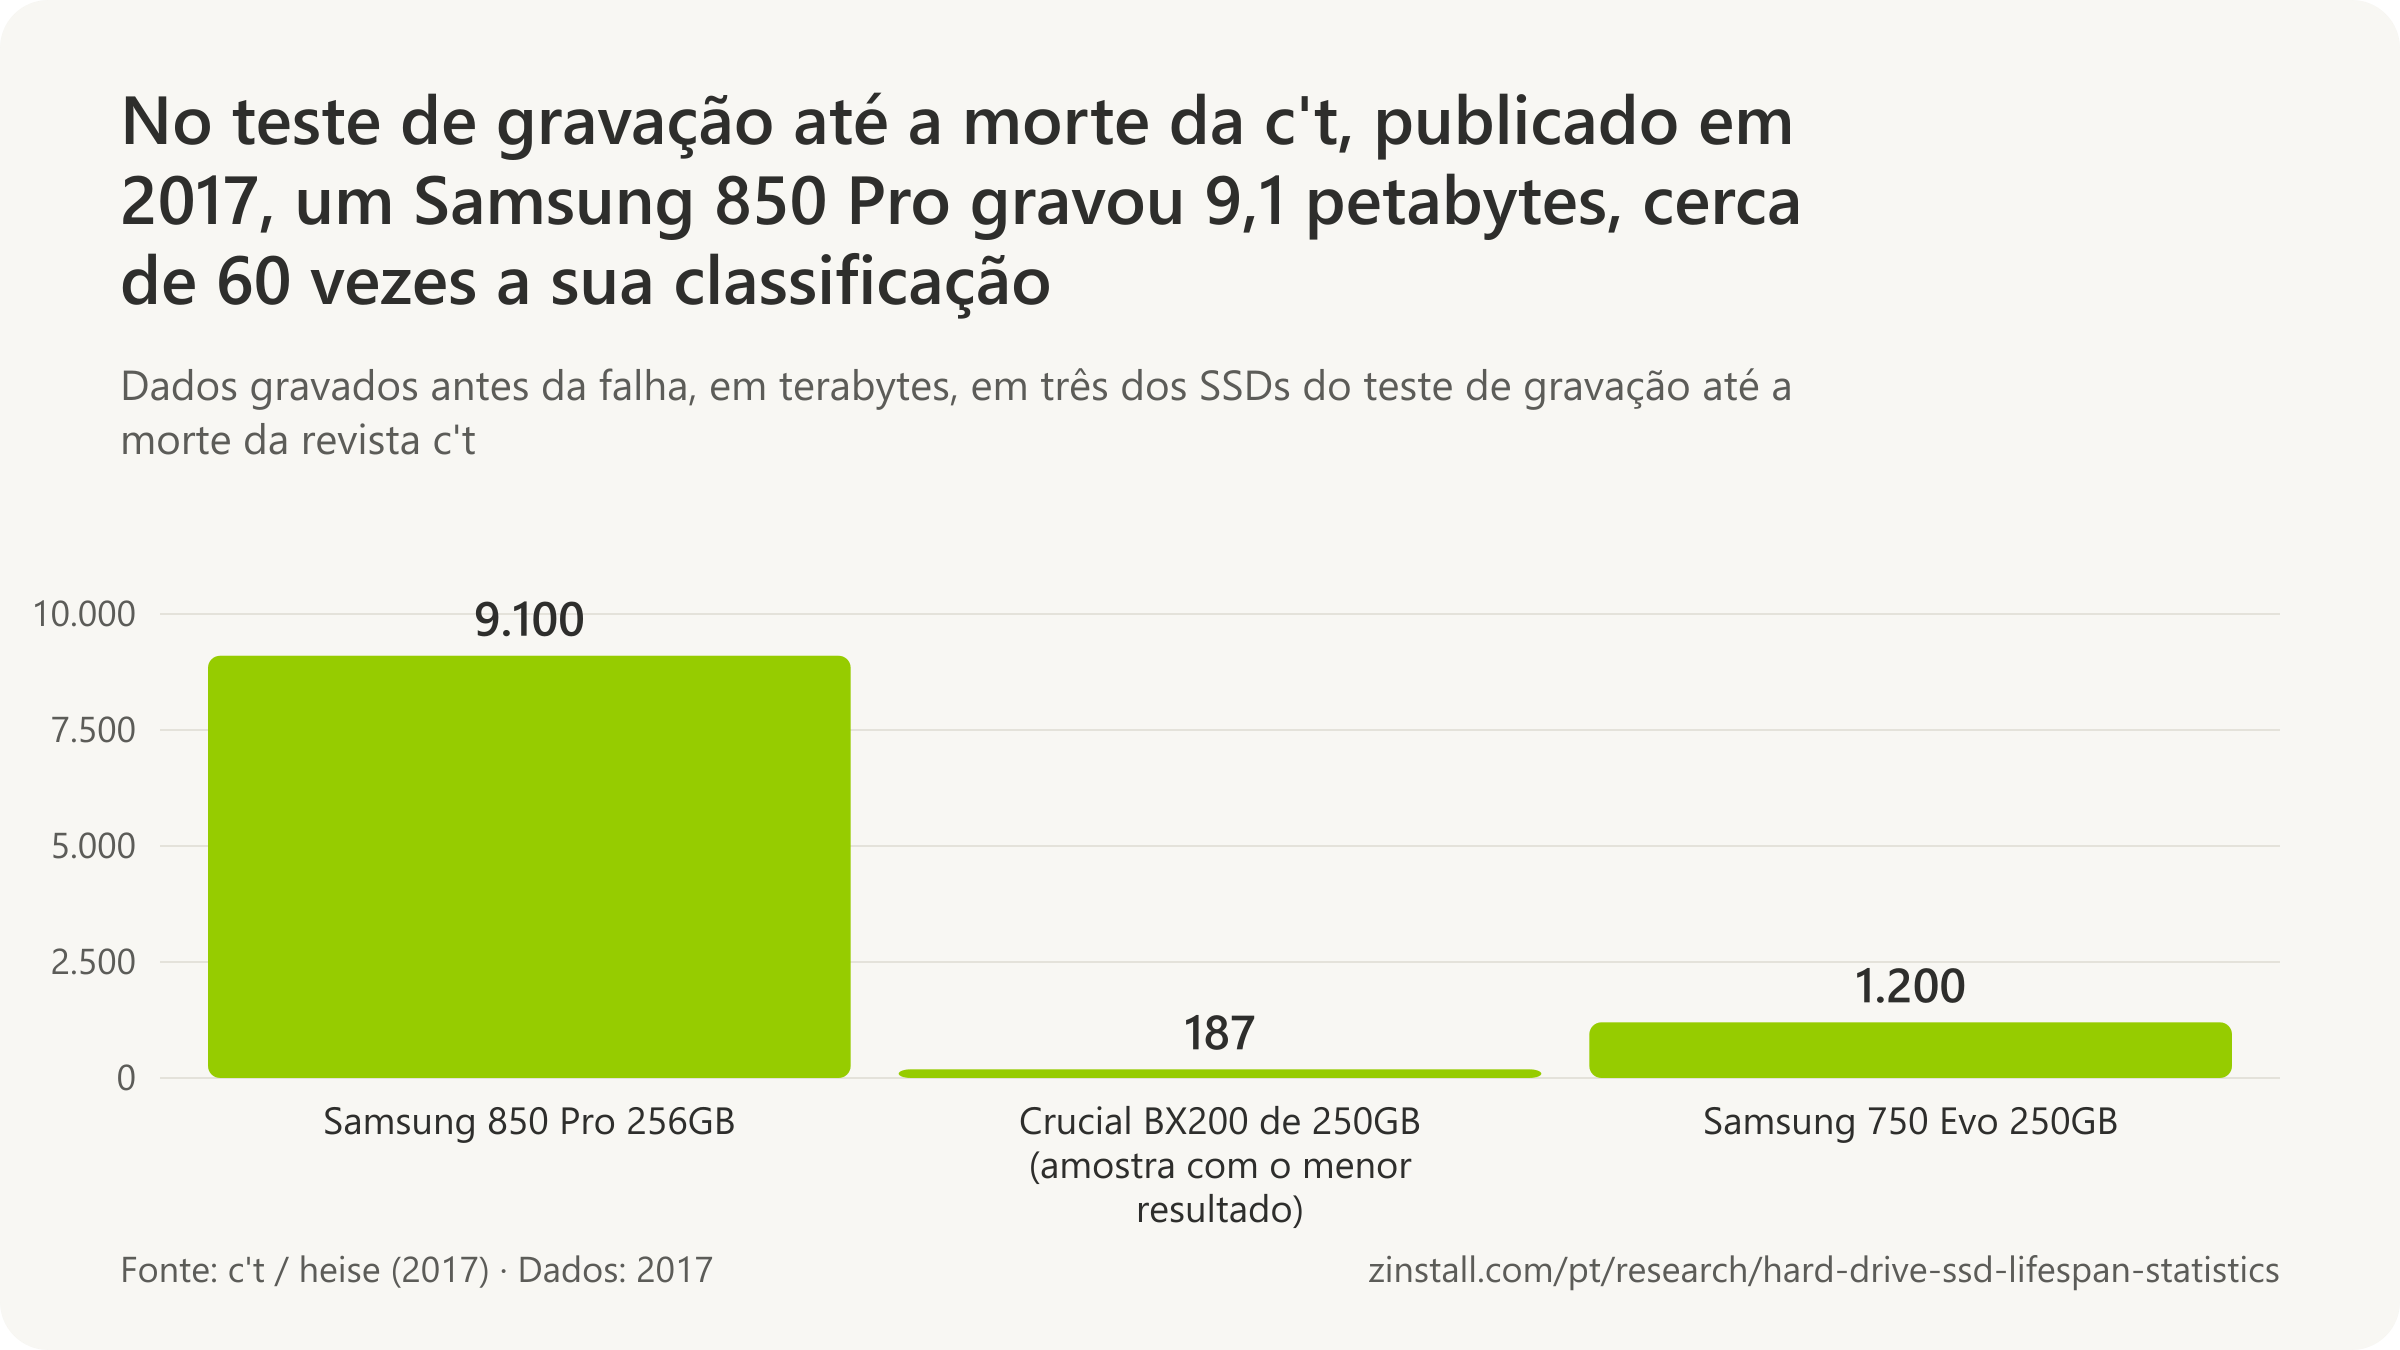
- Todos os seis SSDs do teste de gravação até a morte do The Tech Report, de 2013-2015, gravaram centenas de terabytes além das suas especificações oficiais de resistência antes de falhar (The Tech Report, 2015).
- No teste de gravação até a morte da c't, nenhum dos SSDs premium (Samsung 850 Pro, SanDisk Extreme Pro) falhou antes de 2,2 PB gravados (c't, 2017).
- Dois dos 12 SSDs do teste de gravação até a morte da c't morreram por causa de um pico de tensão quando um sistema de teste falhou, e não por desgaste da flash (c't, 2017).
- Os SSDs podem chegar a 3 a 30 vezes os ciclos de programação/apagamento especificados para a sua flash antes de falhar num teste de gravação ou de leitura, mas os dados gravados tão tarde podem não sobreviver ao armazenamento sem energia, noticiou a c't (c't, 2021).
Resistência nominal (TBW) de SSDs populares

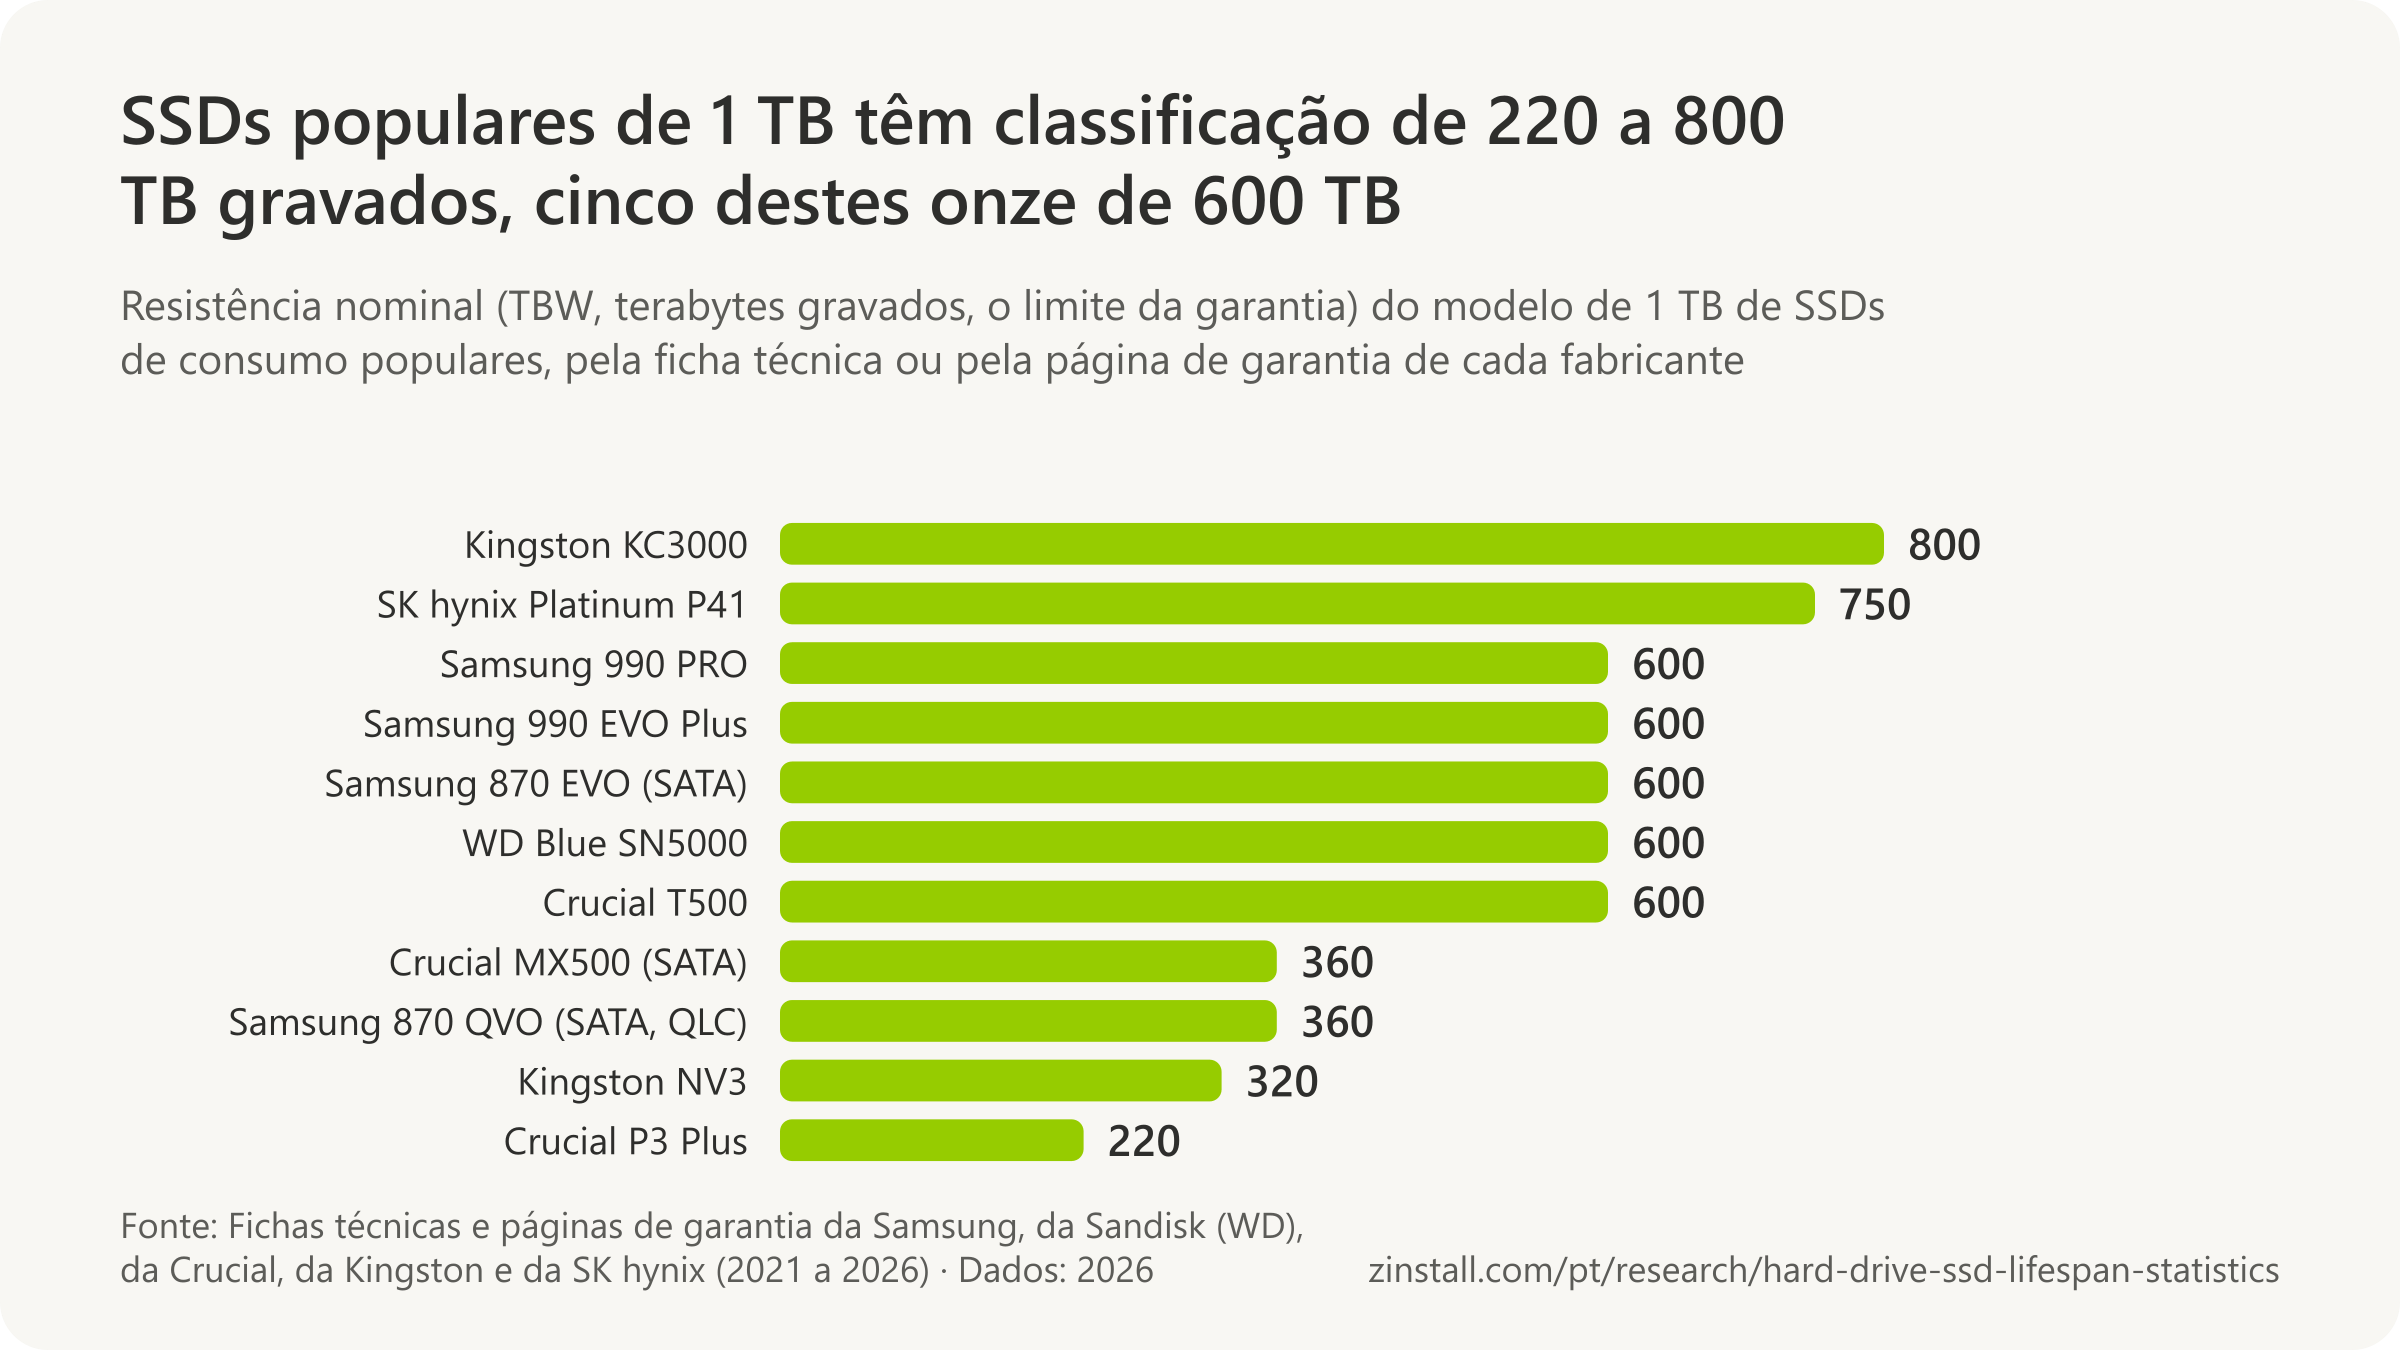
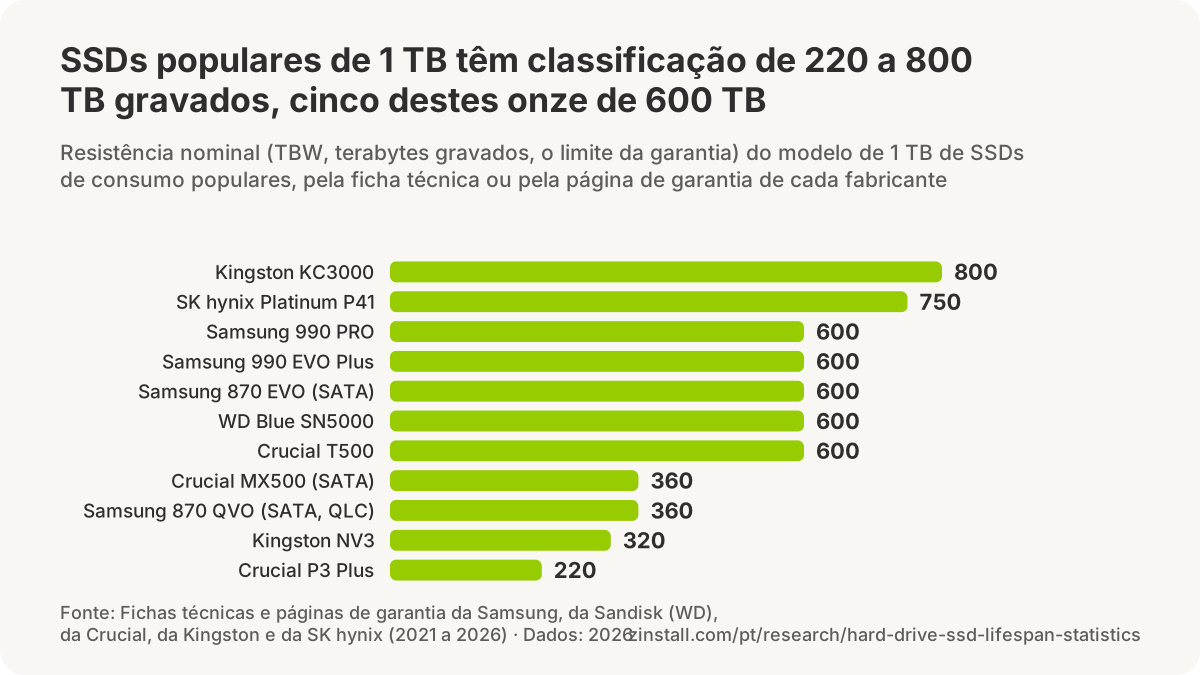

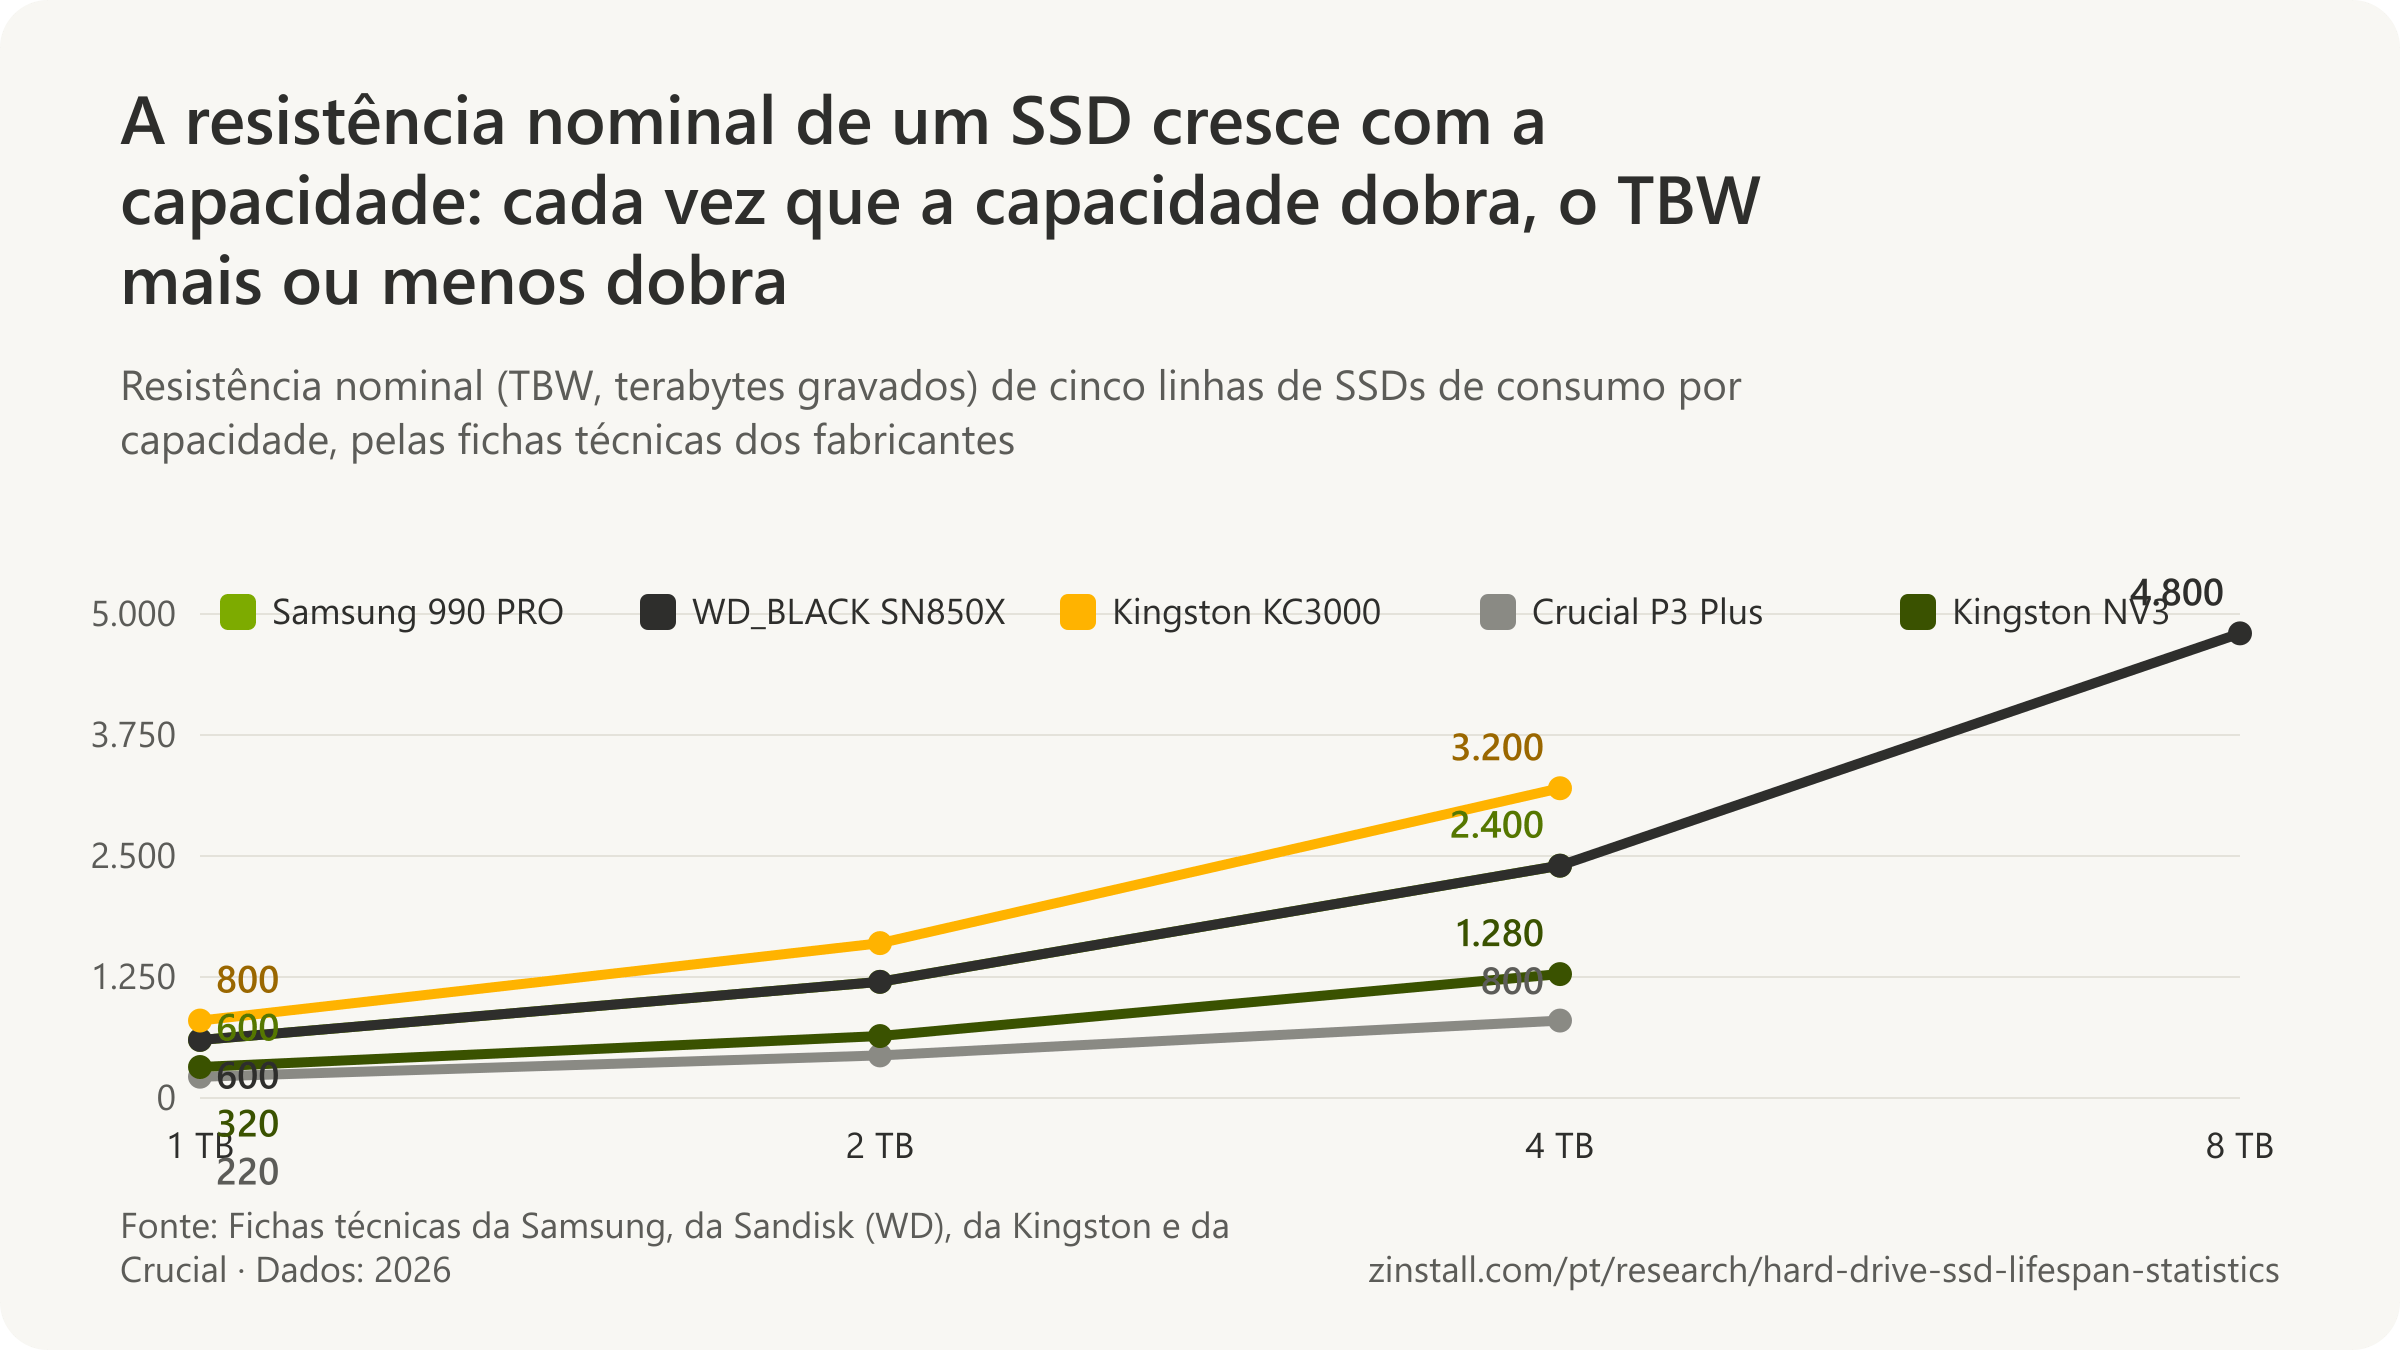
- A garantia da Samsung cobre o SSD 990 EVO Plus de 2 TB por cinco anos ou 1.200 TBW (terabytes gravados), o que ocorrer primeiro (Samsung, 2026).
- A garantia da Samsung cobre o SSD 990 EVO Plus de 4 TB por cinco anos ou 2.400 TBW (terabytes gravados), o que ocorrer primeiro (Samsung, 2026).
- A garantia da Samsung cobre o SSD 9100 PRO de 1 TB por cinco anos ou 600 TBW (terabytes gravados), o que ocorrer primeiro (Samsung, 2026).
- A garantia da Samsung cobre o SSD 9100 PRO de 2 TB por cinco anos ou 1.200 TBW (terabytes gravados), o que ocorrer primeiro (Samsung, 2026).
- A garantia da Samsung cobre o SSD 9100 PRO de 4 TB por cinco anos ou 2.400 TBW (terabytes gravados), o que ocorrer primeiro (Samsung, 2026).
- A garantia da Samsung cobre o SSD 9100 PRO de 8 TB por cinco anos ou 4.800 TBW (terabytes gravados), o que ocorrer primeiro (Samsung, 2026).
- A garantia da Samsung cobre o SSD SATA 870 EVO de 2 TB por cinco anos ou 1.200 TBW (terabytes gravados), o que ocorrer primeiro (Samsung, 2026).
- A garantia da Samsung cobre o SSD SATA 870 EVO de 4 TB por cinco anos ou 2.400 TBW (terabytes gravados), o que ocorrer primeiro (Samsung, 2026).
- A garantia da Samsung cobria o seu antigo SSD SATA 850 PRO por dez anos, com limite de 300 TBW nos modelos de 512 GB e de 1 TB, o que ocorresse primeiro (Samsung, 2026).
- A garantia da Samsung cobria o seu antigo SSD SATA 860 PRO de 1 TB por cinco anos ou 1.200 TBW, o dobro dos 600 TBW do atual 990 PRO de 1 TB (Samsung, 2026).
- A Sandisk (antes Western Digital) classifica o WD Blue SN5000 de 2 TB para 900 TBW de resistência (terabytes gravados), com uma garantia limitada de cinco anos (Sandisk, 2026).
- A Sandisk (antes Western Digital) classifica o WD Blue SN5000 de 4 TB para 1.200 TBW de resistência (terabytes gravados), com uma garantia limitada de cinco anos (Sandisk, 2026).
- A Crucial (Micron) classifica o SSD T500 de 2 TB para 1.200 TBW (terabytes gravados), com uma garantia limitada de cinco anos que termina no limite que for atingido primeiro (Crucial, 2026).
- A Kingston afirma que a classificação TBW do NV3 é derivada da carga de trabalho cliente do JEDEC (JESD219A) e que a sua garantia de cinco anos também termina quando o indicador Percentage Used da unidade chega a 100 (Kingston, 2025).
- A SK hynix classifica o SSD Platinum P41 de 2 TB para até 1.200 TBW (terabytes gravados), com garantia de cinco anos (SK hynix, 2026).
- Uma classificação de 600 TBW numa garantia de cinco anos, a classificação de um Samsung 990 PRO, de um WD_BLACK SN850X ou de um Crucial T500 de 1 TB, permite cerca de 329 GB de gravações por dia durante cinco anos (derivado da ficha técnica da Samsung, 2022).
- Um SSD de consumo de 1 TB com classificação de 600 TBW em cinco anos tem classificação de 0,33 gravação completa da unidade por dia, um terço do 1 DWPD de um SSD de data center para leitura intensiva (derivado das classificações da Samsung e da Micron, 2026).
- A garantia da Samsung cobre o SSD 990 EVO de 1 TB por cinco anos ou 600 TBW (terabytes gravados), o que ocorrer primeiro (Samsung, 2026).
- A Crucial classifica o SSD SATA MX500 de 2 TB para 700 TBW (terabytes gravados), o que ela equipara a 383 GB por dia durante cinco anos, com uma garantia limitada de cinco anos (Crucial, 2021).
- A Crucial classifica o SSD SATA MX500 de 4 TB para 1.000 TBW (terabytes gravados), o que ela equipara a 547 GB por dia durante cinco anos, com uma garantia limitada de cinco anos (Crucial, 2021).
- A resistência nominal de um SSD de consumo de 1 TB vai de 220 a 800 TBW conforme o modelo, quase quatro vezes, do Crucial P3 Plus ao Kingston KC3000, com a maioria dos mais vendidos em 600 TBW (fichas técnicas dos fabricantes, 2021 a 2026).
- A norma JESD218 do JEDEC define a classificação de resistência de um SSD (TBW, terabytes gravados) como o máximo de dados que um host pode gravar enquanto a unidade ainda mantém a sua capacidade, os seus limites de taxa de erros e de falhas e a retenção de dados exigida com a energia desligada (JEDEC, 2010).
- O JEDEC publicou as suas duas normas para SSDs, a JESD218 (requisitos e método de teste de resistência) e a JESD219 (cargas de trabalho de resistência), em 23 de setembro de 2010, criando a classificação de resistência TBW (JEDEC, 2010).
Quanto da sua classificação uma unidade usa
- A Micron classifica o seu SSD de data center 7450 MAX (uso misto) para 3 gravações completas da unidade por dia, 35.000 TBW no modelo E1.S de 6,4 TB, com garantia de cinco anos (Micron, 2026).
- A Kingston atribui à flash NAND SLC (um bit por célula) 100.000 ciclos de programação/apagamento, a maior resistência entre os tipos de flash (Kingston, 2026).
- A Kingston atribui à flash NAND MLC (dois bits por célula) 10.000 ciclos de programação/apagamento (Kingston, 2026).
- A Kingston atribui à flash NAND TLC (três bits por célula), o padrão nos PCs comuns, tipicamente 3.000 a 5.000 ciclos de programação/apagamento (Kingston, 2026).
- A Kingston diz que a flash TLC de classe corporativa (eTLC) muitas vezes chega a 10.000 a 30.000 ciclos de programação/apagamento, graças a um silício melhor e a mais sobreprovisionamento (over-provisioning) (Kingston, 2026).
- A Kingston atribui à flash NAND QLC (quatro bits por célula), usada em SSDs de alta capacidade mais baratos, cerca de 1.000 ciclos de programação/apagamento (Kingston, 2026).
- A Lexar Enterprise atribui à flash NAND SLC tipicamente 50.000 a 100.000 ciclos de programação/apagamento (Lexar Enterprise, 2026).
- A Lexar Enterprise atribui à flash NAND MLC tipicamente 3.000 a 10.000 ciclos de programação/apagamento (Lexar Enterprise, 2026).
- A Lexar Enterprise atribui à flash NAND TLC tipicamente 1.000 a 3.000 ciclos de programação/apagamento, com a NAND 3D no topo da faixa (Lexar Enterprise, 2026).
- A Lexar Enterprise atribui à flash NAND QLC tipicamente 150 a 1.000 ciclos de programação/apagamento (Lexar Enterprise, 2026).
- As unidades flash MLC dos data centers do Google tinham usado em média 18% a 32% dos seus ciclos de programação/apagamento nominais (529 a 949 de 3.000), e as suas unidades SLC e eMLC menos de 7% (Schroeder et al., 2016; derivado).
- As unidades flash dos data centers do Google não mostraram um salto súbito de erros depois de passar do limite nominal de ciclos de programação/apagamento do fabricante; os erros cresceram de forma mais ou menos linear com o desgaste (Schroeder et al., 2016).
- Nos testes de vida acelerada do Google, as taxas de erro bruto de bits das unidades flash só subiram bruscamente por volta de três vezes o limite nominal de ciclos de programação/apagamento do fabricante, o que sugere que os limites são definidos de forma muito conservadora (Schroeder et al., 2016).
- O tempo em campo aumentou a taxa de erro bruto de bits das unidades flash dos data centers do Google independentemente do desgaste causado pelas gravações, então um SSD envelhece com o tempo, e não só com o uso (Schroeder et al., 2016).
- As taxas de falha de uma plataforma de SSDs de servidor do Facebook diferiram em até 81,7% entre o período inicial da vida e o período de desgaste (Meza et al., 2015).
- Os SSDs corporativos que estavam havia dois a três anos nos sistemas de armazenamento da NetApp tinham usado, em média, menos de 2% dos seus ciclos de programação/apagamento nominais (Maneas et al., 2020).
- Os SSDs MLC corporativos nos sistemas de armazenamento da NetApp que tinham usado menos de 1% da sua vida nominal tinham probabilidade 1,25 vez maior de ser substituídos que os que tinham usado mais (Maneas et al., 2020).
- 99% dos sistemas de armazenamento corporativos da NetApp tinham usado no máximo 15% da resistência nominal de gravação dos seus SSDs, então os autores não viram risco de desgaste para a maioria dos usuários na mudança para a flash QLC, de menor resistência (Maneas et al., 2020).
- 60% dos SSDs nos sistemas de armazenamento corporativos da NetApp usaram menos de 1% dos seus ciclos de programação/apagamento nominais por ano, um ritmo em que durariam mais de 100 anos antes de se desgastar (Maneas et al., 2022).
- Cerca de 95% dos SSDs nos sistemas de armazenamento corporativos da NetApp poderiam ter sido unidades QLC com classificação de apenas 1.000 ciclos de programação/apagamento sem se desgastar dentro de uma vida típica de cinco anos (Maneas et al., 2022).
- O SSD mediano nos sistemas de armazenamento corporativos da NetApp recebia por dia gravações de 0,36 vez a sua capacidade (0,36 gravação completa da unidade por dia), bem abaixo das 1 a 3 para as quais as unidades corporativas típicas são classificadas (Maneas et al., 2022).
- Mais de 7% dos SSDs nos sistemas de armazenamento corporativos da NetApp recebiam por dia gravações de mais de 3 vezes a sua capacidade, acima do que muitas unidades têm na classificação, e 2% de mais de 10 vezes (Maneas et al., 2022).
- Algumas famílias de SSDs corporativos nos sistemas da NetApp gravavam na sua flash cerca de 100 vezes o que o host enviava (amplificação de gravação mediana em torno de 100), principalmente regravando em segundo plano os dados armazenados antes que eles se degradassem (Maneas et al., 2022).
- Em 5% dos SSDs nos sistemas de armazenamento corporativos da NetApp, o bloco mais apagado tinha sido apagado mais de seis vezes mais que o bloco médio, então o nivelamento de desgaste (wear levelling) estava longe de ser perfeito (Maneas et al., 2022).
- Os SSDs SATA dos data centers da Alibaba tinham usado em média de 2% a 27% dos seus ciclos de apagamento nominais depois de 1,4 a 5,5 anos ligados, conforme o modelo (Han et al., 2021).
- Os SSDs NVMe da Alibaba cuja flash recebia menos gravações que as enviadas pelo host (amplificação de gravação de 1 ou menos, graças à compressão) foram substituídos com frequência cerca de 2,2 vezes maior que as outras unidades (Lu et al., 2022).
- Quase 98% das falhas de SSD num data center do Google ocorreram antes que as unidades tivessem usado 1.500 dos seus 3.000 ciclos de programação/apagamento nominais, e as unidades que passaram do limite nominal raramente falharam (Alter et al., 2019).
Quanto as pessoas gravam por dia
- A Micron classifica o seu SSD de data center 7450 PRO (para leitura intensiva) para 1 gravação completa da unidade por dia, e a sua ficha técnica classifica o modelo E1.S de 3,84 TB para 7.300 TBW, contra 600 a 1.200 TBW das unidades de consumo de 1 a 2 TB (Micron, 2026).
- A Intel especificou o seu SSD 320 (2011) para uma vida útil mínima de cinco anos com cargas de trabalho cliente típicas de até 20 GB de gravações do host por dia (Intel, 2011).
- A suposição de 2011 da Intel para uso cliente, de 20 GB de gravações do host por dia durante cinco anos, soma 36,5 TB gravados, cerca de 6% da classificação de 600 TBW de um SSD de consumo de 1 TB em 2026 (derivado de dados da Intel, 2011).
- A Sandisk diz aos compradores que o usuário doméstico médio grava de 20 a 40 GB de dados por dia, sem citar nenhuma medição (Sandisk, 2026).
Tipos de flash e ciclos de gravação

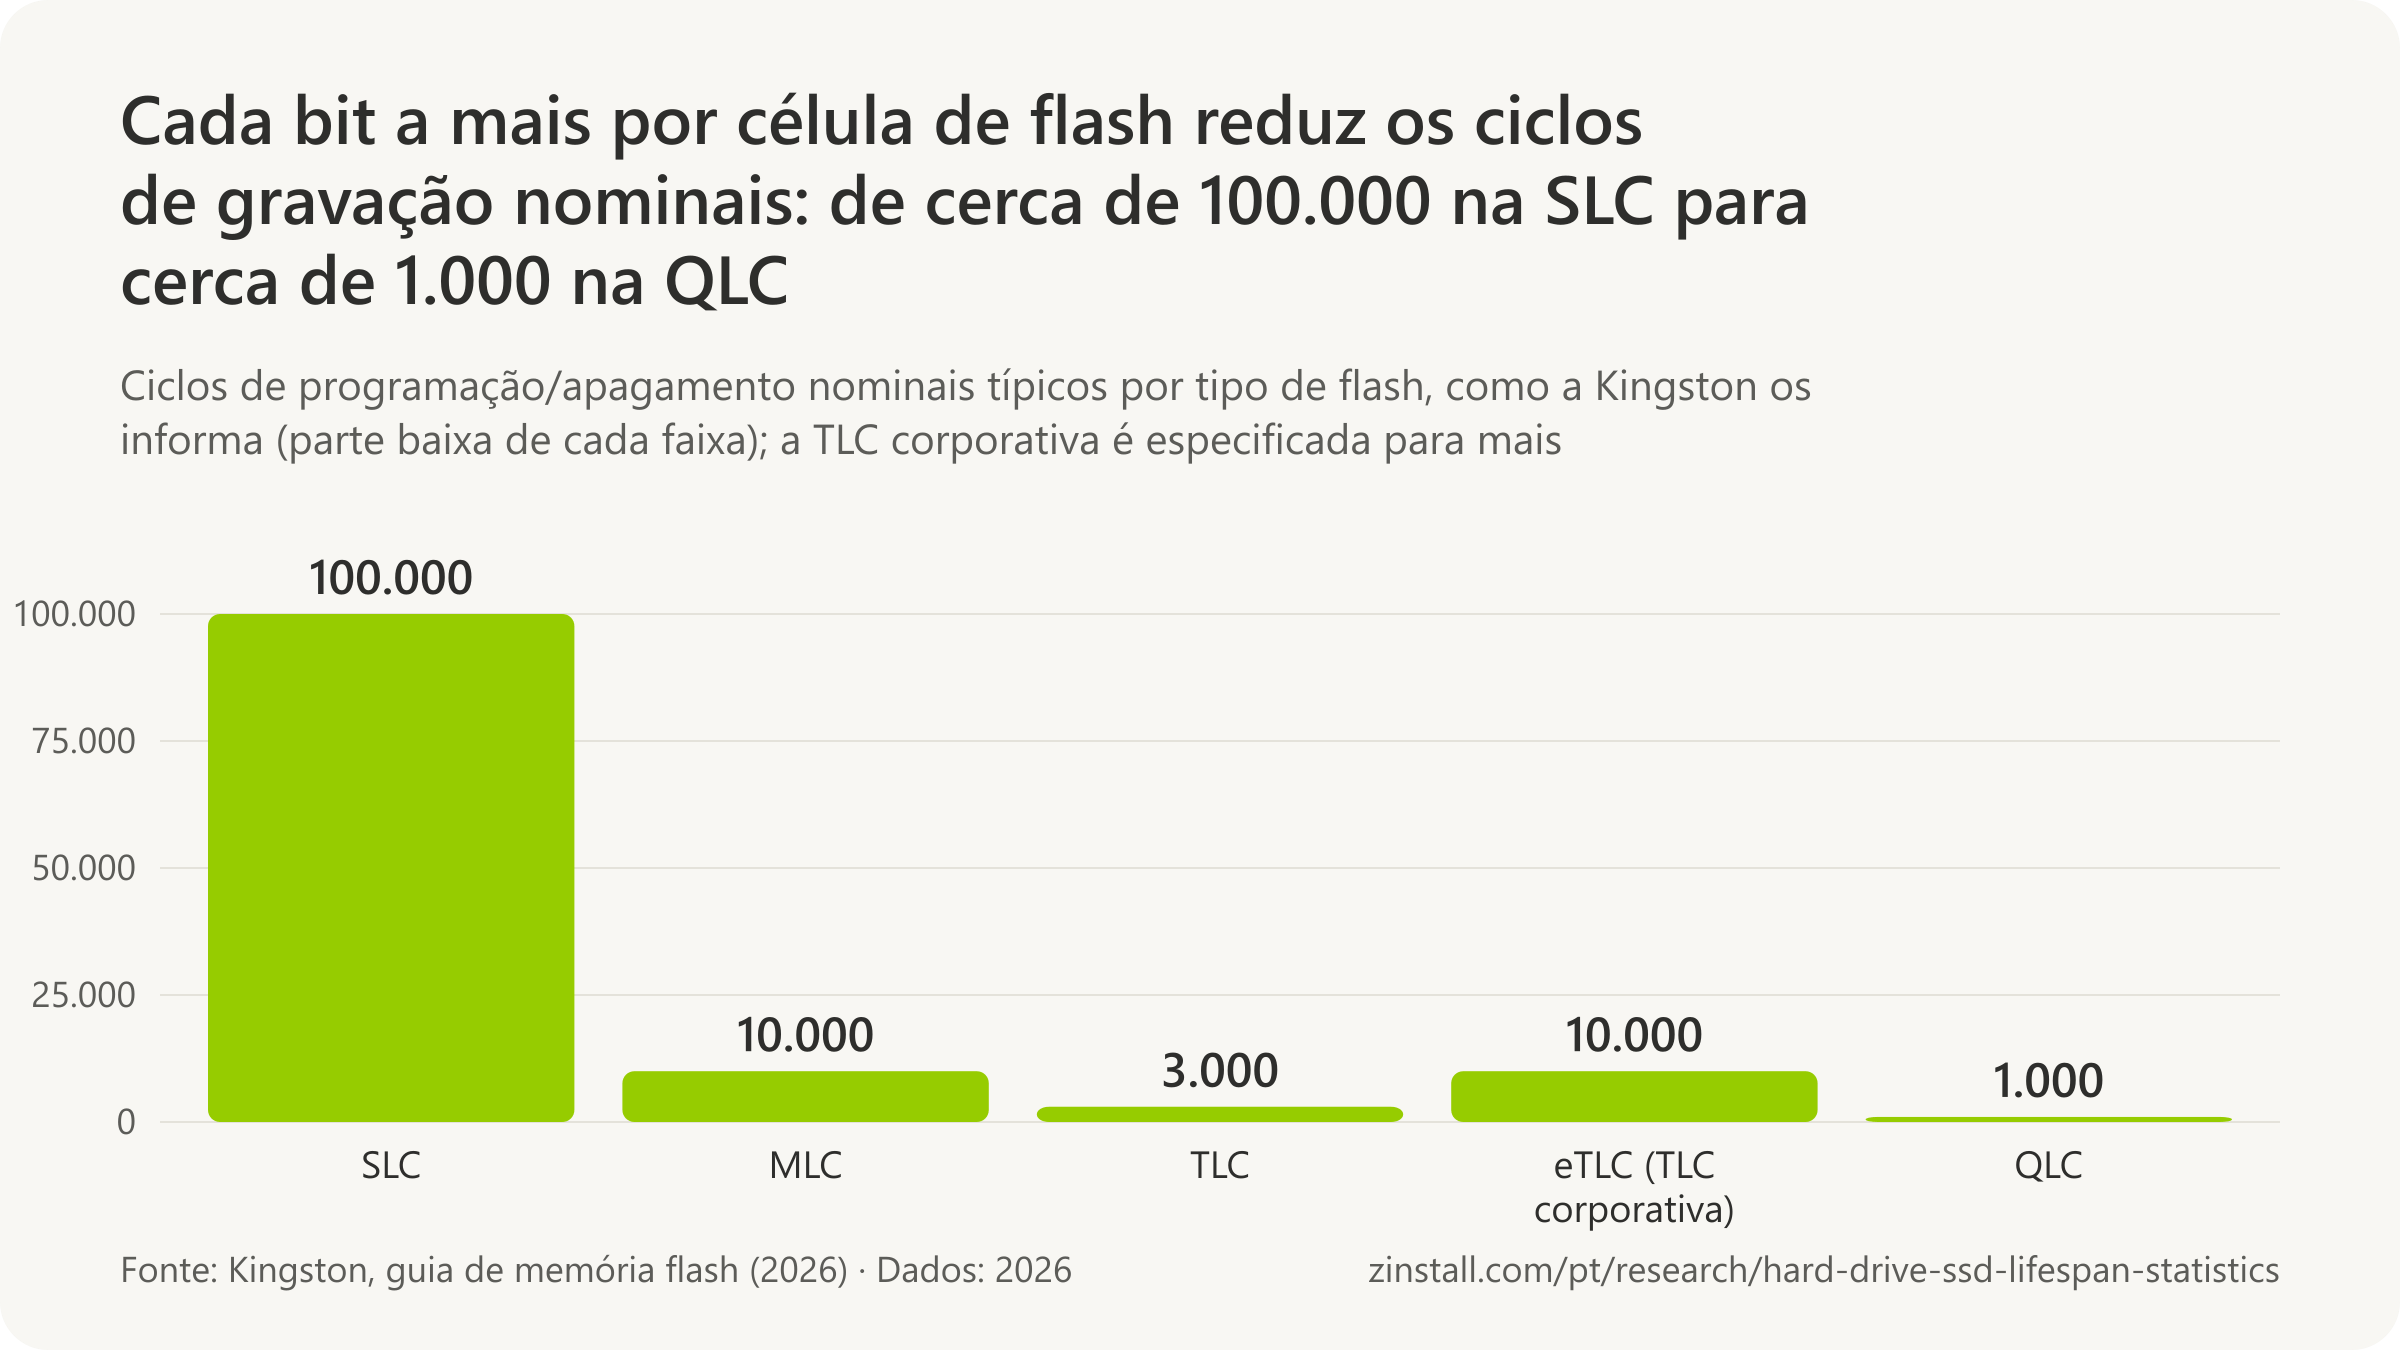
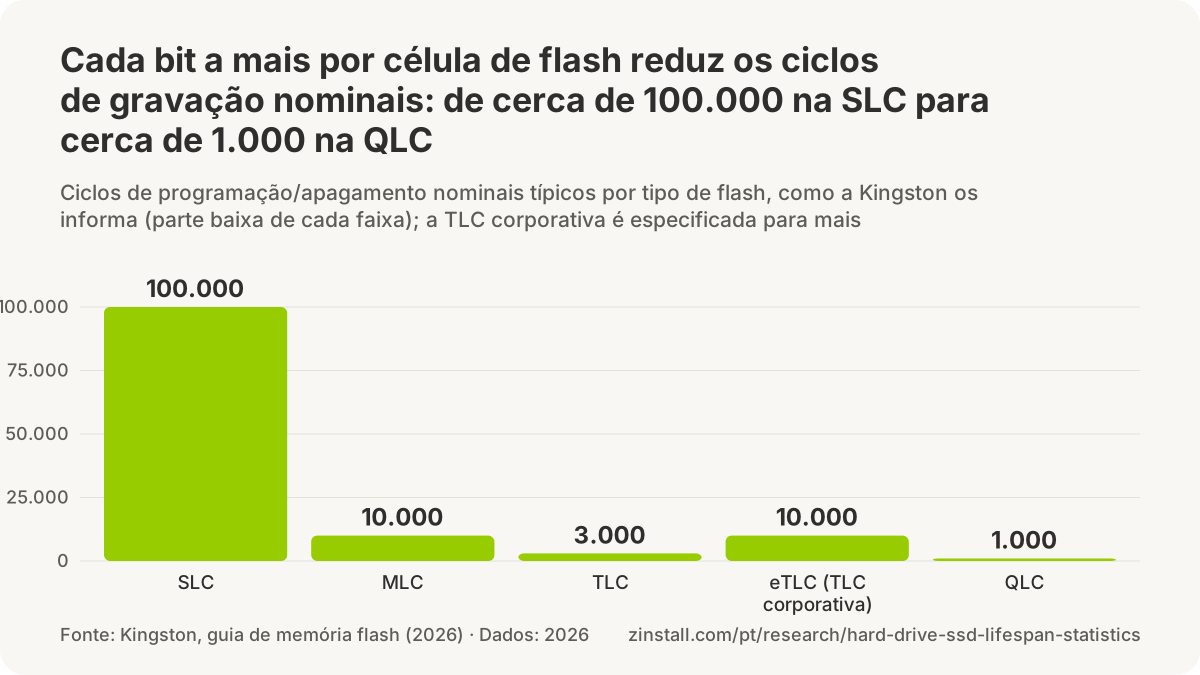

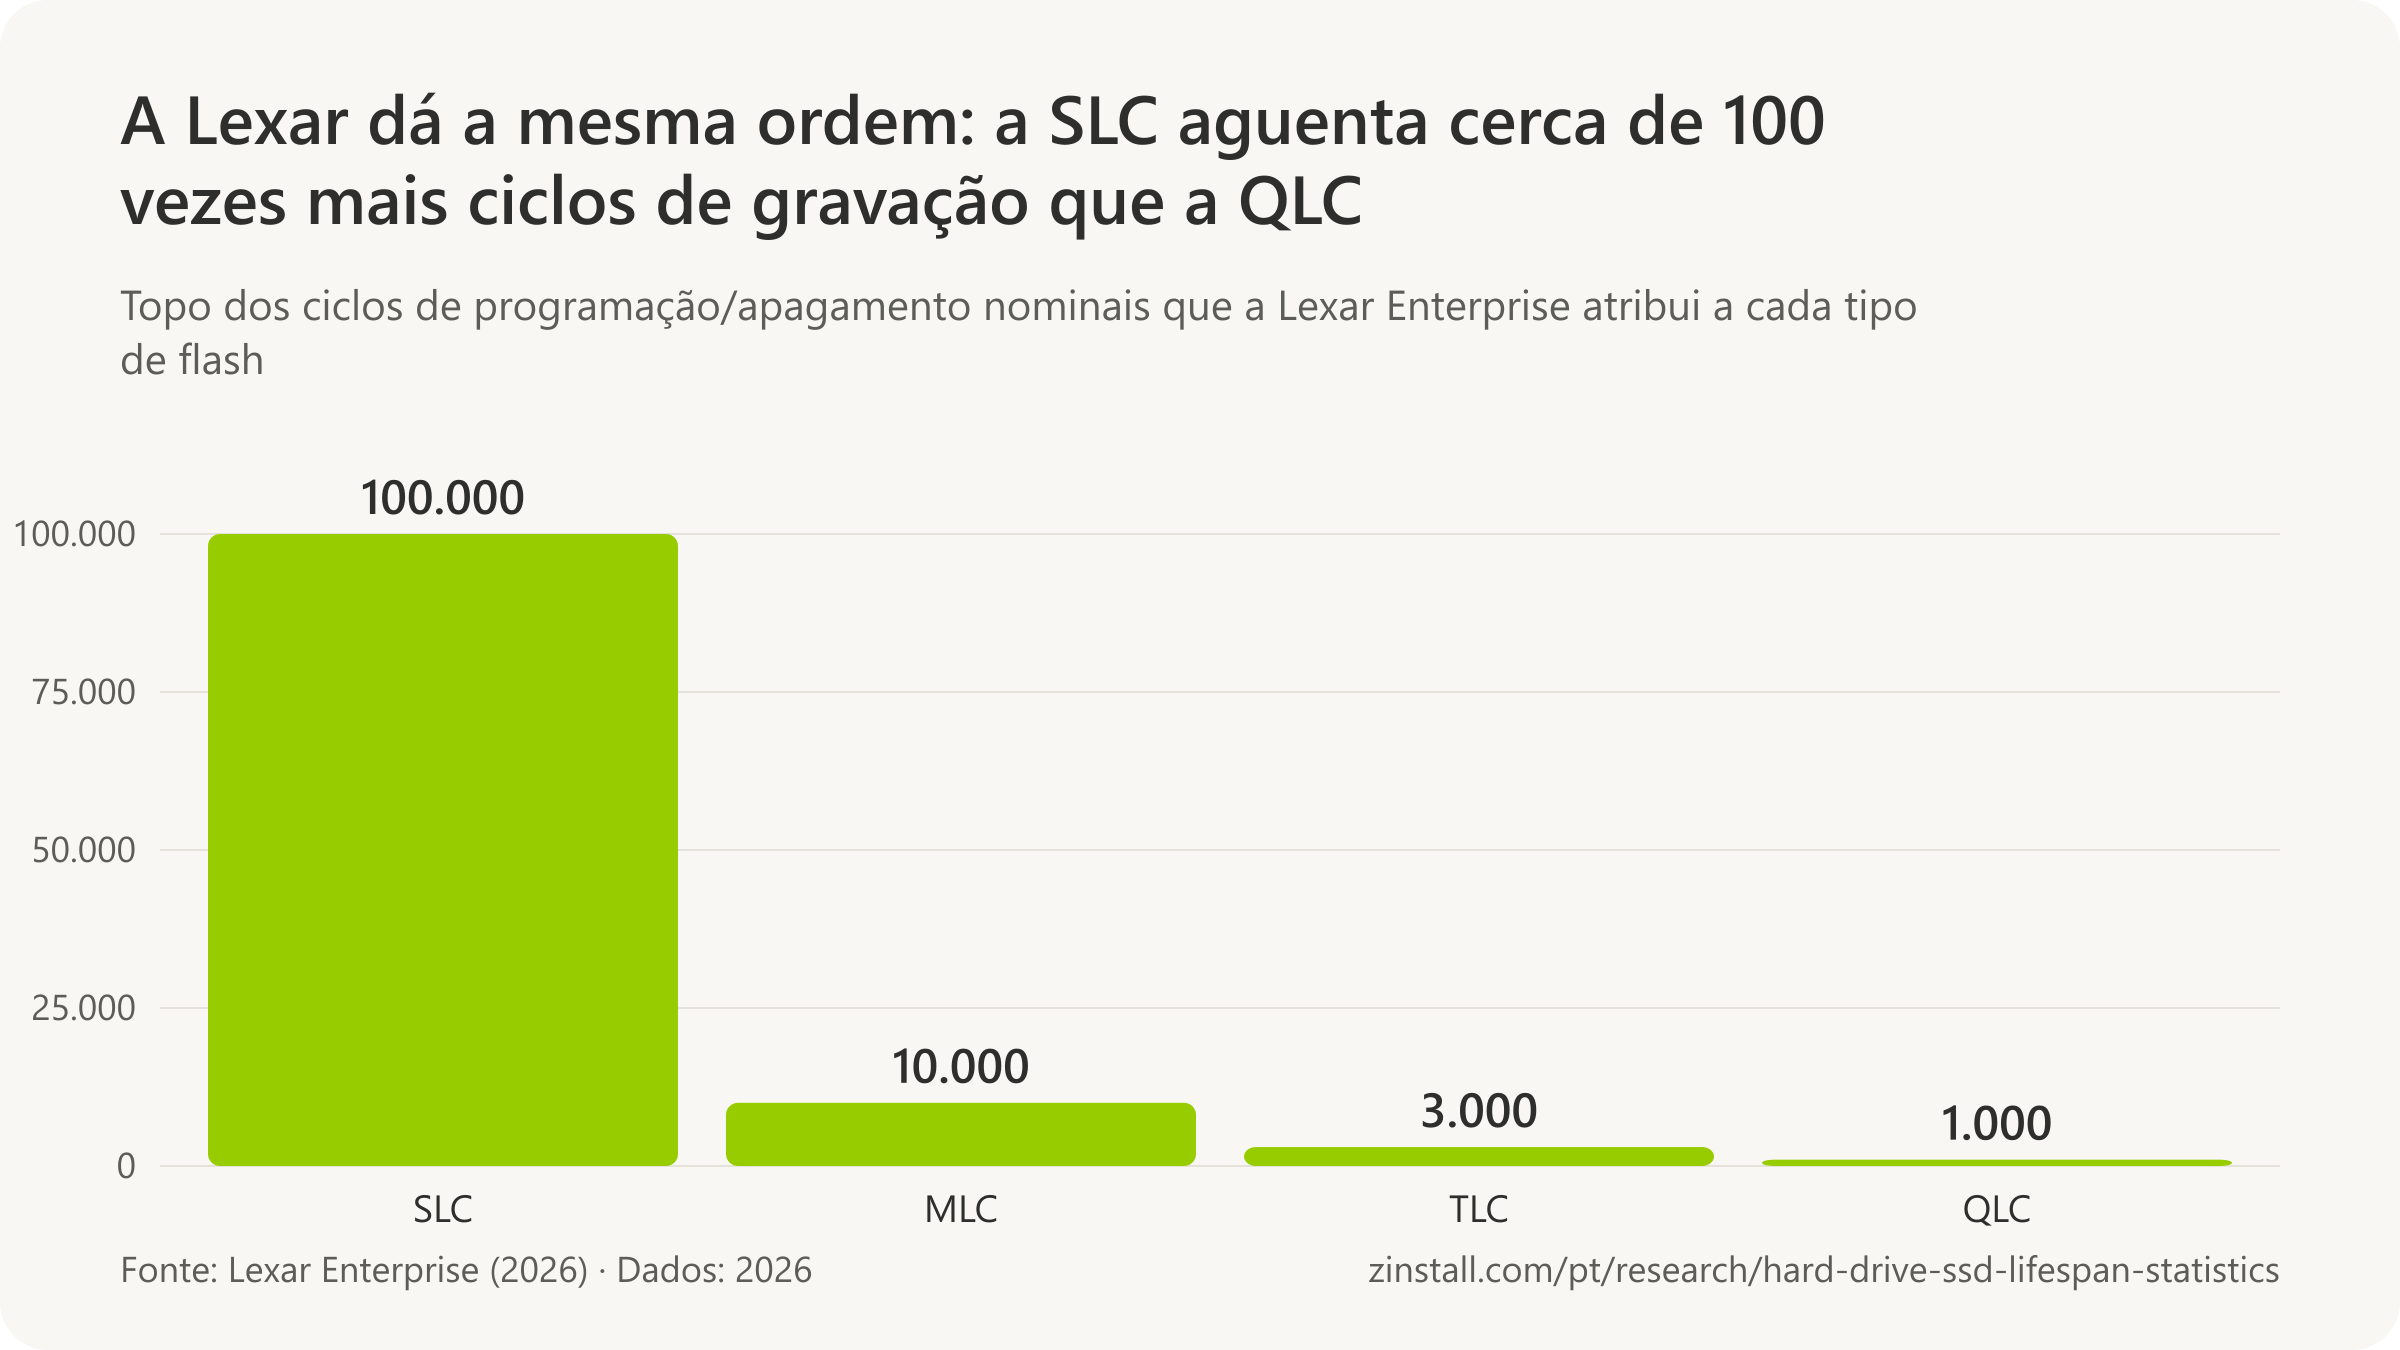
- A Samsung dá ao seu SATA 870 EVO e ao seu NVMe 990 PRO as mesmas classificações: 600 TBW por terabyte, cinco anos e 1,5 milhão de horas de MTBF, então as classificações do fabricante não favorecem o NVMe em relação ao SATA (derivado das fichas técnicas da Samsung, 2021 e 2022).
As normas do JEDEC por trás das classificações
- A classe de consumo (client) da JESD218 do JEDEC supõe um SSD em uso 8 horas por dia a 40 °C (JEDEC, 2010).
- A classe corporativa (enterprise) da JESD218 do JEDEC supõe um SSD em uso 24 horas por dia a 55 °C (JEDEC, 2010).
- A JESD218 do JEDEC permite que no máximo 3% dos SSDs de consumo (client) ou corporativos tenham falha funcional até atingirem a resistência nominal (requisito de falha funcional) (JEDEC, 2010).
- A revisão atual da norma de resistência de SSDs do JEDEC é a JESD218C.01, publicada em agosto de 2026 (JEDEC, 2026).
- A JESD219 do JEDEC classifica a resistência dos SSDs de consumo reproduzindo um trace de comandos registrado no PC de um usuário, enquanto a carga de trabalho corporativa é uma mistura sintética com muitas gravações aleatórias de 4 KB e 8 KB, como descreve a Western Digital (Western Digital, 2023).
- A carga de trabalho de resistência corporativa da JESD219 do JEDEC é toda aleatória, alinhada em 4 KB, com 67% das transferências de 4 KB e metade de todos os acessos dirigidos aos primeiros 5% da unidade (JEDEC, 2010).
Fontes: The Tech Report; heise online / c't magazin (2017, 2021); Samsung Electronics (2022, 2026); Sandisk (2026); Crucial (2021, 2026); Kingston Technology (2024, 2025, 2026); SK hynix; Crucial, Kingston, Samsung, Sandisk, SK hynix; JEDEC Solid State Technology Association (2010, 2026); Micron Technology; Lexar Enterprise; USENIX, Proceedings of the 14th USENIX Conference on File and Storage Technologies; ACM, Proceedings of the 2015 ACM SIGMETRICS International Conference on Measurement and Modeling of Computer Systems; USENIX, Proceedings of the 18th USENIX Conference on File and Storage Technologies; USENIX, Proceedings of the 20th USENIX Conference on File and Storage Technologies; USENIX, Proceedings of the 19th USENIX Conference on File and Storage Technologies; USENIX, Proceedings of the 2022 USENIX Annual Technical Conference; ACM / IEEE, Proceedings of the International Conference; Intel Corporation; Western Digital
O que significam as classificações de MTBF, AFR e garantia?
As unidades costumam atingir em campo 50% a 60% do MTBF projetado, contando todas as devoluções (Seagate, 2026).

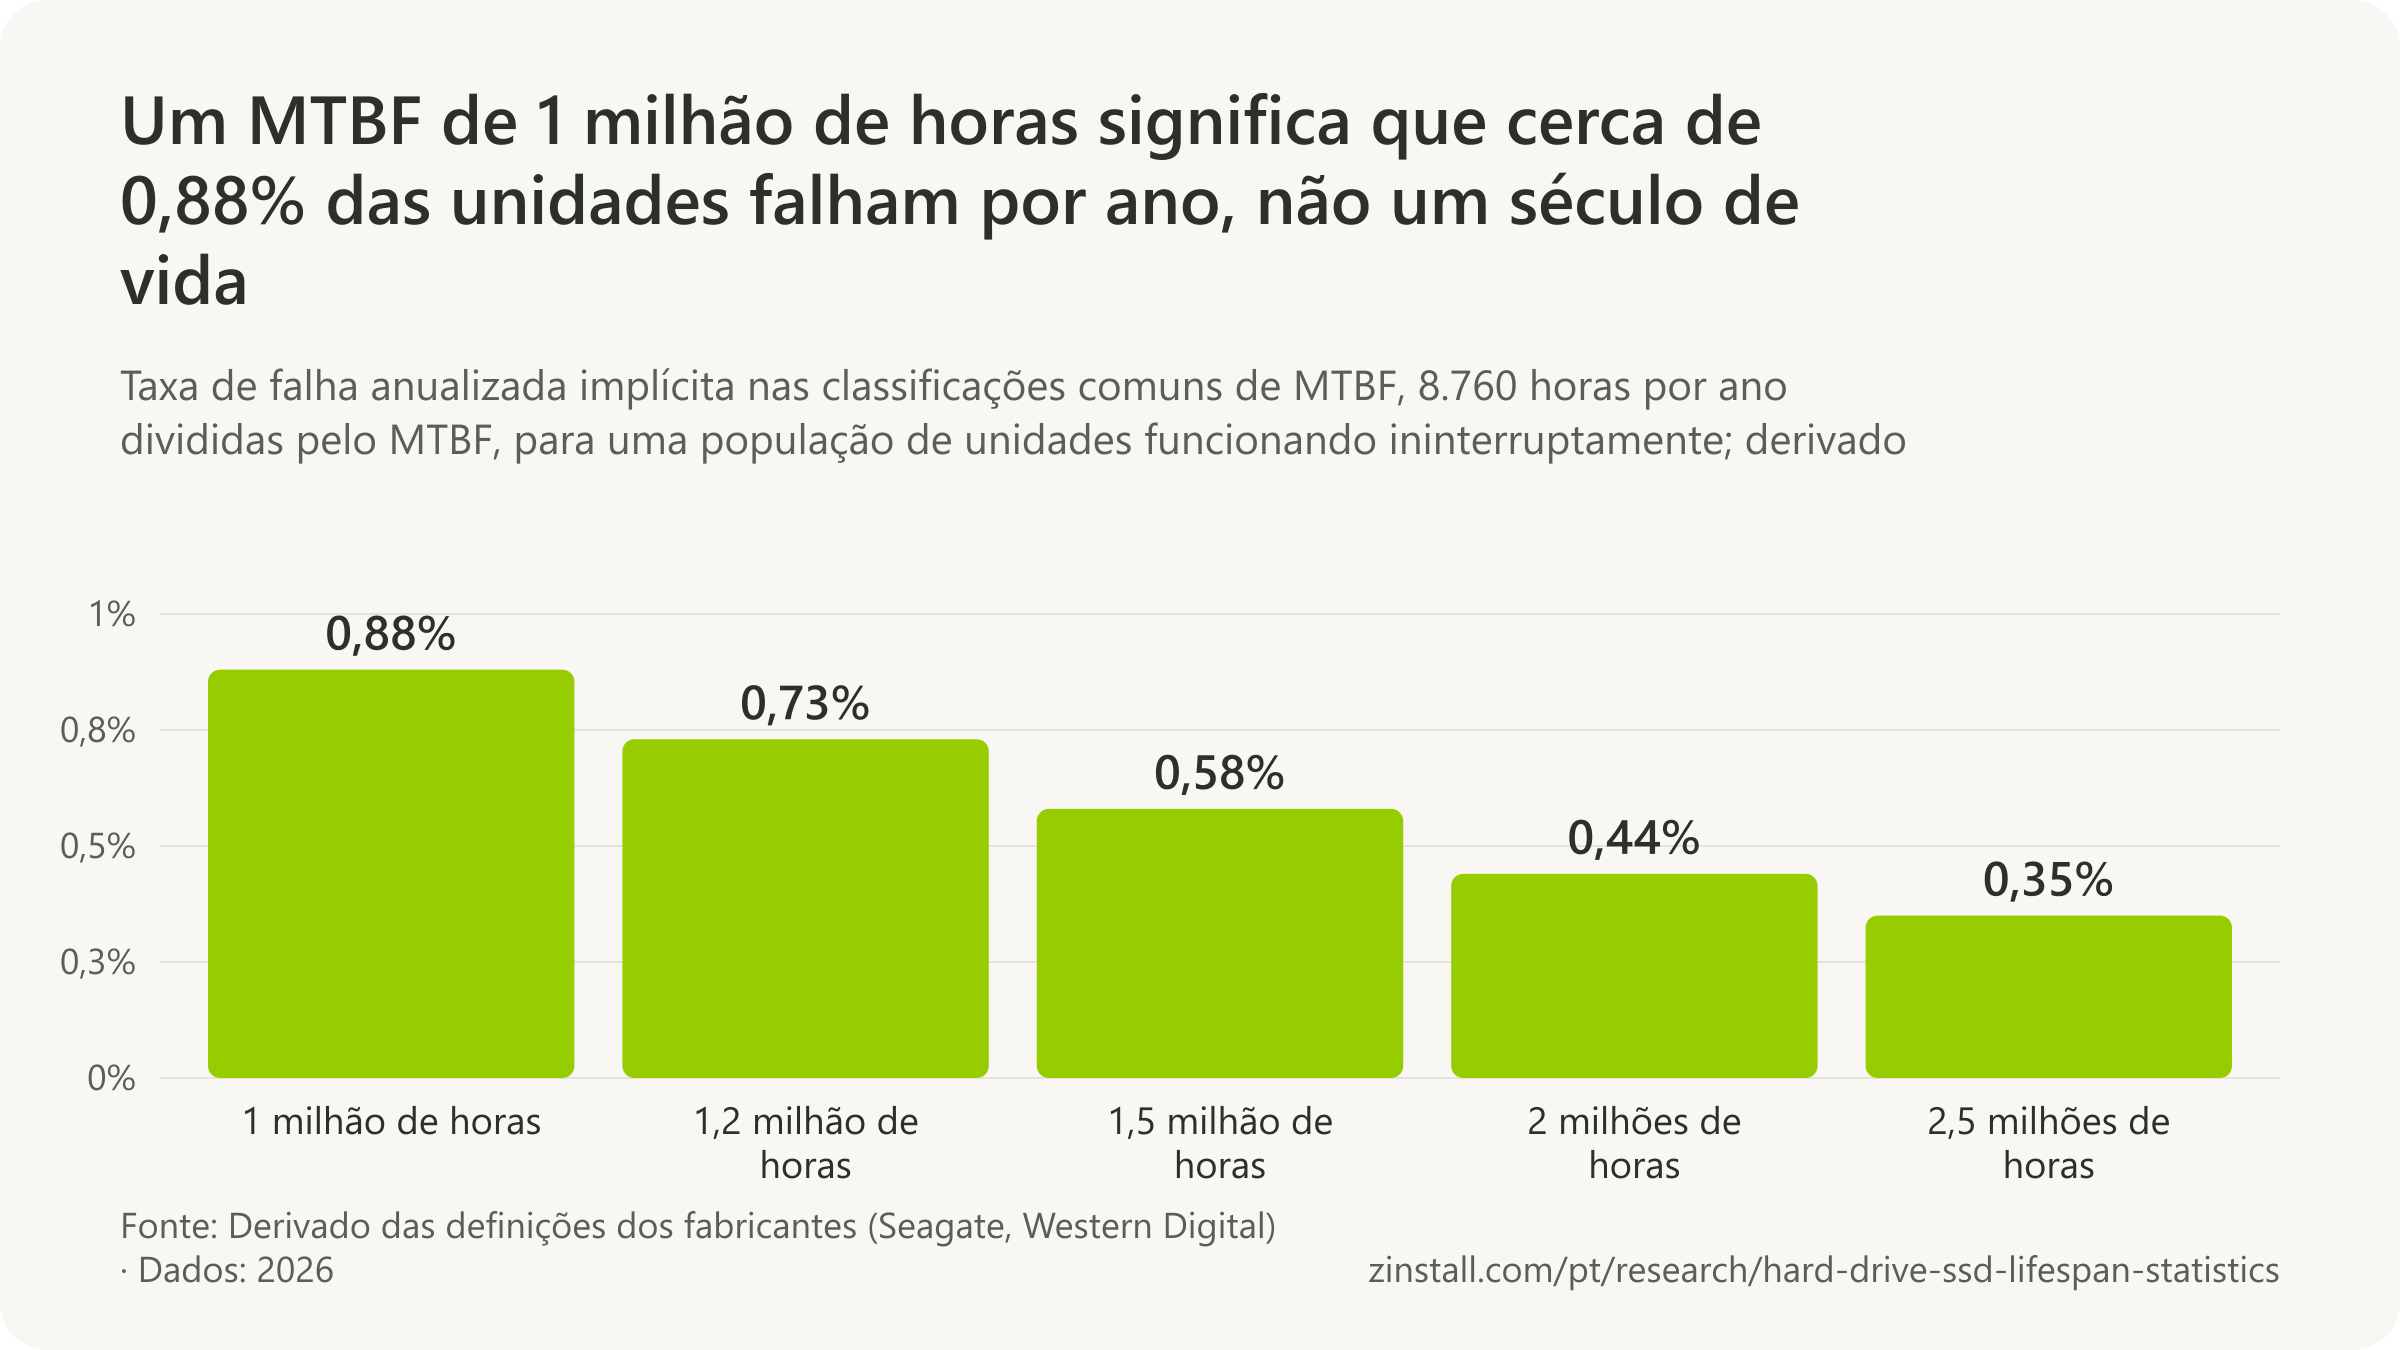
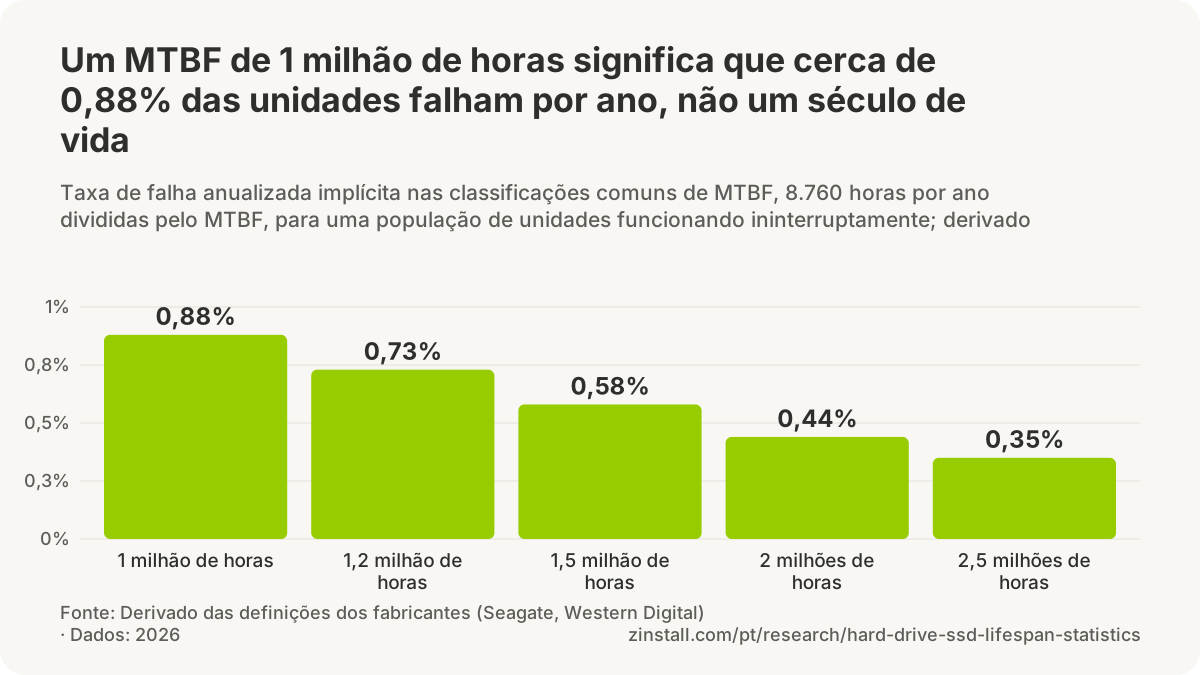
- Um MTBF de 1,5 milhão de horas significa que cerca de 0,58% das unidades falham por ano, não uma vida de 171 anos.
- As especificações dos HDs de desktop supõem 2.400 horas de funcionamento por ano; as classificações corporativas supõem 8.760.
- As taxas de substituição em campo chegaram a 15 vezes a taxa de falha da ficha técnica, em cerca de 100.000 unidades.
- Os HDs de desktop e de notebook têm classificação de 55 TB de leituras e gravações por ano, e os corporativos de até 550.
- As classificações de MTBF de 300.000 a 1.200.000 horas não prometem 30 a 120 anos de funcionamento.
| Linha de unidades e classificação | Classificação |
|---|---|
| Seagate BarraCuda (desktop): garantia | 2 anos |
| Seagate IronWolf Pro (NAS): garantia | 5 anos |
| Seagate IronWolf Pro: MTBF, 2025 | MTBF de 2,5 milhões de horas |
| Seagate IronWolf Pro: MTBF, 2020 | MTBF de 1,2 milhão de horas (AFR de 0,73%) |
| WD Gold (com ar): MTBF | MTBF de 2 milhões de horas (AFR de 0,44%) |
| Toshiba MG11 (corporativo): MTTF | MTTF de 2,5 milhões de horas (AFR de 0,35%) |
| Seagate BarraCuda: erros de leitura irrecuperáveis | 1 a cada 10^14 bits |
| Seagate IronWolf Pro: erros de leitura irrecuperáveis | 1 a cada 10^15 bits |
| Seagate: temperaturas que reduzem a confiabilidade | Acima de 50 °C ou abaixo de 5 °C |
| Crucial MX500: MTTF rotulado como “expectativa de vida” | MTTF de 1,8 milhão de horas |
Fontes: Seagate Technology (2015-2026); Carnegie Mellon University; Western Digital (2026, 2025, 2022); Toshiba Electronic Devices & Storage Corporation; Crucial; Samsung Electronics
Guias relacionados: Faça backup do PC inteiro · Backup em um HD externo
Mais estatísticas (48)
O MTBF, tempo médio entre falhas, é uma classificação de população: ele diz que parcela de um grande grupo de unidades funcionando ininterruptamente deve falhar num ano, não quanto tempo uma unidade vai durar. As próprias páginas dos fabricantes dizem isso, e os estudos de campo encontraram taxas de falha reais bem acima das nominais. Os HDs de desktop muitas vezes nem têm MTBF, supõem uso em tempo parcial e vêm com garantia de dois anos; as unidades para NAS e as corporativas têm classificações para mais horas, mais dados e garantias mais longas.
O que significam MTBF e AFR
- De 0,58% a 0,88% ao ano é a taxa de falha implícita nos MTTFs de ficha técnica de 1.000.000 a 1.500.000 horas, as classificações das unidades que a Carnegie Mellon estudou (Carnegie Mellon University, 2007).
- As taxas anuais de substituição observadas em campo chegaram a até 15 vezes a taxa de falha da ficha técnica, por conjunto de dados e tipo de unidade, em cerca de 100.000 HDs (Carnegie Mellon University, 2007).
- As taxas de substituição em campo dos HDs com menos de cinco anos foram de 2 a 10 vezes a taxa sugerida pelo MTTF da sua ficha técnica, em cerca de 100.000 unidades (Carnegie Mellon University, 2007).
- As taxas de substituição em campo dos HDs de cinco a oito anos foram 30 vezes a taxa sugerida pelo MTTF da sua ficha técnica (Carnegie Mellon University, 2007).
- Um MTBF de 1 milhão de horas não significa que um HD vai funcionar por um século: a Seagate diz que o número deixa de fora as falhas precoces e as de desgaste e que é “baseado mais em extrapolação do que em observação” (Seagate, 2015).
- A Samsung classifica o SSD 990 PRO com 1,5 milhão de horas de MTBF (tempo médio entre falhas, uma classificação de população, não uma vida útil) (Samsung, 2022).
- A Samsung classifica o SSD SATA 870 EVO com 1,5 milhão de horas de MTBF (tempo médio entre falhas, uma classificação de população, não uma vida útil) (Samsung, 2021).
- A Kingston classifica o SSD NV3 com 2.000.000 horas de MTBF (tempo médio entre falhas, uma classificação de população, não uma vida útil) (Kingston, 2025).
- A SK hynix classifica o SSD Platinum P41 com 1,5 milhão de horas de MTBF e uma taxa de erro de bits de 1 erro a cada 10^15 bits transferidos (SK hynix, 2026).
- A Crucial rotula a classificação de MTTF de 1,8 milhão de horas do MX500 como a sua “expectativa de vida”, embora o MTTF seja uma classificação de taxa de falha de população, e não a vida de uma unidade (Crucial, 2021).
- A Seagate classifica os seus HDs para NAS IronWolf com 1 milhão de horas de MTBF (tempo médio entre falhas, uma classificação de população, não uma vida útil), supondo 8.760 horas de funcionamento por ano (Seagate, 2022).
- A Seagate classifica os seus HDs para NAS IronWolf Pro com 2,5 milhões de horas de MTBF (tempo médio entre falhas, uma classificação de população, não uma vida útil), supondo 8.760 horas de funcionamento por ano (Seagate, 2025).
- A Seagate classificava os seus HDs para NAS IronWolf Pro de 2 TB a 16 TB com 1,2 milhão de horas de MTBF, equivalente a uma especificação de taxa de falha anualizada de 0,73%, com limite de carga de trabalho de 300 TB por ano (Seagate, 2020).
- A Seagate classifica os seus HDs corporativos Exos X24 com 2,5 milhões de horas de MTBF, equivalente a uma especificação de taxa de falha anualizada de 0,35% em operação plena 24x7 (8.760 horas de funcionamento por ano) (Seagate, 2023).
- A Seagate classifica os seus HDs para vigilância SkyHawk com 1 milhão de horas de MTBF (tempo médio entre falhas, uma classificação de população, não uma vida útil), supondo 8.760 horas de funcionamento por ano (Seagate, 2021).
- A Seagate classifica os seus HDs para vigilância SkyHawk AI com 2,5 milhões de horas de MTBF (tempo médio entre falhas, uma classificação de população, não uma vida útil), supondo 8.760 horas de funcionamento por ano (Seagate, 2025).
- A WD classifica os seus HDs para NAS WD Red Plus com 1 milhão de horas de MTBF (tempo médio entre falhas, uma classificação de população, não uma vida útil) (Western Digital, 2025).
- A WD estima a classificação de MTBF do WD Red Plus com uma carga de trabalho de 90 TB por ano a uma temperatura da unidade de 40 °C, reduz a classificação acima dessas condições e afirma que o MTBF não prevê a confiabilidade de uma unidade individual (Western Digital, 2025).
- A WD classifica os seus HDs para NAS WD Red Pro com até 2,5 milhões de horas de MTBF (modelos com hélio de 14 TB ou mais; 2 milhões de horas para os modelos com ar), uma classificação de população, não uma vida útil (Western Digital, 2025).
- A WD classifica os seus HDs corporativos WD Gold com hélio com 2,5 milhões de horas de MTBF, equivalente a uma especificação de taxa de falha anualizada de 0,35% (Western Digital, 2025).
- A WD classifica os seus HDs corporativos WD Gold com ar (de 1 TB a 12 TB) com 2 milhões de horas de MTBF e uma especificação de taxa de falha anualizada de 0,44%, contra 2,5 milhões de horas e 0,35% dos seus modelos com hélio (Western Digital, 2025).
- A WD classifica os seus HDs de data center Ultrastar DC HC690 (30 TB e 32 TB, SMR) com um MTBF projetado de 2,5 milhões de horas, equivalente a uma especificação de taxa de falha anualizada de 0,35%, para disponibilidade 24x7 (Western Digital, 2024).
- A Toshiba classifica os seus HDs para NAS N300 de 14 TB ou mais com 1,2 milhão de horas de MTTF (tempo médio até a falha, uma classificação de população, não uma vida útil), e os modelos de 6 TB a 12 TB com 1 milhão de horas (Toshiba, 2026).
- A Toshiba classifica os seus HDs corporativos MG11 com 2,5 milhões de horas de MTTF/MTBF, equivalente a uma especificação de taxa de falha anualizada de 0,35%, supondo 8.760 horas de funcionamento por ano a 40 °C e 550 TB por ano (Toshiba, 2024).
- A Seagate diz que, historicamente, o MTBF que as suas unidades atingem em campo, contando todas as devoluções, qualquer que seja a causa, costuma ficar entre 50% e 60% do MTBF projetado (Seagate, acessado em 2026).
- As especificações de AFR e MTBF da Seagate para armazenamento crítico para os negócios supõem 8.760 horas de funcionamento por ano, isto é, 24 horas por dia o ano todo, e 250 ciclos de partida/parada do motor por ano (Seagate, acessado em 2026).
- A Seagate diz que as classificações de MTBF de 300.000 a 1.200.000 horas não prometem 30 a 120 anos de funcionamento contínuo: a classificação descreve a confiabilidade relativa de uma família de unidades e não é uma garantia (Seagate, acessado em 2026).
- A Western Digital diz que as suas classificações de MTBF e AFR são estimadas a partir de uma população de amostra, com medições estatísticas e algoritmos de aceleração, a uma temperatura da unidade de 40 °C, e que não preveem a confiabilidade de uma unidade individual nem constituem uma garantia (Western Digital, 2022).
- O glossário da Crucial define o MTBF como o tempo entre uma falha de dados e a seguinte numa unidade de armazenamento de computador, um texto que se lê como um intervalo por unidade, e não como a classificação de população que ele é (Crucial, acessado em 2026).
- Um MTBF de 1,5 milhão de horas não significa que uma unidade dura 171 anos (1.500.000 / 8.760): significa que cerca de 0,58% de uma grande população dessas unidades deveria falhar por ano de uso ininterrupto dentro da vida útil nominal (derivado de dados da Seagate, acessado em 2026).
Classificações por linha de unidades

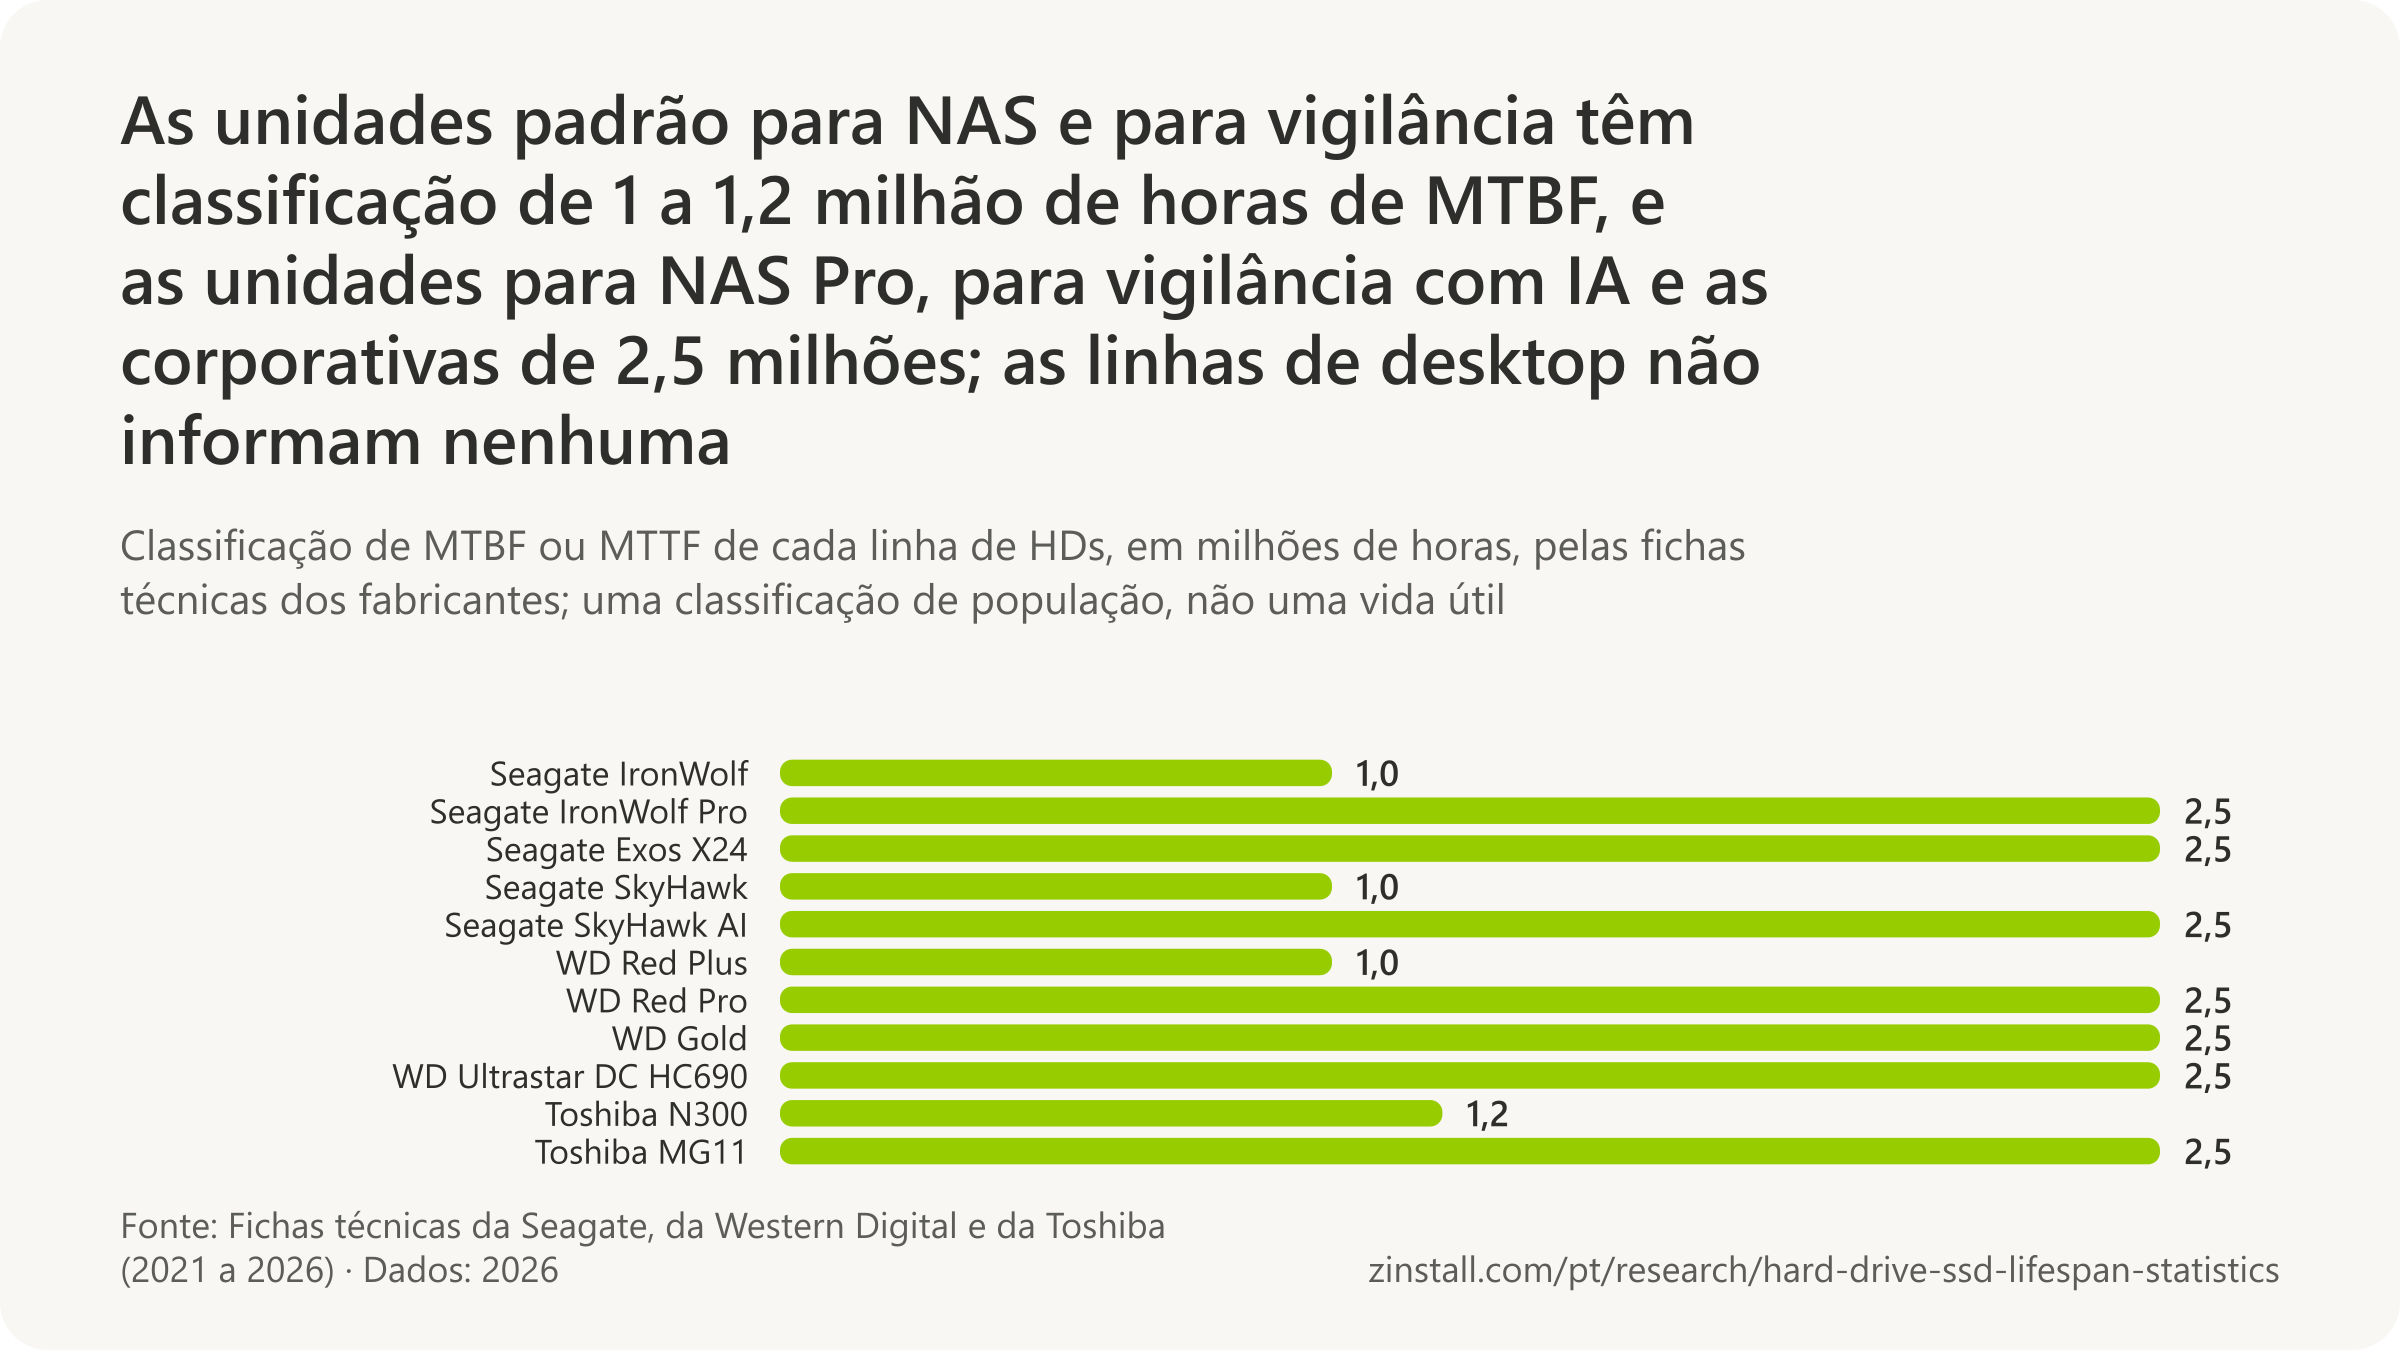

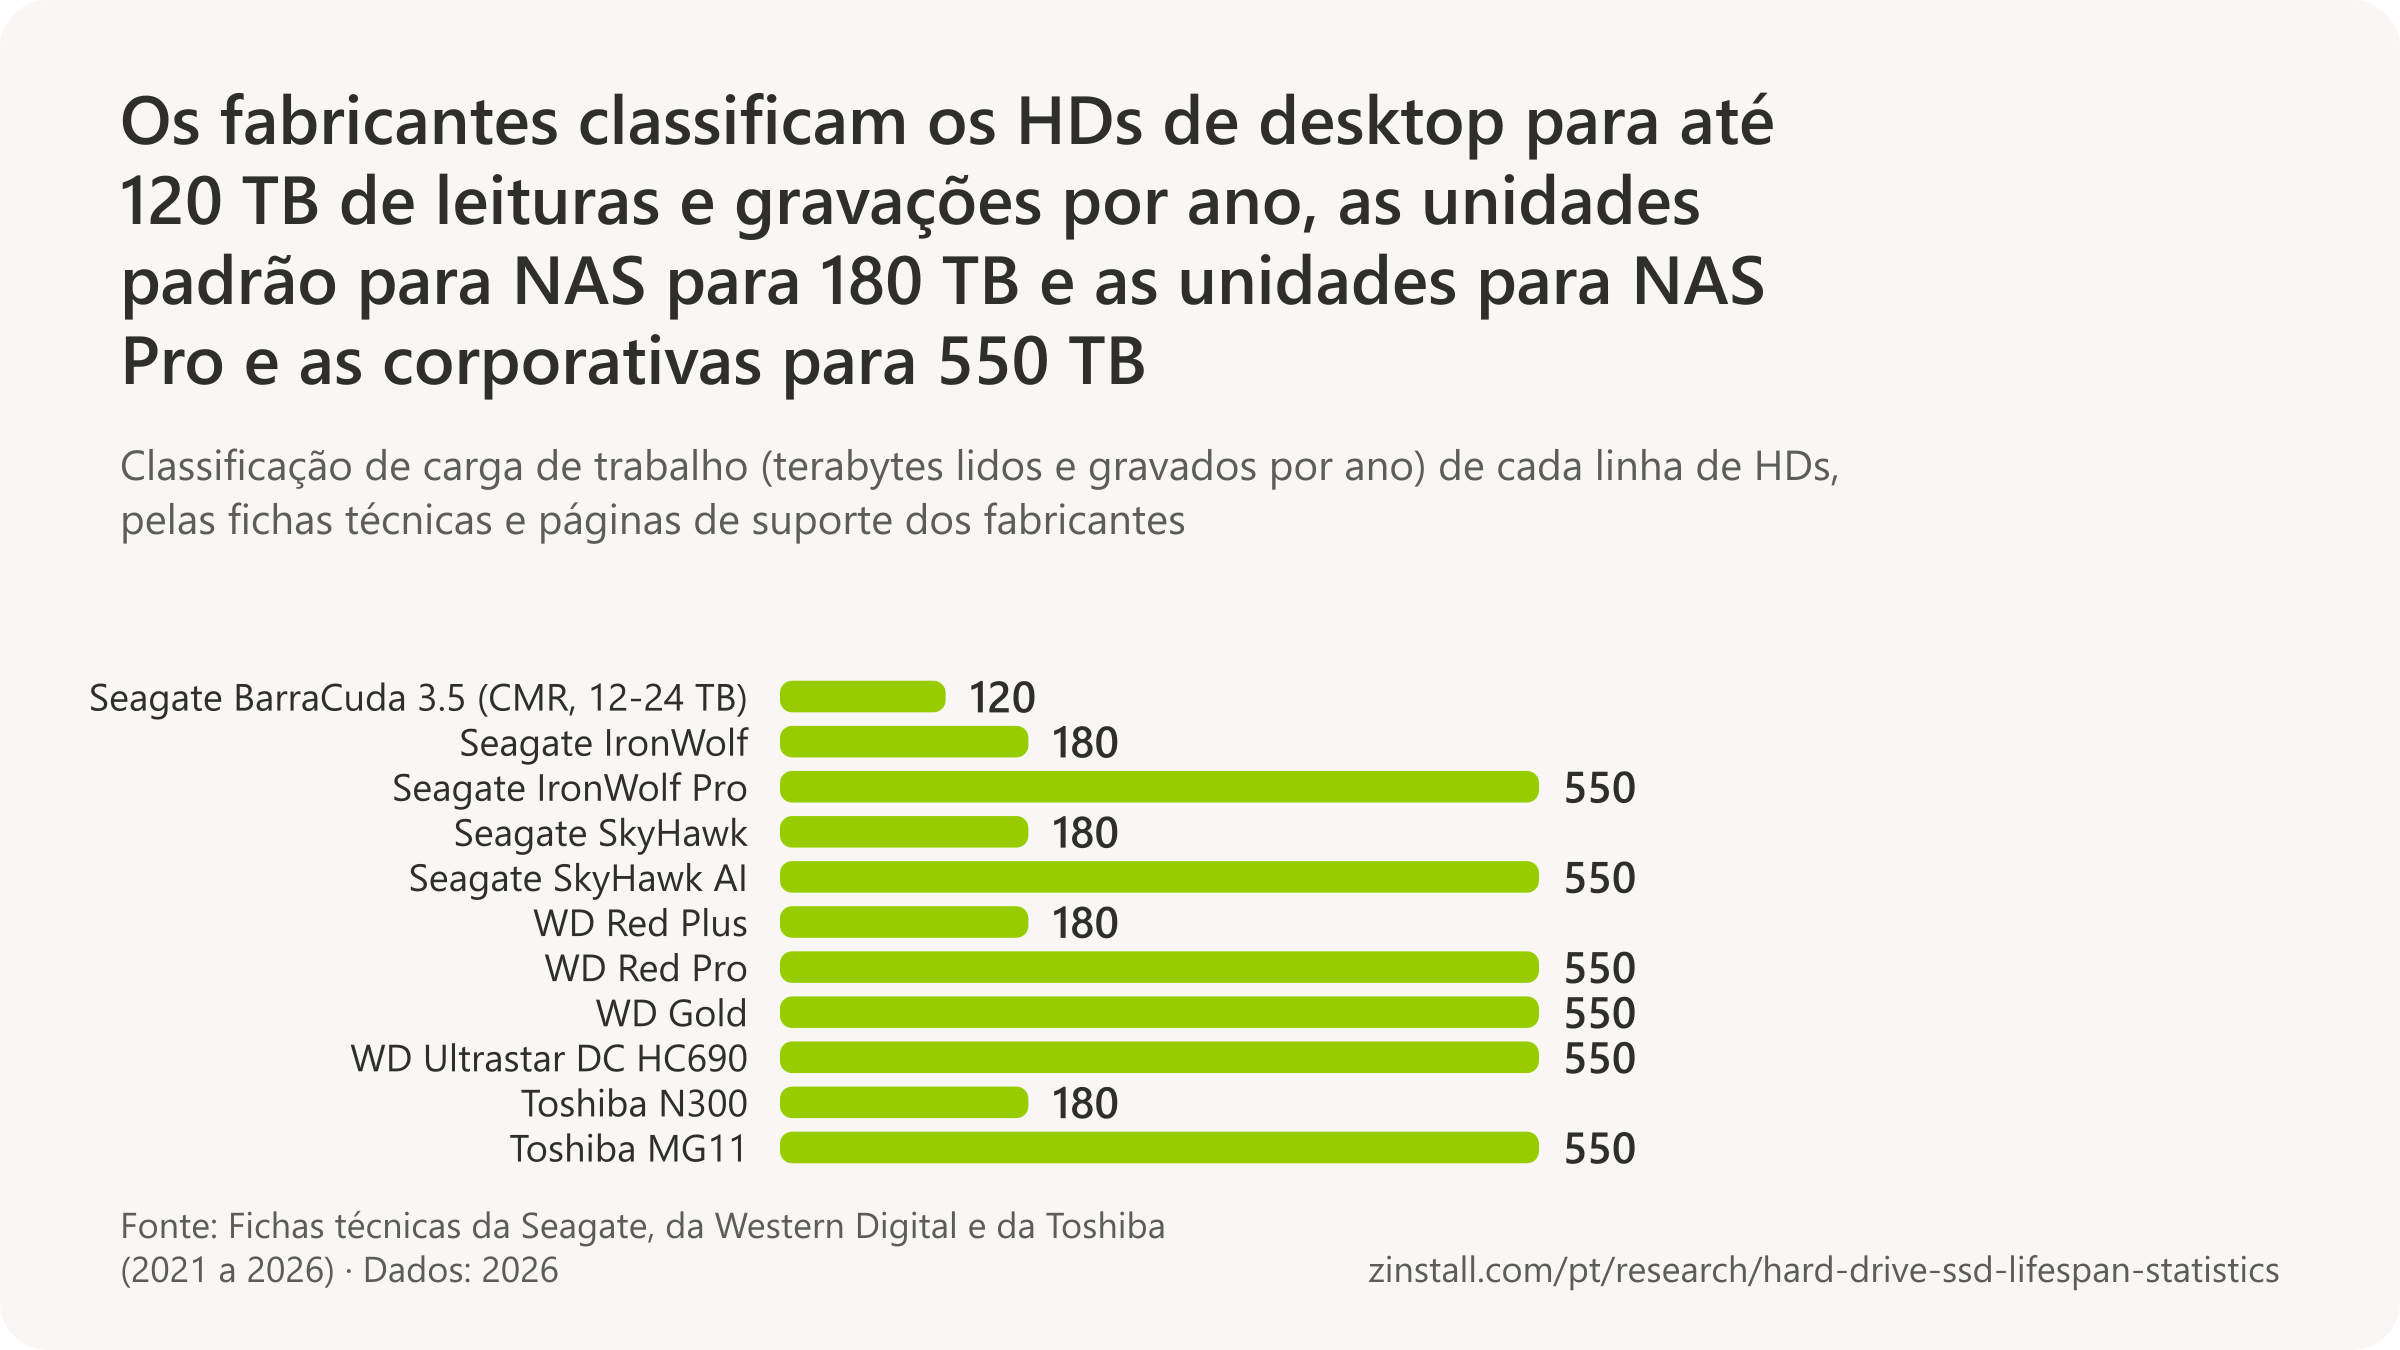
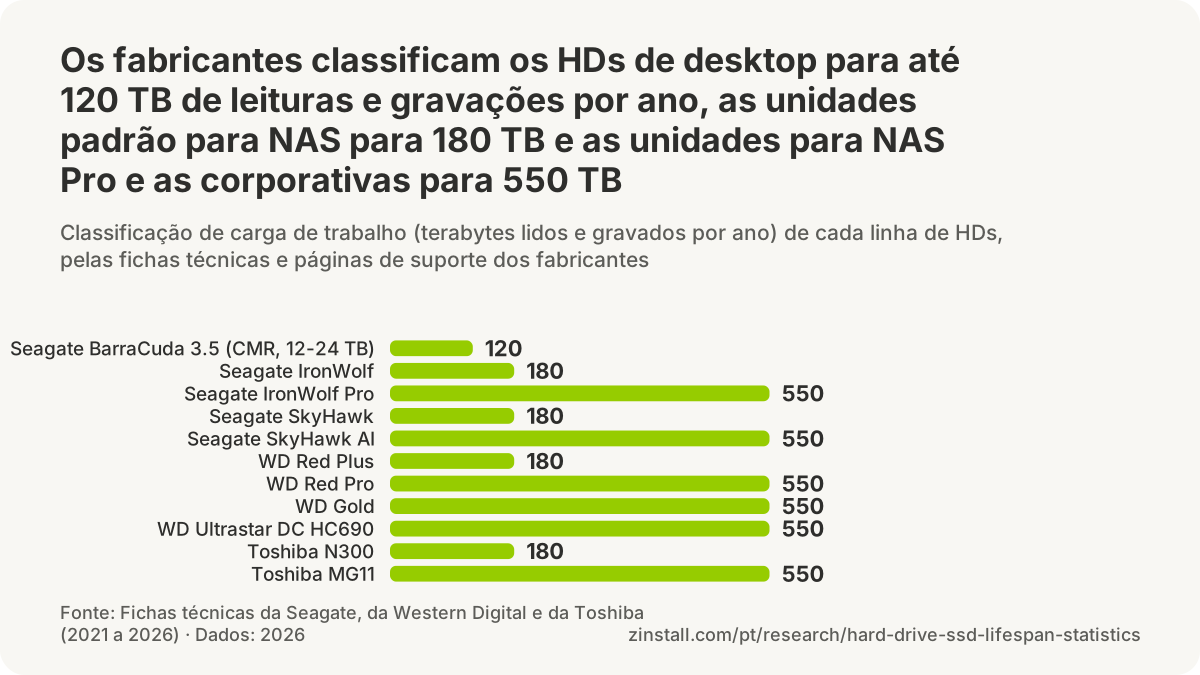

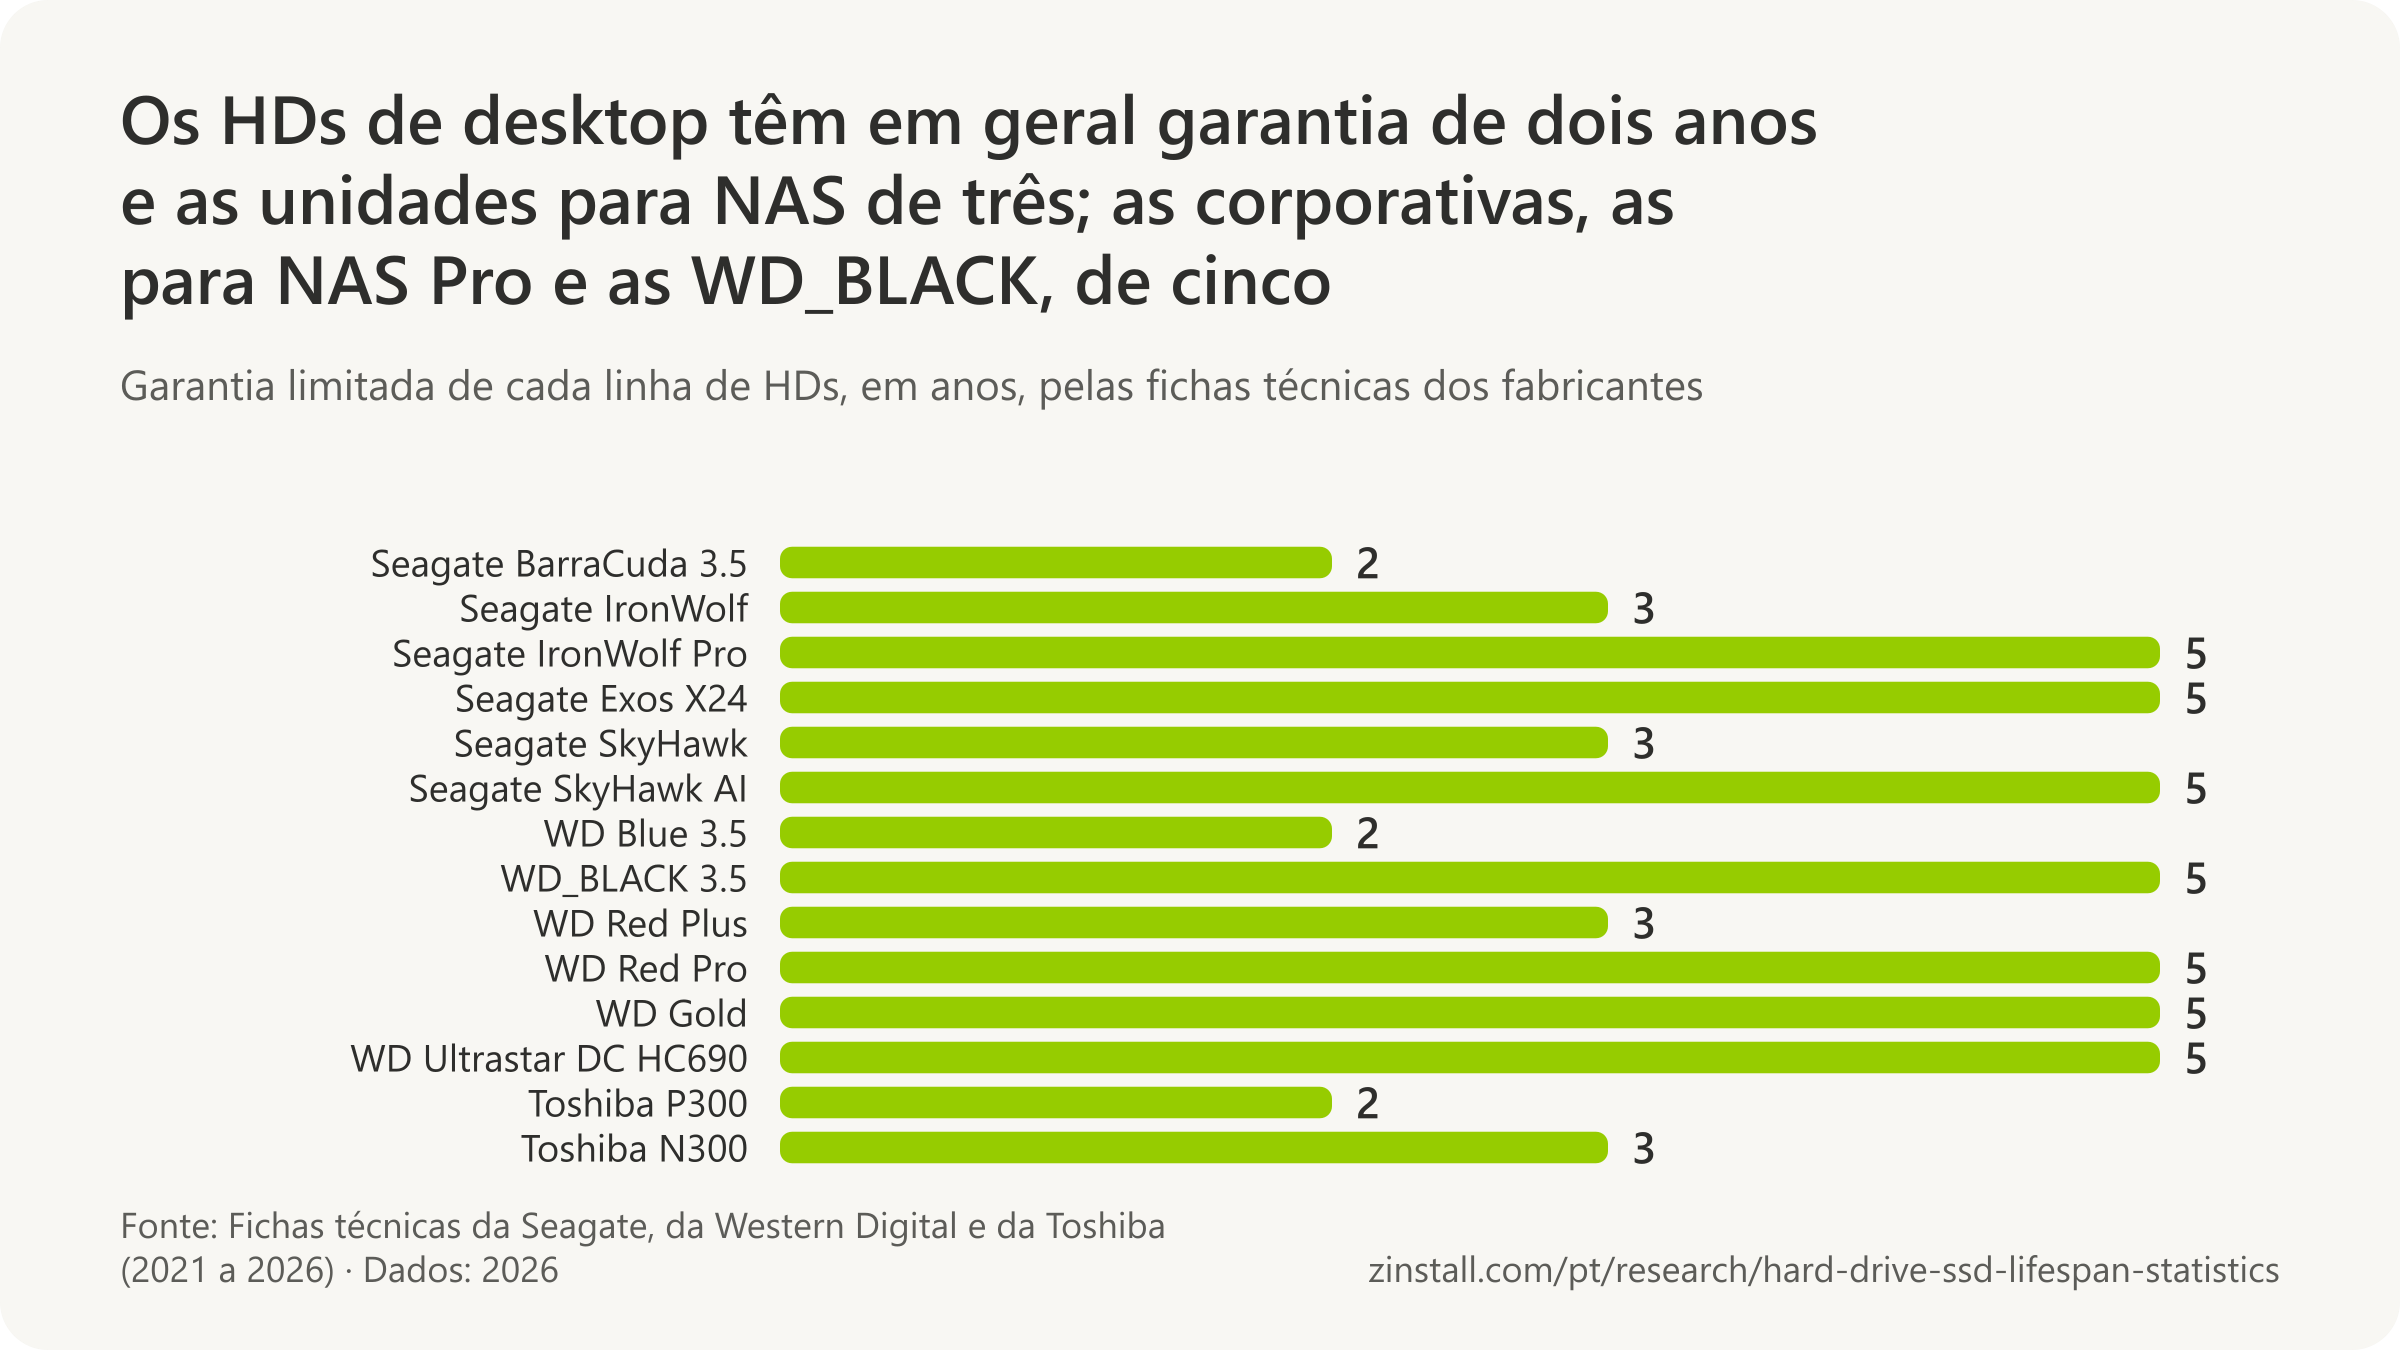
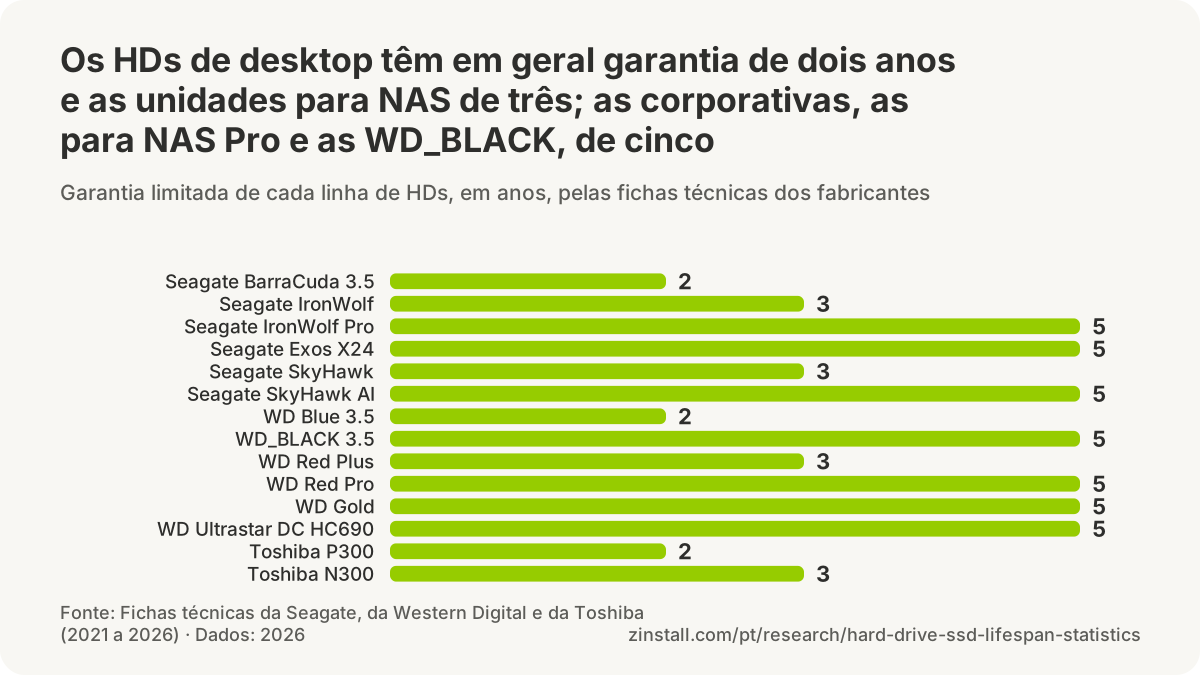
- A Seagate classifica os seus HDs de desktop e de notebook para uma carga de trabalho de 55 TB por ano (leituras mais gravações), os de NAS, vigilância e arquivamento para 180 TB e os corporativos para 300 a 550 TB, e diz que a confiabilidade cai acima do limite (Seagate, 2015).
- As especificações da Seagate para os seus HDs de desktop BarraCuda de 3,5 polegadas supõem 2.400 horas de funcionamento por ano (Seagate, 2026).
- A Seagate classifica os HDs de desktop BarraCuda de 3,5 polegadas para 600.000 ciclos de carga/descarga (load/unload) das cabeças de leitura e gravação (Seagate, 2026).
- A Seagate define um limite de taxa de carga de trabalho de menos de 550 TB por ano para as suas unidades nearline de capacidade corporativa e diz que, acima do limite, a confiabilidade da unidade começa a cair (Seagate, 2026).
- A Seagate define um limite de taxa de carga de trabalho de menos de 180 TB por ano para o seu segmento de unidades “nearline lite” (Seagate, 2026).
- A WD classifica os HDs de desktop WD Blue de 3,5 polegadas para 300.000 ciclos de carga/descarga (Western Digital, 2025).
- A WD classifica os HDs para NAS WD Red Plus para 600.000 ciclos de carga/descarga (Western Digital, 2025).
- A WD classifica os HDs de data center Ultrastar DC HC690 para 600.000 ciclos de carga/descarga a 40 °C (Western Digital, 2024).
Limites de temperatura e especificações de erros de leitura
- Cinco eventos de erro de leitura (quatro claros, um suspeito) ocorreram enquanto 2 petabytes passavam por unidades SATA, quando a especificação de erro de bits das unidades previa 112, no teste da Microsoft Research (Microsoft Research, 2005).
- A Seagate especifica no máximo um erro de leitura irrecuperável a cada 10^14 bits lidos para os seus HDs de desktop BarraCuda de 3,5 polegadas (Seagate, 2026).
- A Seagate desaconselha manter as unidades para NAS IronWolf em temperaturas sustentadas acima de 60 °C, dizendo que temperaturas mais altas podem afetar a saúde da unidade (Seagate, 2022).
- A Seagate especifica no máximo um erro de leitura irrecuperável a cada 10^15 bits lidos para os seus HDs para NAS IronWolf Pro (Seagate, 2025).
- A Seagate afirma que operar as suas unidades SkyHawk a temperaturas mais altas reduz a vida útil dos produtos e não recomenda temperaturas extremas sustentadas (máximo nominal de 65 °C informado pela unidade) (Seagate, 2021).
- A Toshiba afirma que a operação contínua das suas unidades corporativas MG11 acima de 40 °C de temperatura da carcaça (superfície do HDA) pode degradar a confiabilidade do produto (Toshiba, 2024).
- A Seagate diz que os HDs são projetados para uma temperatura ambiente de 30 °C (86 °F) e que temperaturas acima de 50 °C (122 °F) ou abaixo de 5 °C (41 °F) reduzem a confiabilidade (Seagate, acessado em 2026).
- A JESD218 do JEDEC limita um SSD de consumo (client) a 1 erro de dados irrecuperável a cada 10^15 bits lidos (UBER), em média ao longo da resistência nominal da unidade (JEDEC, 2010).
- A JESD218 do JEDEC limita um SSD corporativo a 1 erro de dados irrecuperável a cada 10^16 bits lidos (UBER), dez vezes mais rigoroso que a classe de consumo (JEDEC, 2010).
Fontes: Carnegie Mellon University; Seagate Technology (2015-2026); Samsung Electronics (2021, 2022); Kingston Technology; SK hynix; Crucial (2021, 2026); Western Digital (2022, 2024, 2025); Toshiba Electronics Europe (2025, 2026); Toshiba Electronic Devices & Storage Corporation; Microsoft Research; JEDEC Solid State Technology Association
Quanto tempo dura um HD externo?
60,8% dos HDs externos com falha enviados a um laboratório de recuperação dos EUA tinham funcionado menos de um ano (Secure Data Recovery, 2026).

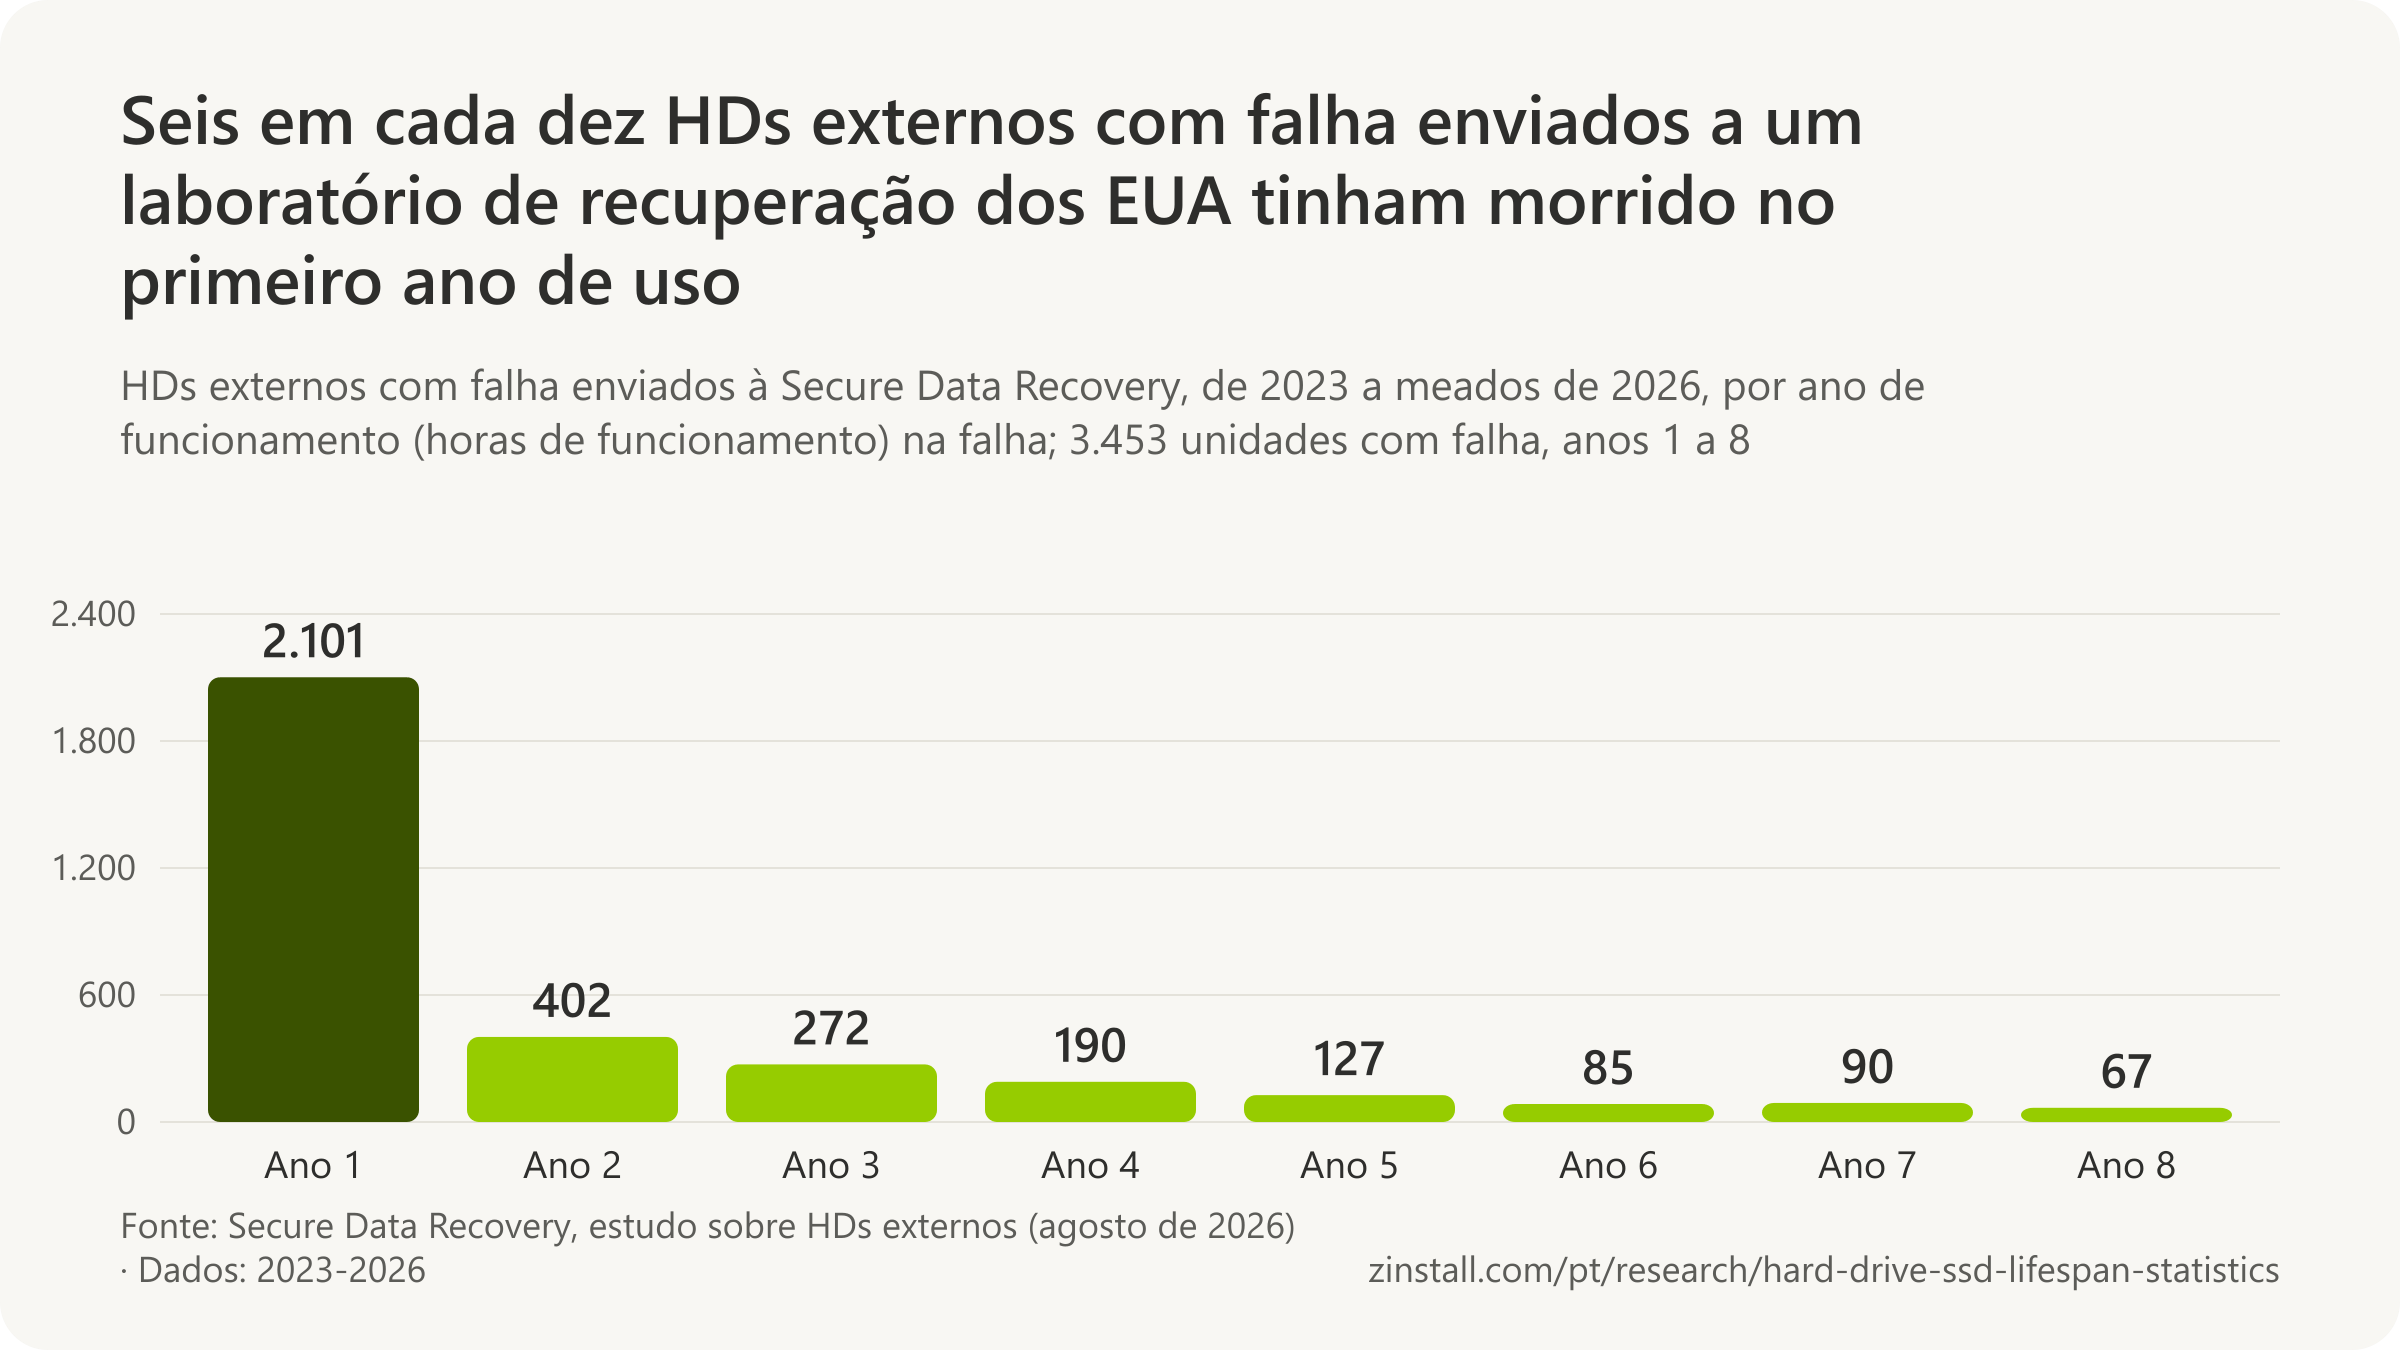
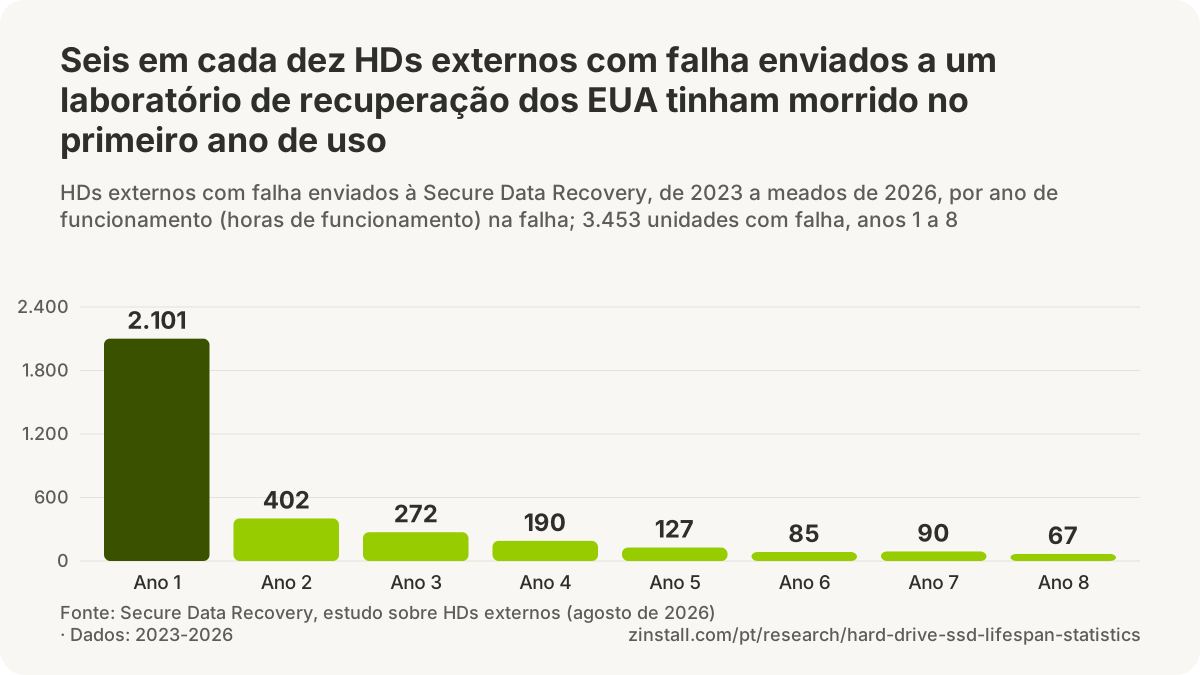
- A unidade externa com falha mediana enviada a um laboratório de recuperação dos EUA tinha 190 dias de funcionamento.
- As unidades externas foram 21,1% das unidades enviadas para recuperação de dados no Japão em 2024.
- Cerca de 6 petabytes das unidades de um estudo de data center eram unidades externas tiradas dos seus gabinetes.
- O HD portátil da Seagate tem 1 ano de garantia nas Américas e três na Ásia-Pacífico.
| Unidade ou amostra e medida | Número |
|---|---|
| WD My Passport (HD): garantia | 3 anos |
| Samsung T9 (SSD): garantia | 5 anos |
| SanDisk Extreme Portable (SSD): garantia | 5 anos |
| LaCie Rugged: serviço de recuperação de dados incluído | 3 anos de recuperação de dados |
| Samsung T7: classificação de queda (danos por queda não cobertos) | 2 m |
| LaCie Rugged: classificação de queda, desligado | 1,2 m (4 pés) |
| WD My Passport: temperatura de operação | 5 °C a 35 °C |
| Unidades externas com falha que tinham funcionado menos de seis meses | 49,6% |
| Unidades externas com falha sem aviso de setor defeituoso | 27,2% |
| Japan Data Technology: unidades externas entre os pedidos de recuperação, 2009 | 32,3% |
Fontes: Secure Data Recovery Services; Data Recovery Association of Japan; Backblaze; Seagate Technology; Western Digital; Samsung Electronics (2026, 2024); Sandisk Corporation; LaCie; Japan Data Technology
Guias relacionados: Backup em um HD externo · Transferir com um HD externo ou pen drive
Mais estatísticas (13)
Nenhum fabricante ou operador de parque publica taxas de falha de unidades externas: os únicos dados medidos vêm dos laboratórios de recuperação para onde elas são enviadas, e esses laboratórios veem falhas, não sobreviventes. Nessas amostras, as unidades externas tendem a falhar jovens, com quedas, picos de energia e calor entre as principais causas. As garantias dos fabricantes vão de um a cinco anos e variam por região e por modelo.
Unidades externas com falha nos laboratórios de recuperação
- 190 dias (4.559 horas de funcionamento) foi o tempo mediano de funcionamento antes da falha entre 3.453 HDs externos com falha enviados à Secure Data Recovery de janeiro de 2023 a junho de 2026 (Secure Data Recovery, 2026).
- 665 dias (15.961 horas de funcionamento, cerca de 1 ano e 10 meses) foi o tempo médio de funcionamento antes da falha entre 3.453 HDs externos com falha enviados à Secure Data Recovery de 2023 a meados de 2026 (Secure Data Recovery, 2026).
- 60,8% dos HDs externos com falha enviados à Secure Data Recovery de 2023 a meados de 2026 tinham funcionado menos de um ano quando falharam (2.101 de 3.453 unidades) (Secure Data Recovery, 2026).
- 49,6% dos HDs externos com falha enviados à Secure Data Recovery de 2023 a meados de 2026 tinham funcionado menos de seis meses, e 2,2% menos de 24 horas (Secure Data Recovery, 2026).
- 27,2% dos HDs externos com falha enviados à Secure Data Recovery de 2023 a meados de 2026 não tinham nenhum setor defeituoso pendente quando morreram, então o SMART não deu nenhum aviso (Secure Data Recovery, 2026).
- Quedas acidentais, picos de energia, calor extremo e defeitos de fabricação foram as principais causas de falha entre os HDs externos enviados à Secure Data Recovery de 2023 a meados de 2026 (Secure Data Recovery, 2026).
- Nenhum parque de HDs externos grande o bastante para medir taxas de falha anualizadas é acompanhado, observou a Secure Data Recovery em 2026, então os seus números sobre unidades externas vêm das unidades com falha enviadas aos seus laboratórios (Secure Data Recovery, 2026).

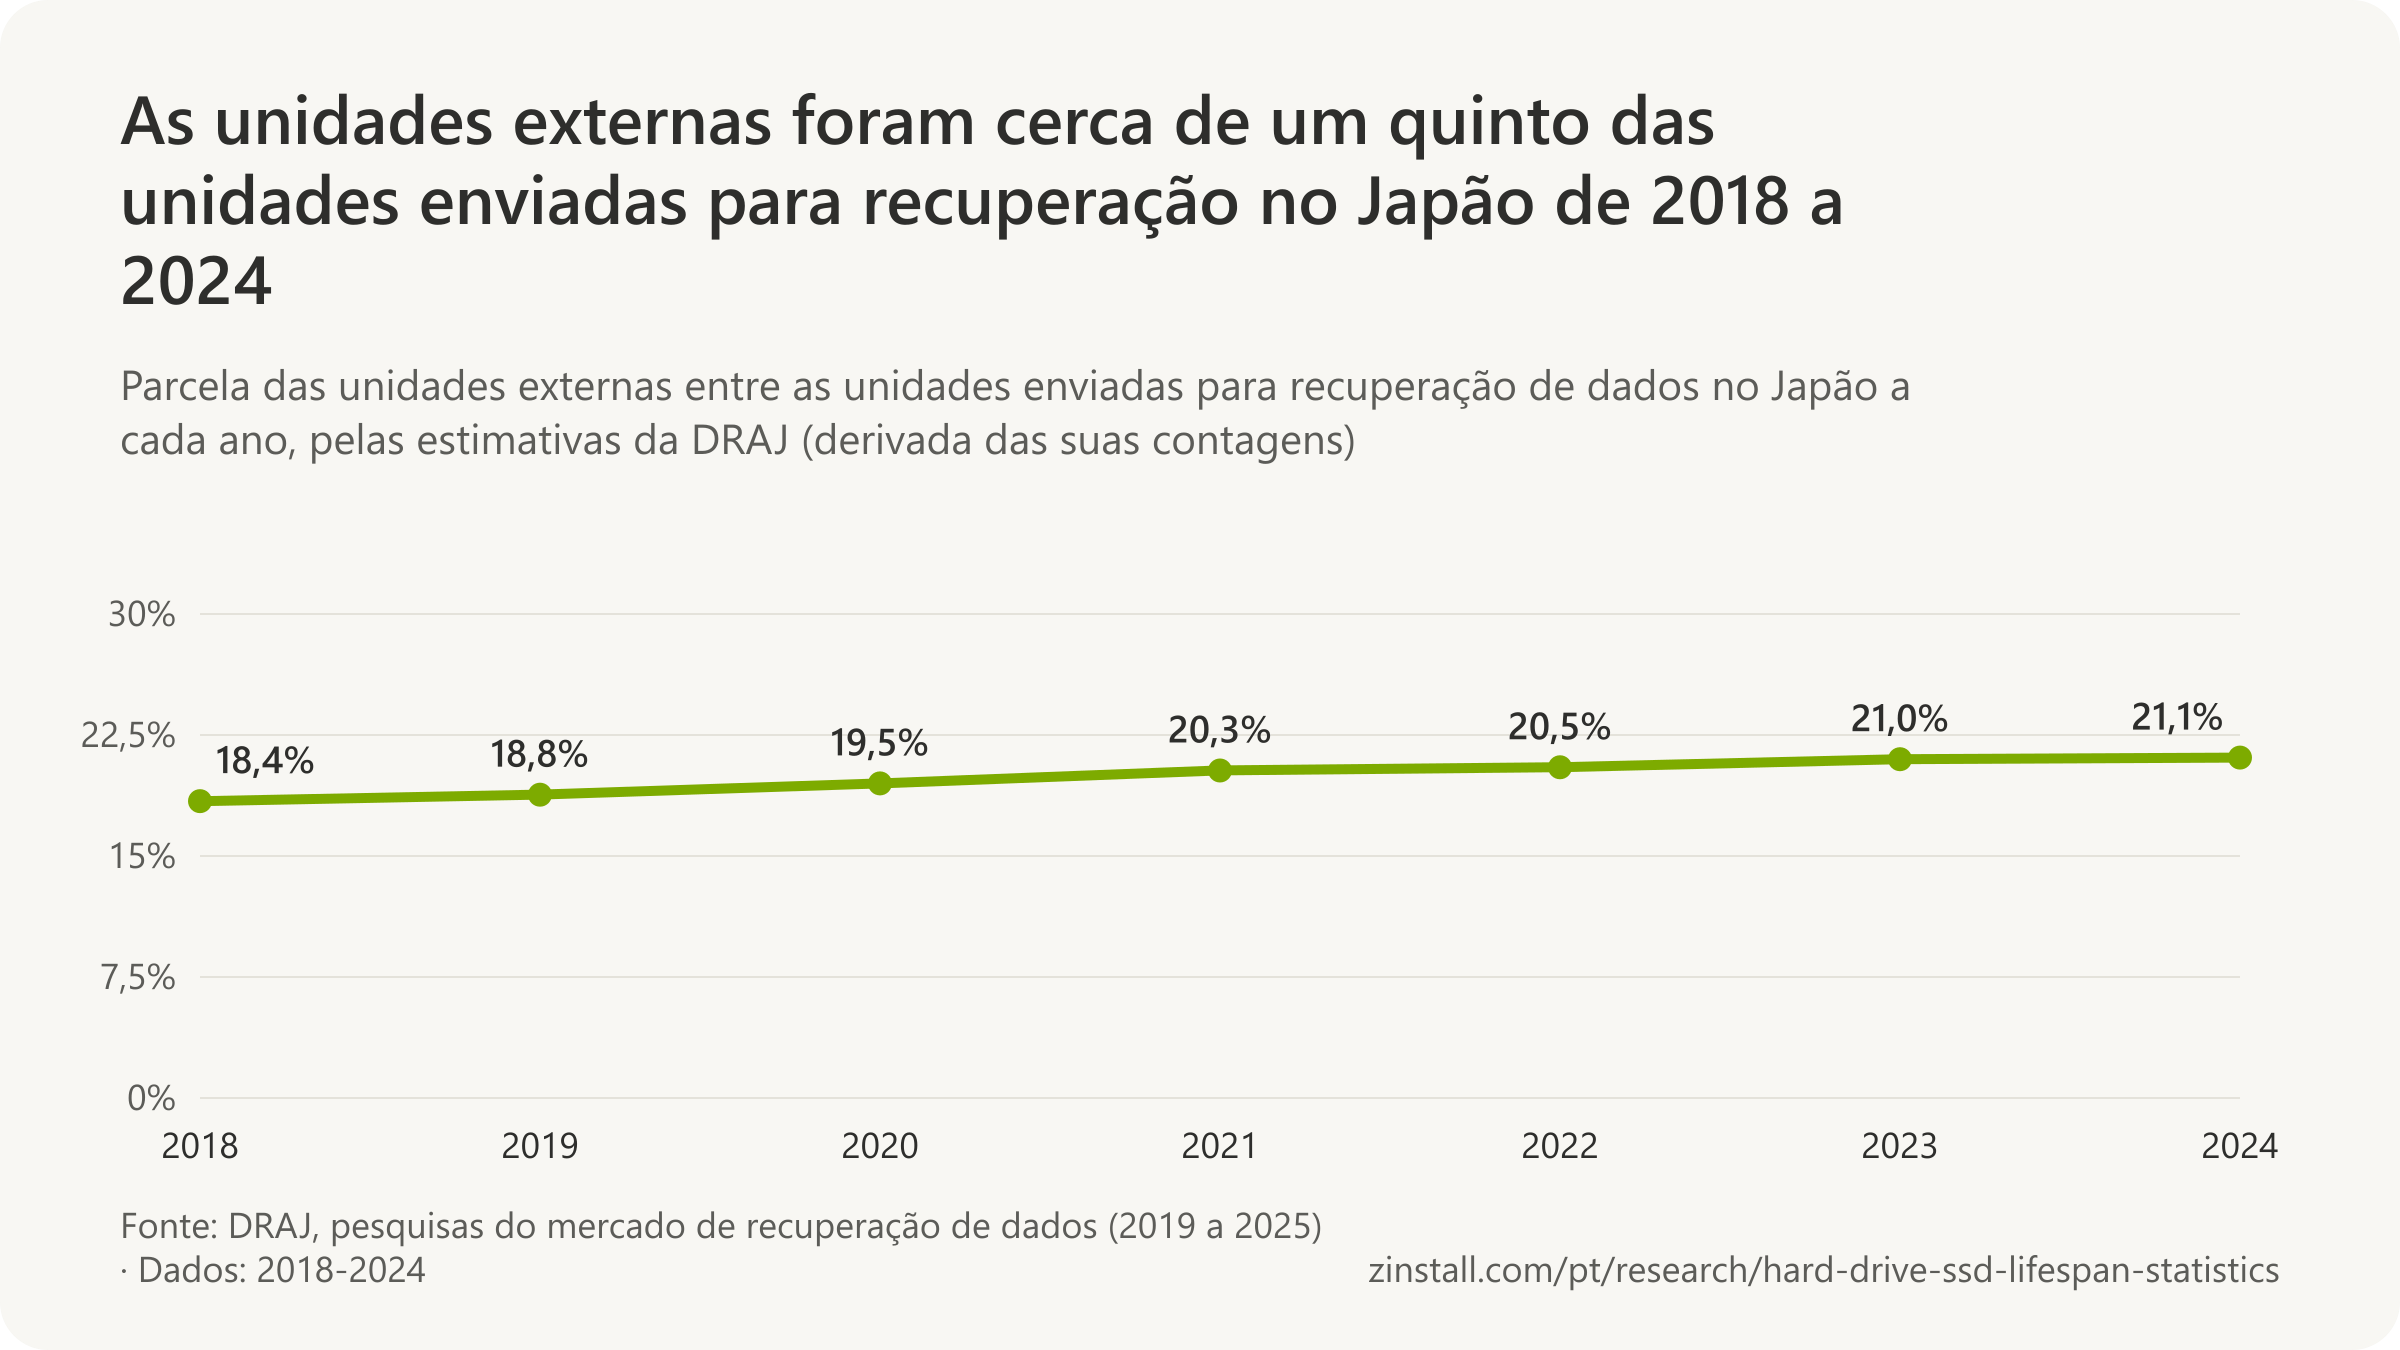
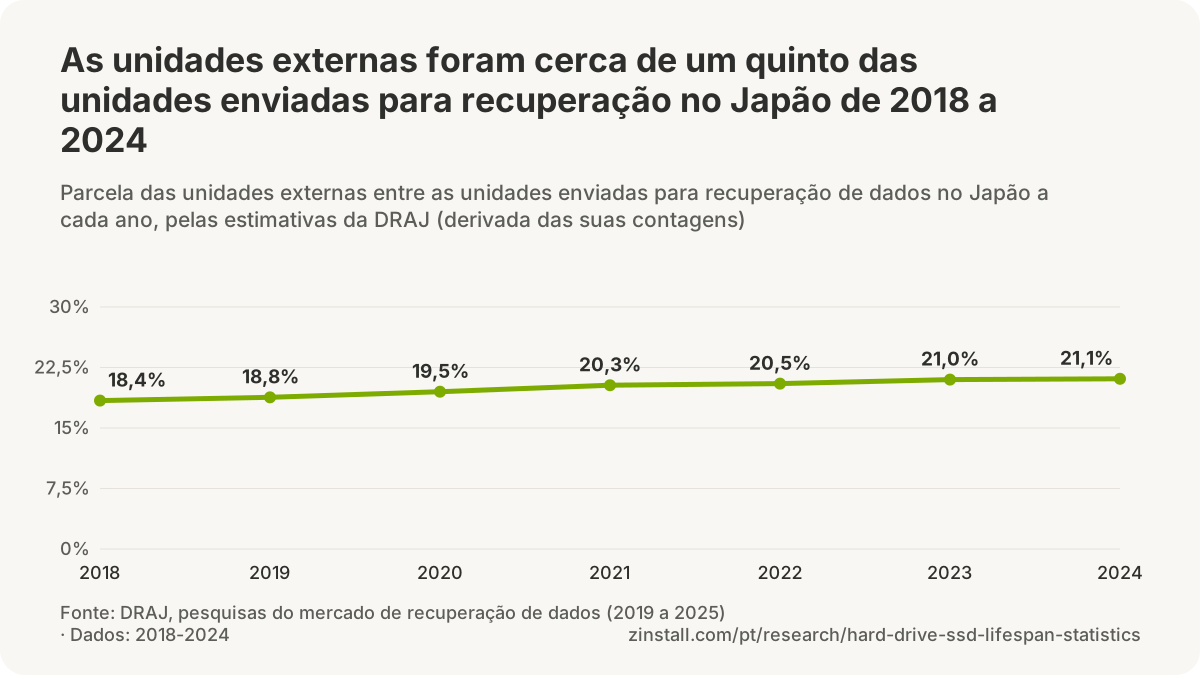
- 32,3% dos dispositivos levados à Japan Data Technology para recuperação em 2009 eram HDs externos (USB ou NAS), contra 21,3% de desktops, 19,7% de notebooks e 26,2% de unidades avulsas, entre mais de 40.000 unidades (Japan Data Technology, 2010).
Garantias e classificações de robustez

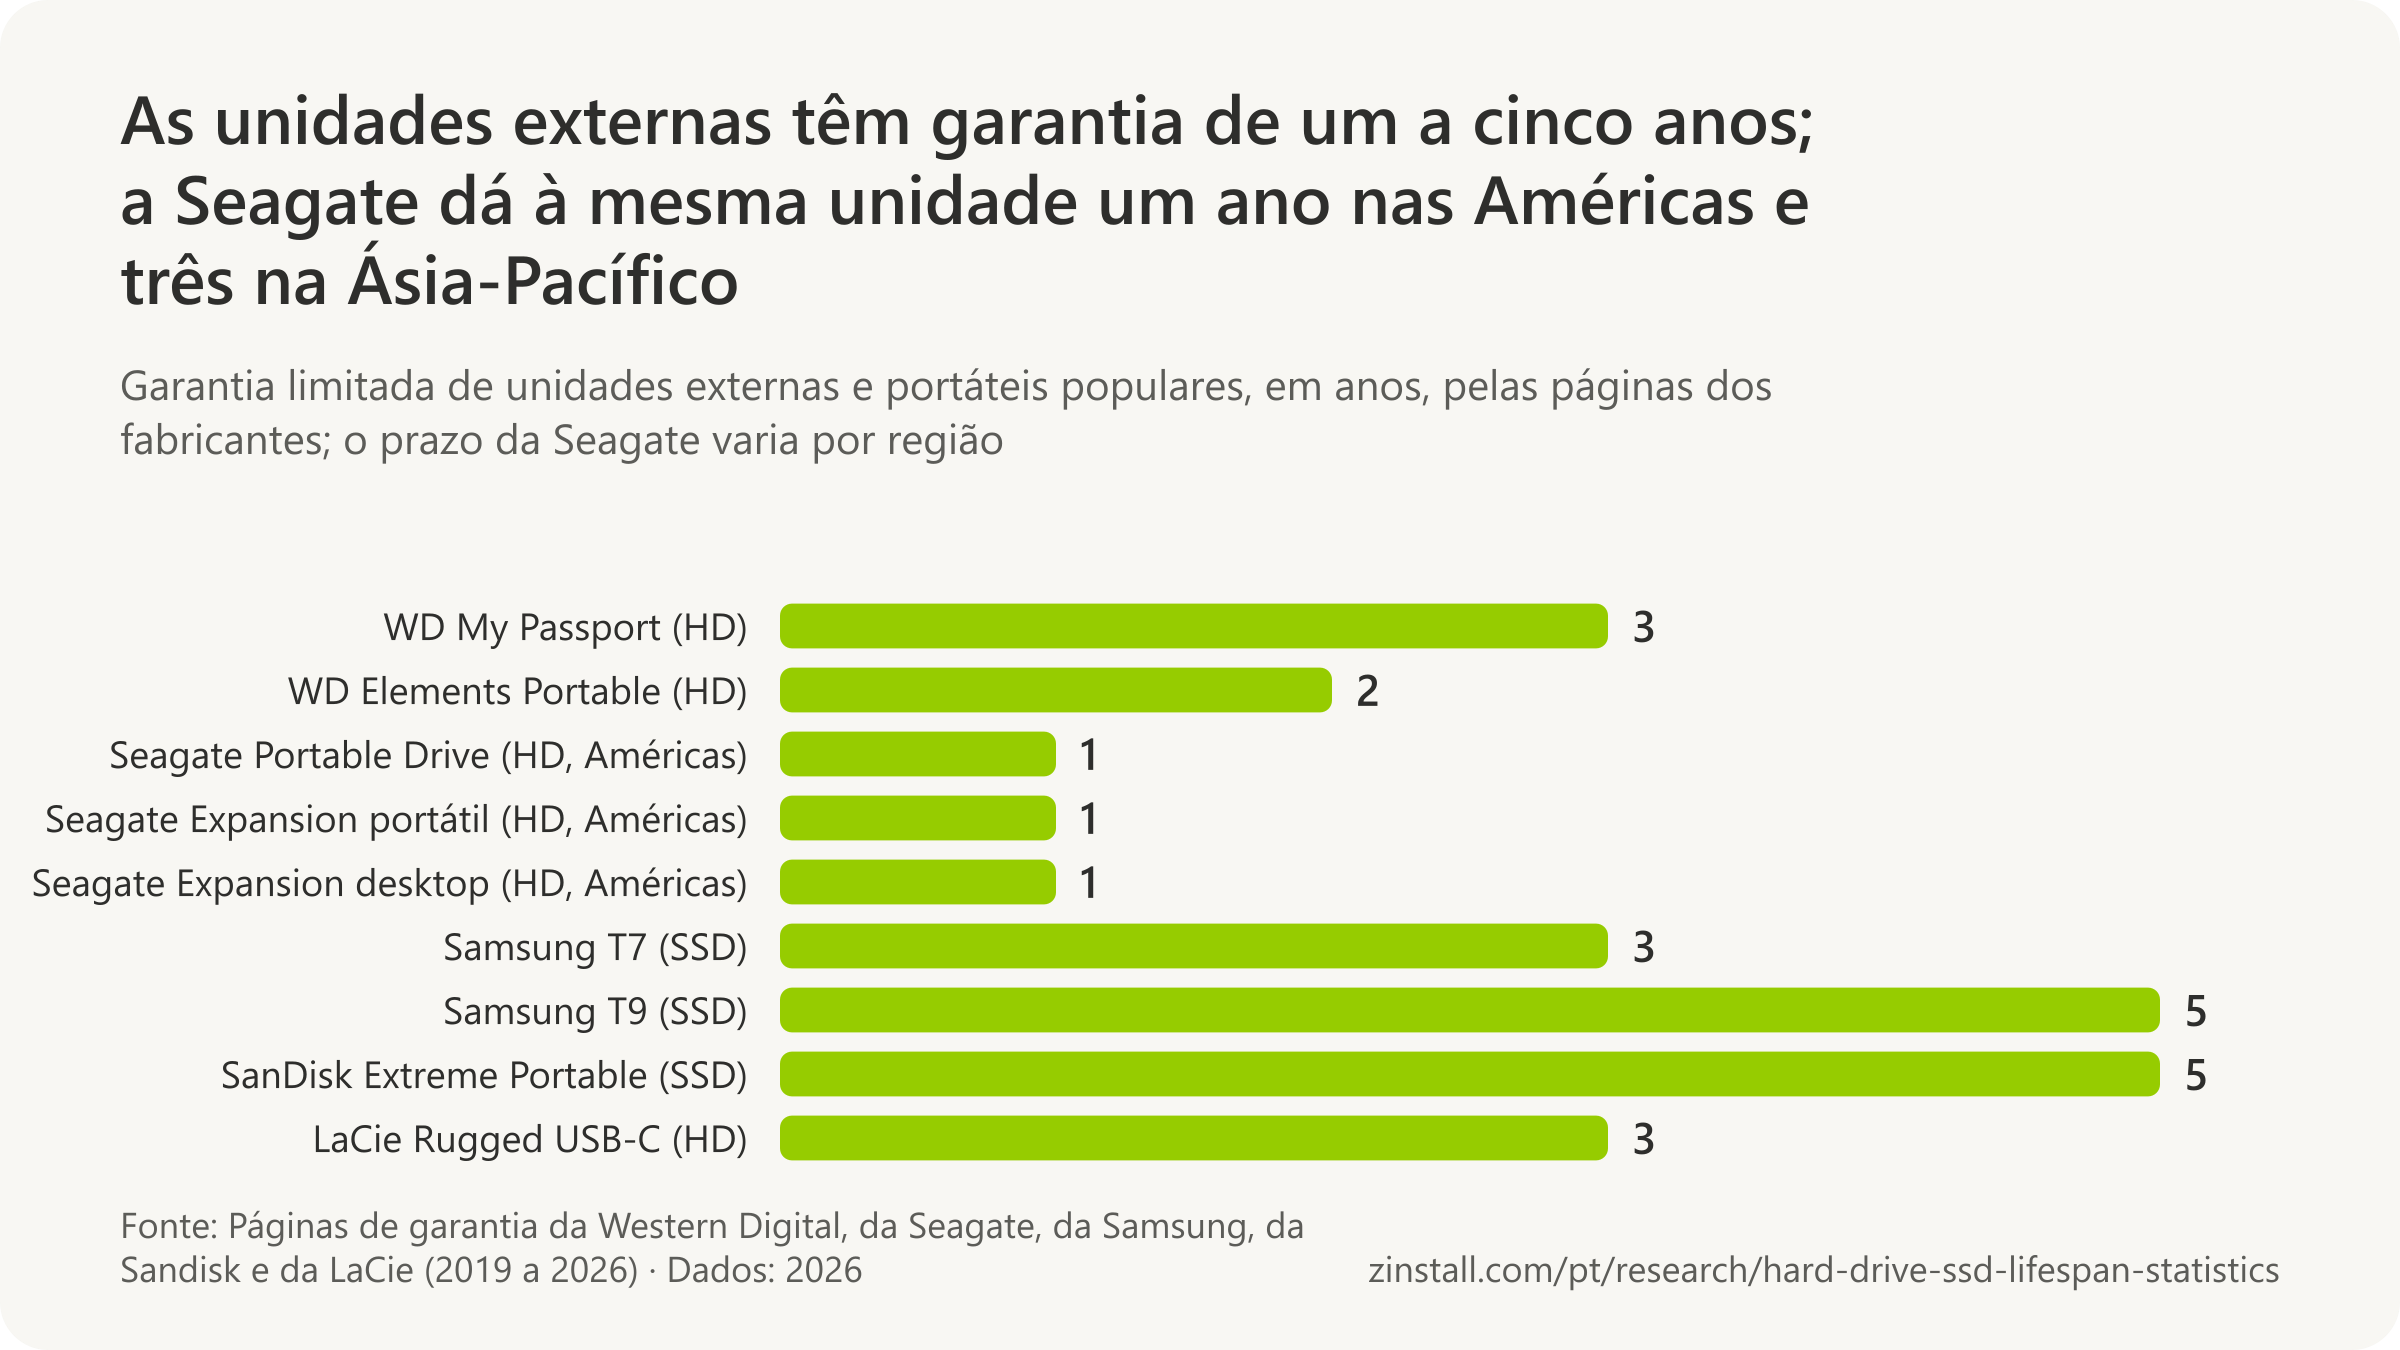
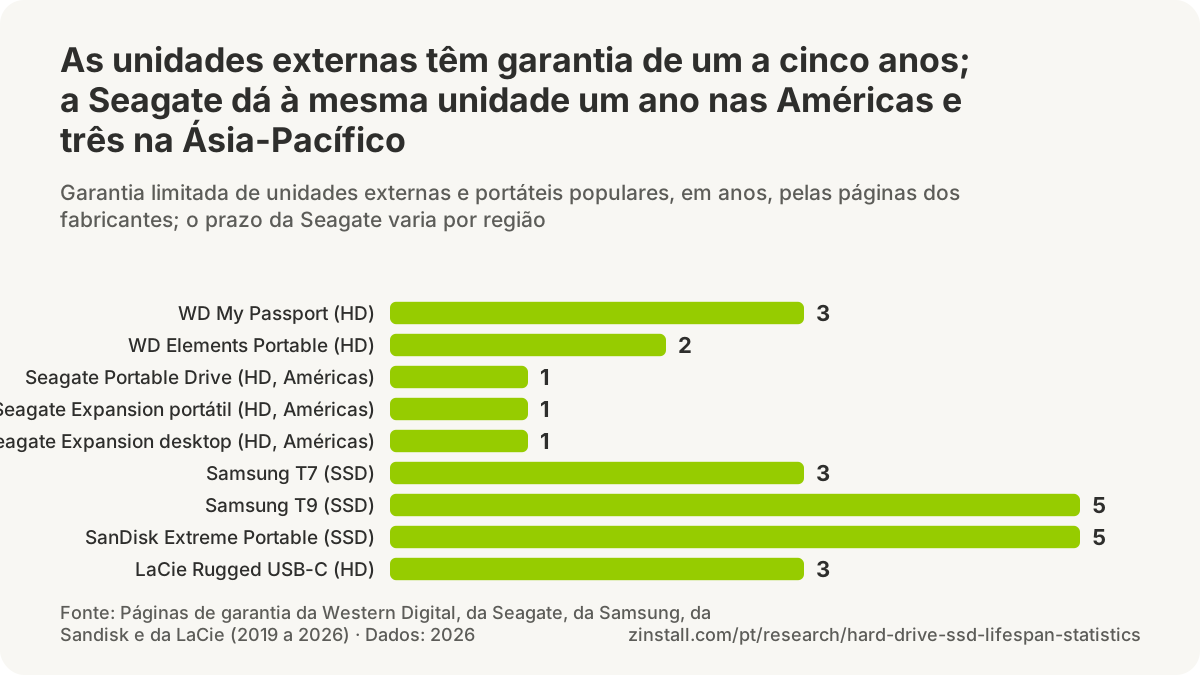
- A Western Digital especifica uma temperatura de operação de 5 °C a 35 °C para o HD portátil WD My Passport (Western Digital, 2026).
- A Samsung classifica o Portable SSD T7 como resistente a quedas de até 2 metros no seu próprio teste controlado, mas diz que os danos causados por uma queda não são cobertos pela garantia (Samsung, 2024).
- Todo HD LaCie Rugged USB-C inclui três anos do serviço de recuperação de dados Rescue da Seagate, onde disponível, além da sua garantia limitada (LaCie, 2023).
- A LaCie classifica o HD portátil Rugged USB-C para sobreviver a uma queda de 4 pés (1,2 metro) quando não está funcionando, e à passagem de um carro de 1 tonelada por cima dele (LaCie, 2023).
Unidades externas num data center
- Cerca de 6 petabytes dos HDs do estudo de 2013 da Backblaze sobre a vida das unidades eram originalmente HDs externos USB tirados dos seus gabinetes (Backblaze, 2013).
Fontes: Secure Data Recovery Services; Japan Data Technology; Western Digital (2026); Samsung Electronics (2024, 2026); LaCie; Backblaze; Data Recovery Association of Japan; Seagate Technology (2019, 2020, 2025); Sandisk Corporation
Por quanto tempo um SSD ou HD guarda os dados sem energia?
Um SSD de consumo desgastado precisa guardar os dados por 1 ano sem energia a 30 °C, pela norma (JEDEC, 2010).

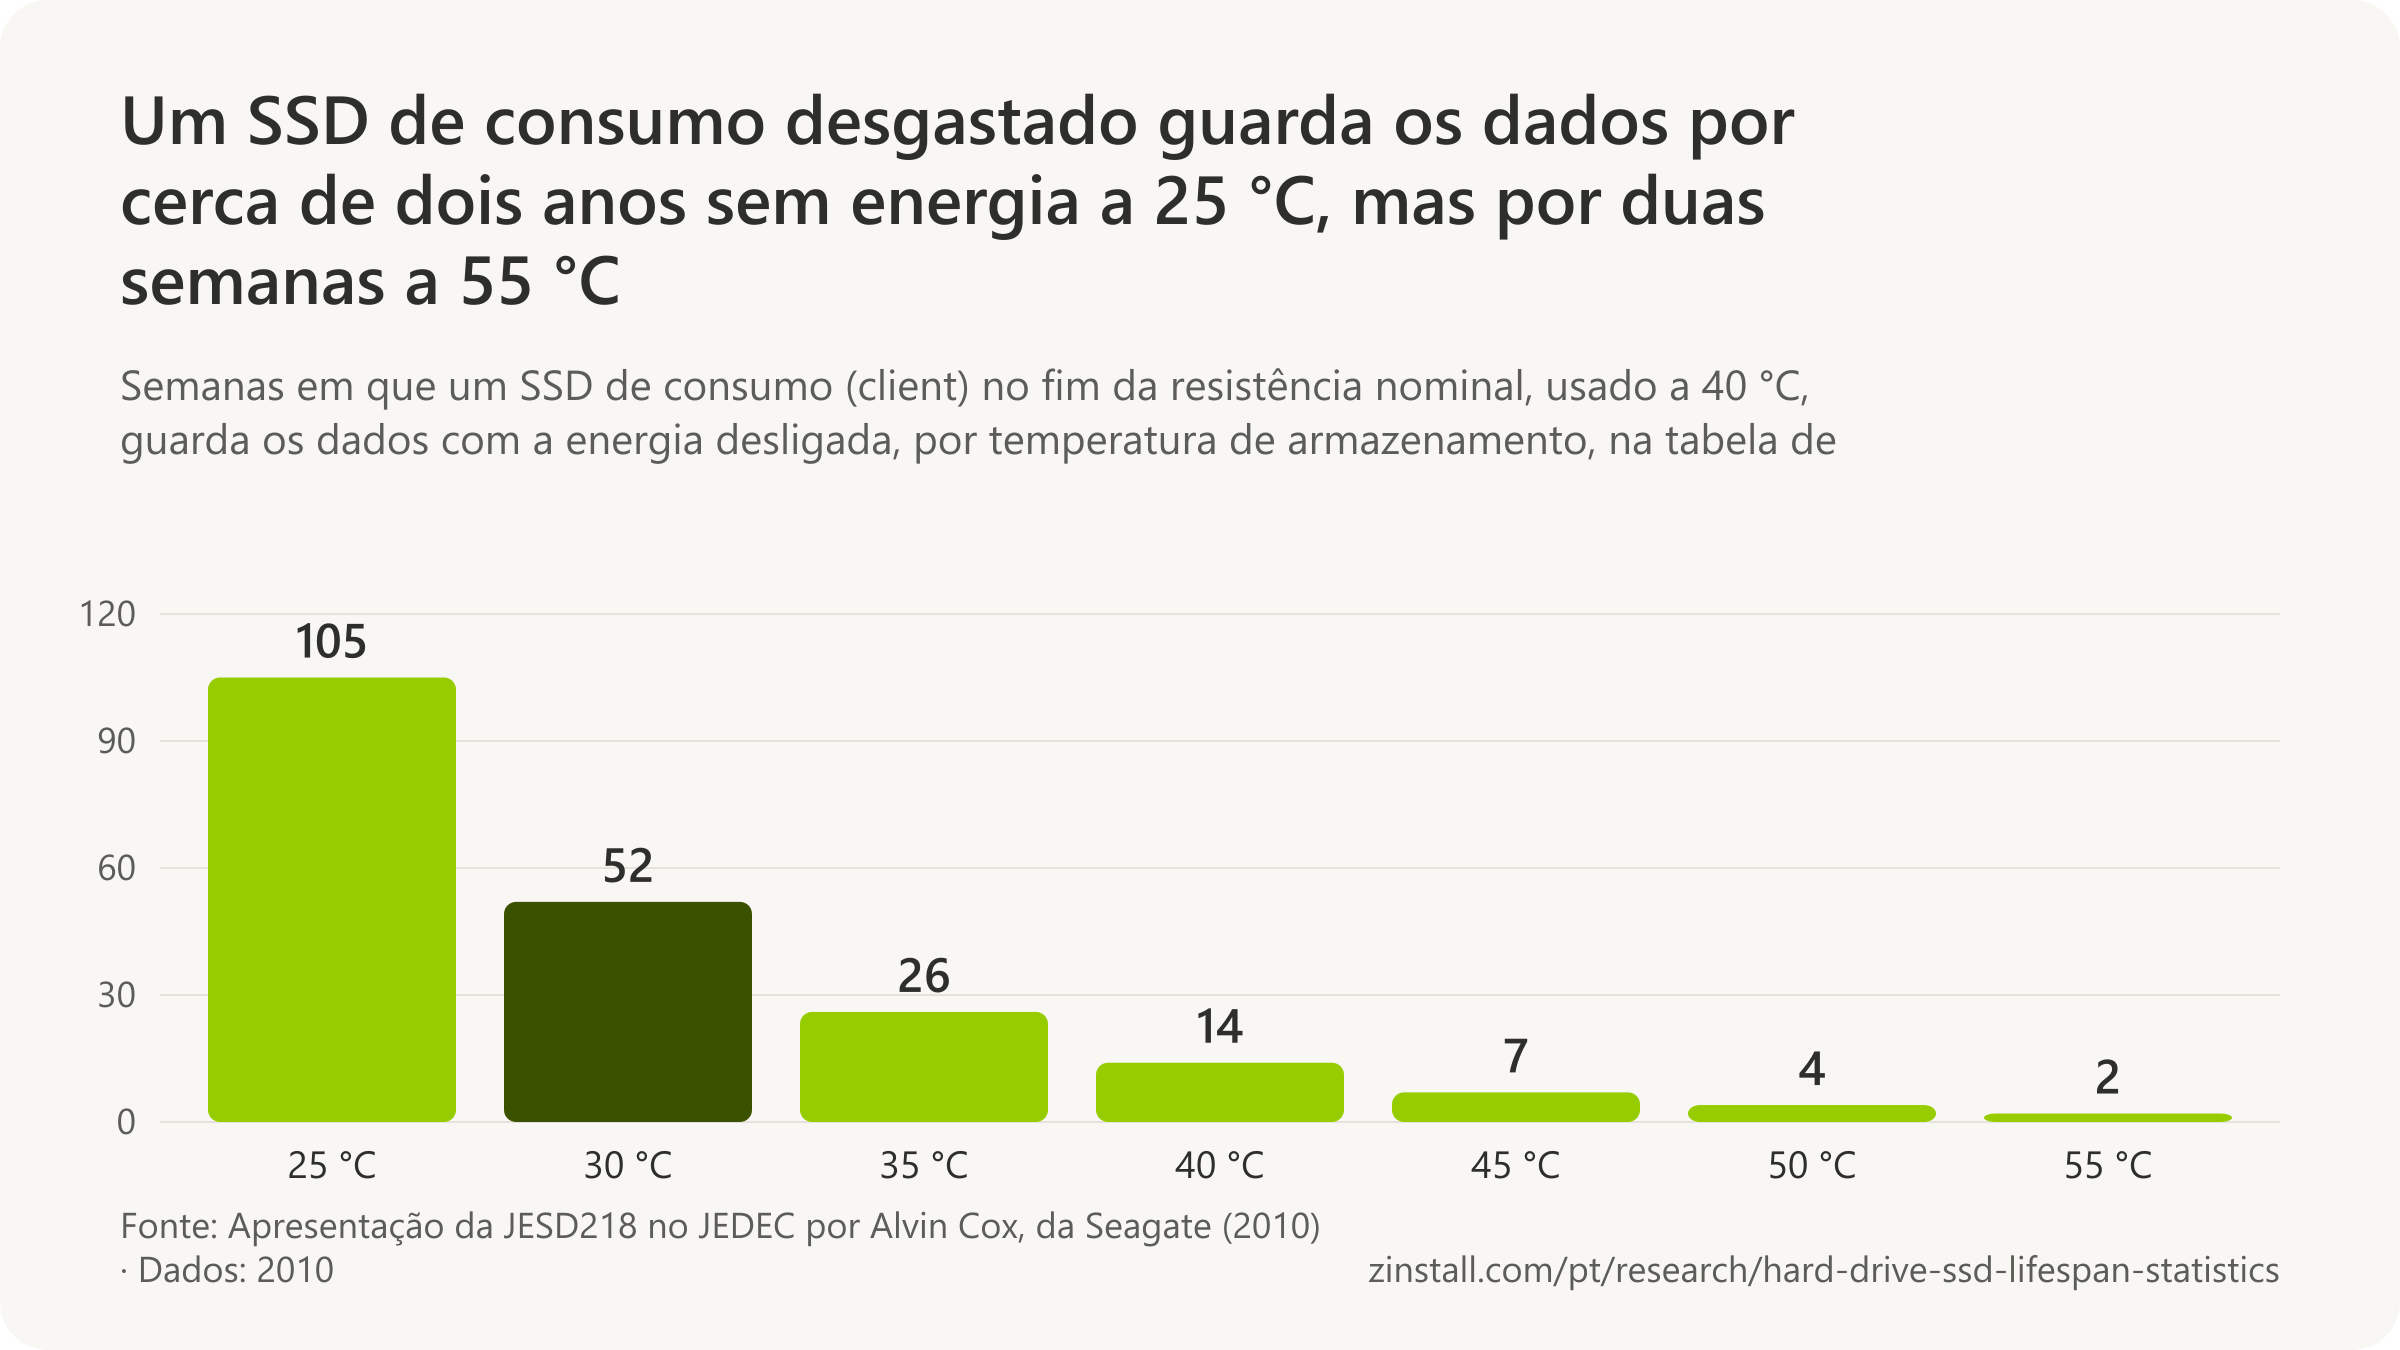
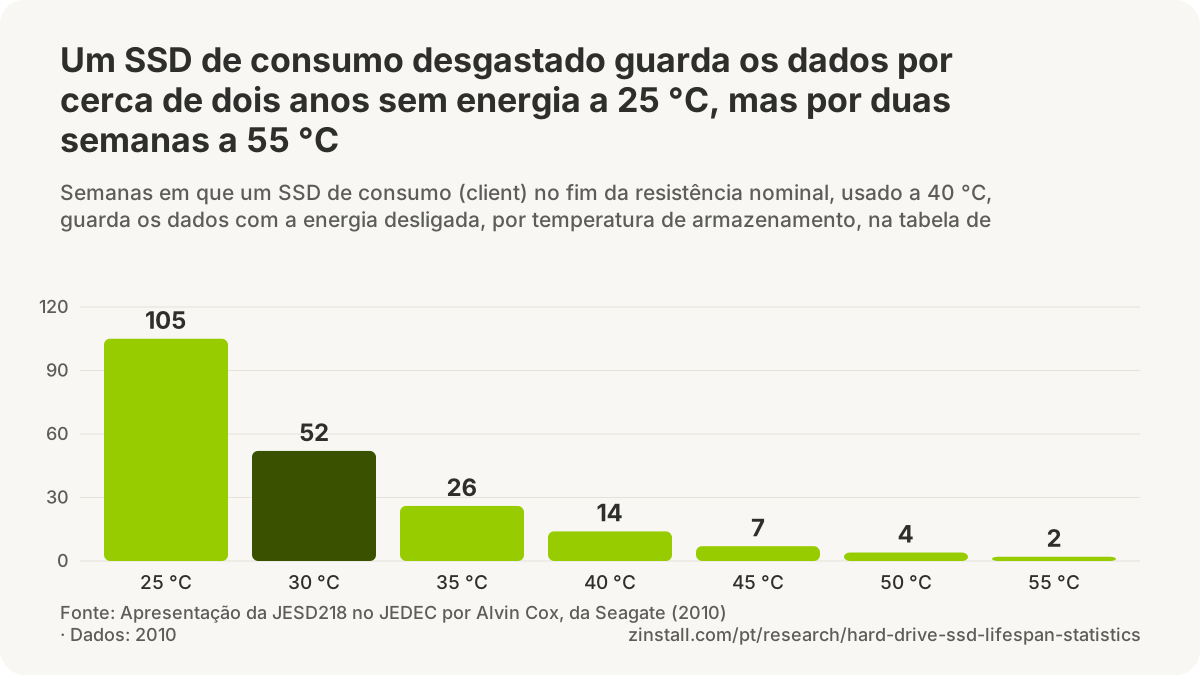
- Um SSD corporativo no fim da sua resistência nominal precisa guardar os dados por 3 meses sem energia a 40 °C.
- Um SSD de consumo desgastado guardado a 55 °C mantém os seus dados por apenas cerca de 2 semanas, na tabela de 2010 do JEDEC.
- A Dell recomenda ligar os SSDs corporativos guardados a cada 2,5 meses, por pelo menos 3 semanas.
- Depois de um ano sem energia, um SSD desgastado e um novo, no teste de um amador, leram de volta os seus arquivos sem ficar mais lentos.
| Fonte e medida | Número |
|---|---|
| SSD de consumo desgastado guardado a 25 °C (tabela do JEDEC) | 105 semanas |
| SSD de consumo desgastado guardado a 40 °C (tabela do JEDEC) | 14 semanas |
| JEDEC: o uso que a classificação de um SSD de consumo supõe | 8 horas por dia a 40 °C |
| JEDEC: o uso que a classificação de um SSD corporativo supõe | 24 horas por dia a 55 °C |
| c't: flash 3D TLC, ciclos nominais e retenção | 1.500 a 3.000 ciclos |
| Teste amador, segundo ano, como o Tom's Hardware noticiou | 4 arquivos corrompidos |
Fontes: JEDEC Solid State Technology Association; Dell Technologies; HTWingNut; heise online / c't magazin; Tom's Hardware
Guias relacionados: Faça backup do PC inteiro · Backup em um HD externo
Mais estatísticas (8)
Para SSDs, a norma é a JESD218 do JEDEC: um SSD de consumo que esgotou a resistência nominal precisa guardar os dados sem energia por um ano em temperatura ambiente, e um SSD corporativo por três meses. Um SSD novo guarda os dados por muito mais tempo, e a temperatura de armazenamento muda muito esse tempo. O aviso muito compartilhado de que um SSD sem energia perde dados em uma semana veio dos números do JEDEC para unidades desgastadas guardadas no calor. Os HDs guardam os dados magneticamente e não têm uma norma desse tipo; os arquivistas recomendam fazer cópias novas a cada poucos anos.
Os requisitos de retenção do JEDEC

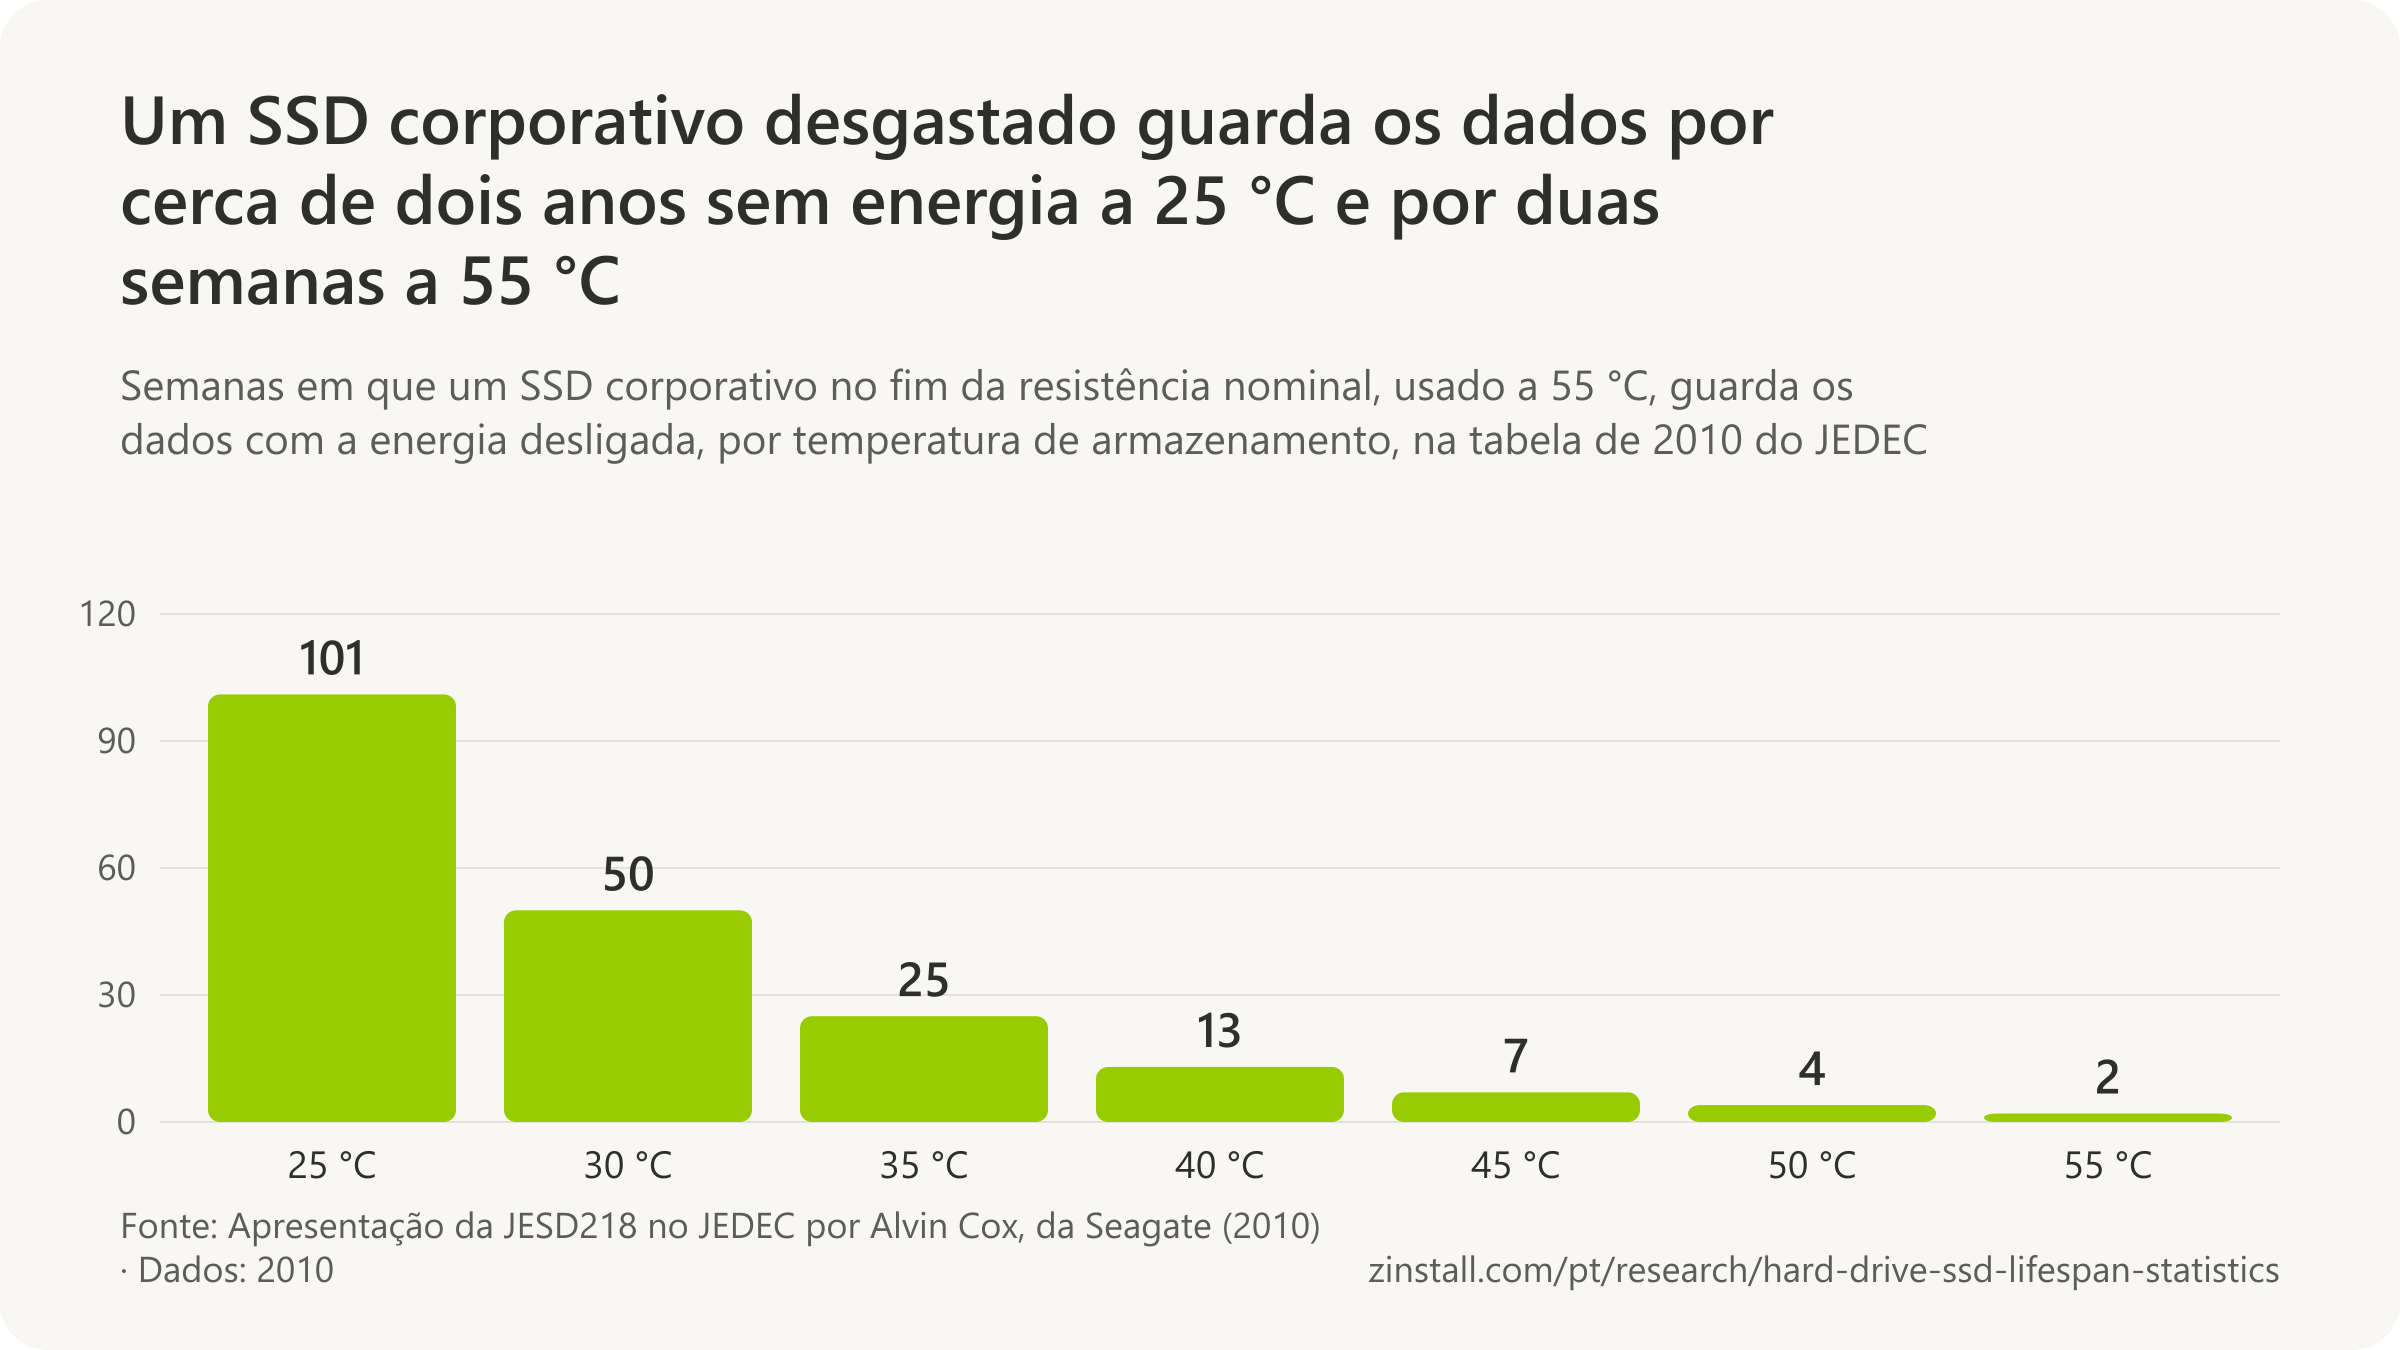
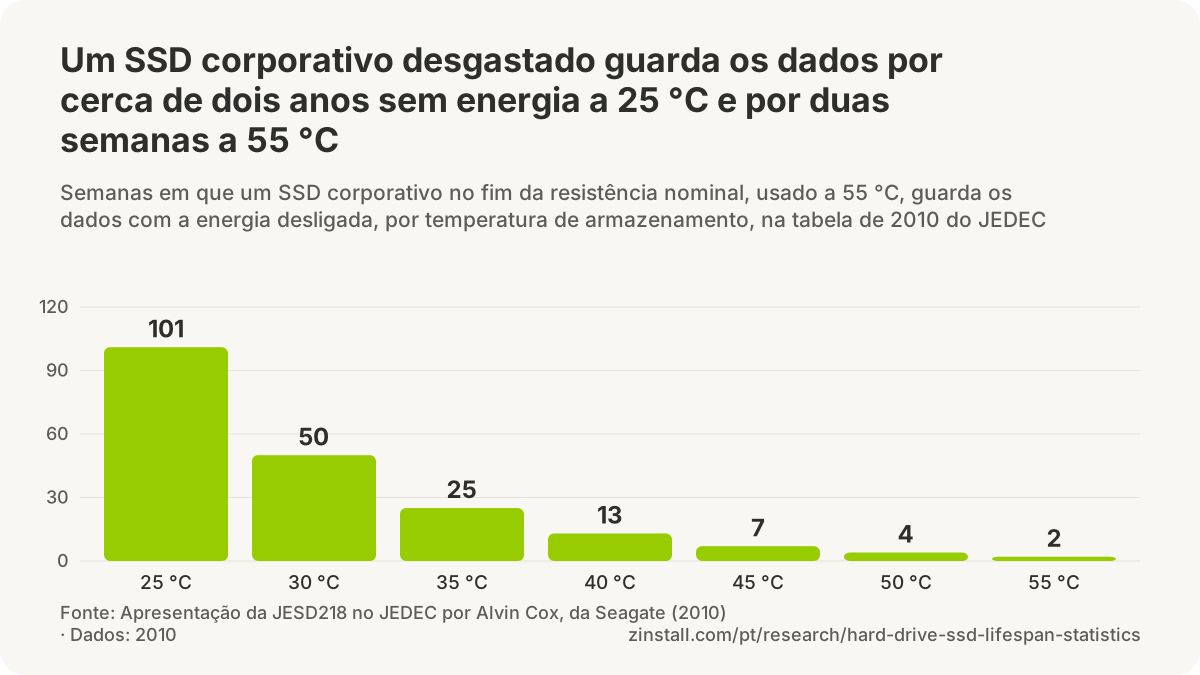
- A JESD218 do JEDEC exige que um SSD da classe client (PCs de consumo) que esgotou a sua resistência nominal guarde os dados por 1 ano com a energia desligada, armazenado a 30 °C (JEDEC, 2010).
- A JESD218 do JEDEC exige que um SSD da classe enterprise (data center) que esgotou a sua resistência nominal guarde os dados por 3 meses com a energia desligada, armazenado a 40 °C (JEDEC, 2010).
O que dizem os fabricantes
- A Crucial diz que um SSD novo guarda os dados sem energia por vários anos, um período que encurta à medida que a flash se desgasta com as gravações (Crucial, 2026).
- A Dell recomenda ligar os SSDs corporativos e as unidades NVMe que guardam dados uma vez a cada 2,5 meses, por pelo menos 3 semanas, para que o firmware possa renovar a carga armazenada (Dell, 2026).
- A Western Digital diz que, depois que um SSD esgota a sua resistência nominal, não há mais nenhuma expectativa de que ele guarde os dados por um tempo determinado, e que não se deve confiar a ele dados importantes (Western Digital, 2023).
Testes de SSDs sem energia
- A flash 3D TLC costuma ser especificada para 1.500 a 3.000 ciclos de programação/apagamento, depois dos quais ainda precisa guardar os dados por pelo menos um ano sem energia a até 40 °C, noticiou a c't (c't, 2021).
- Depois de um ano sem energia, um SSD SATA de 128 GB desgastado e outro novo, no teste amador do youtuber HTWingNut, leram de volta cerca de 100 GB de arquivos a 495 e 456 MB/s, sem degradação de desempenho na avaliação do autor do teste (HTWingNut, 2023).
Números que circulam
- Depois de dois anos sem energia, o SSD desgastado do teste amador de HTWingNut tinha 4 arquivos corrompidos e lia 4 vezes mais devagar, enquanto todos os dados da unidade nova foram verificados, como o Tom's Hardware noticiou o vídeo (Tom's Hardware, 2025).
Fontes: JEDEC Solid State Technology Association; Crucial; Dell Technologies; Western Digital; heise online / c't magazin; HTWingNut; Tom's Hardware
Quais bugs de firmware e defeitos já mataram unidades?
Alguns SSDs SAS falhariam exatamente em 32.768 horas de operação se o firmware não fosse atualizado (HPE, 2019).

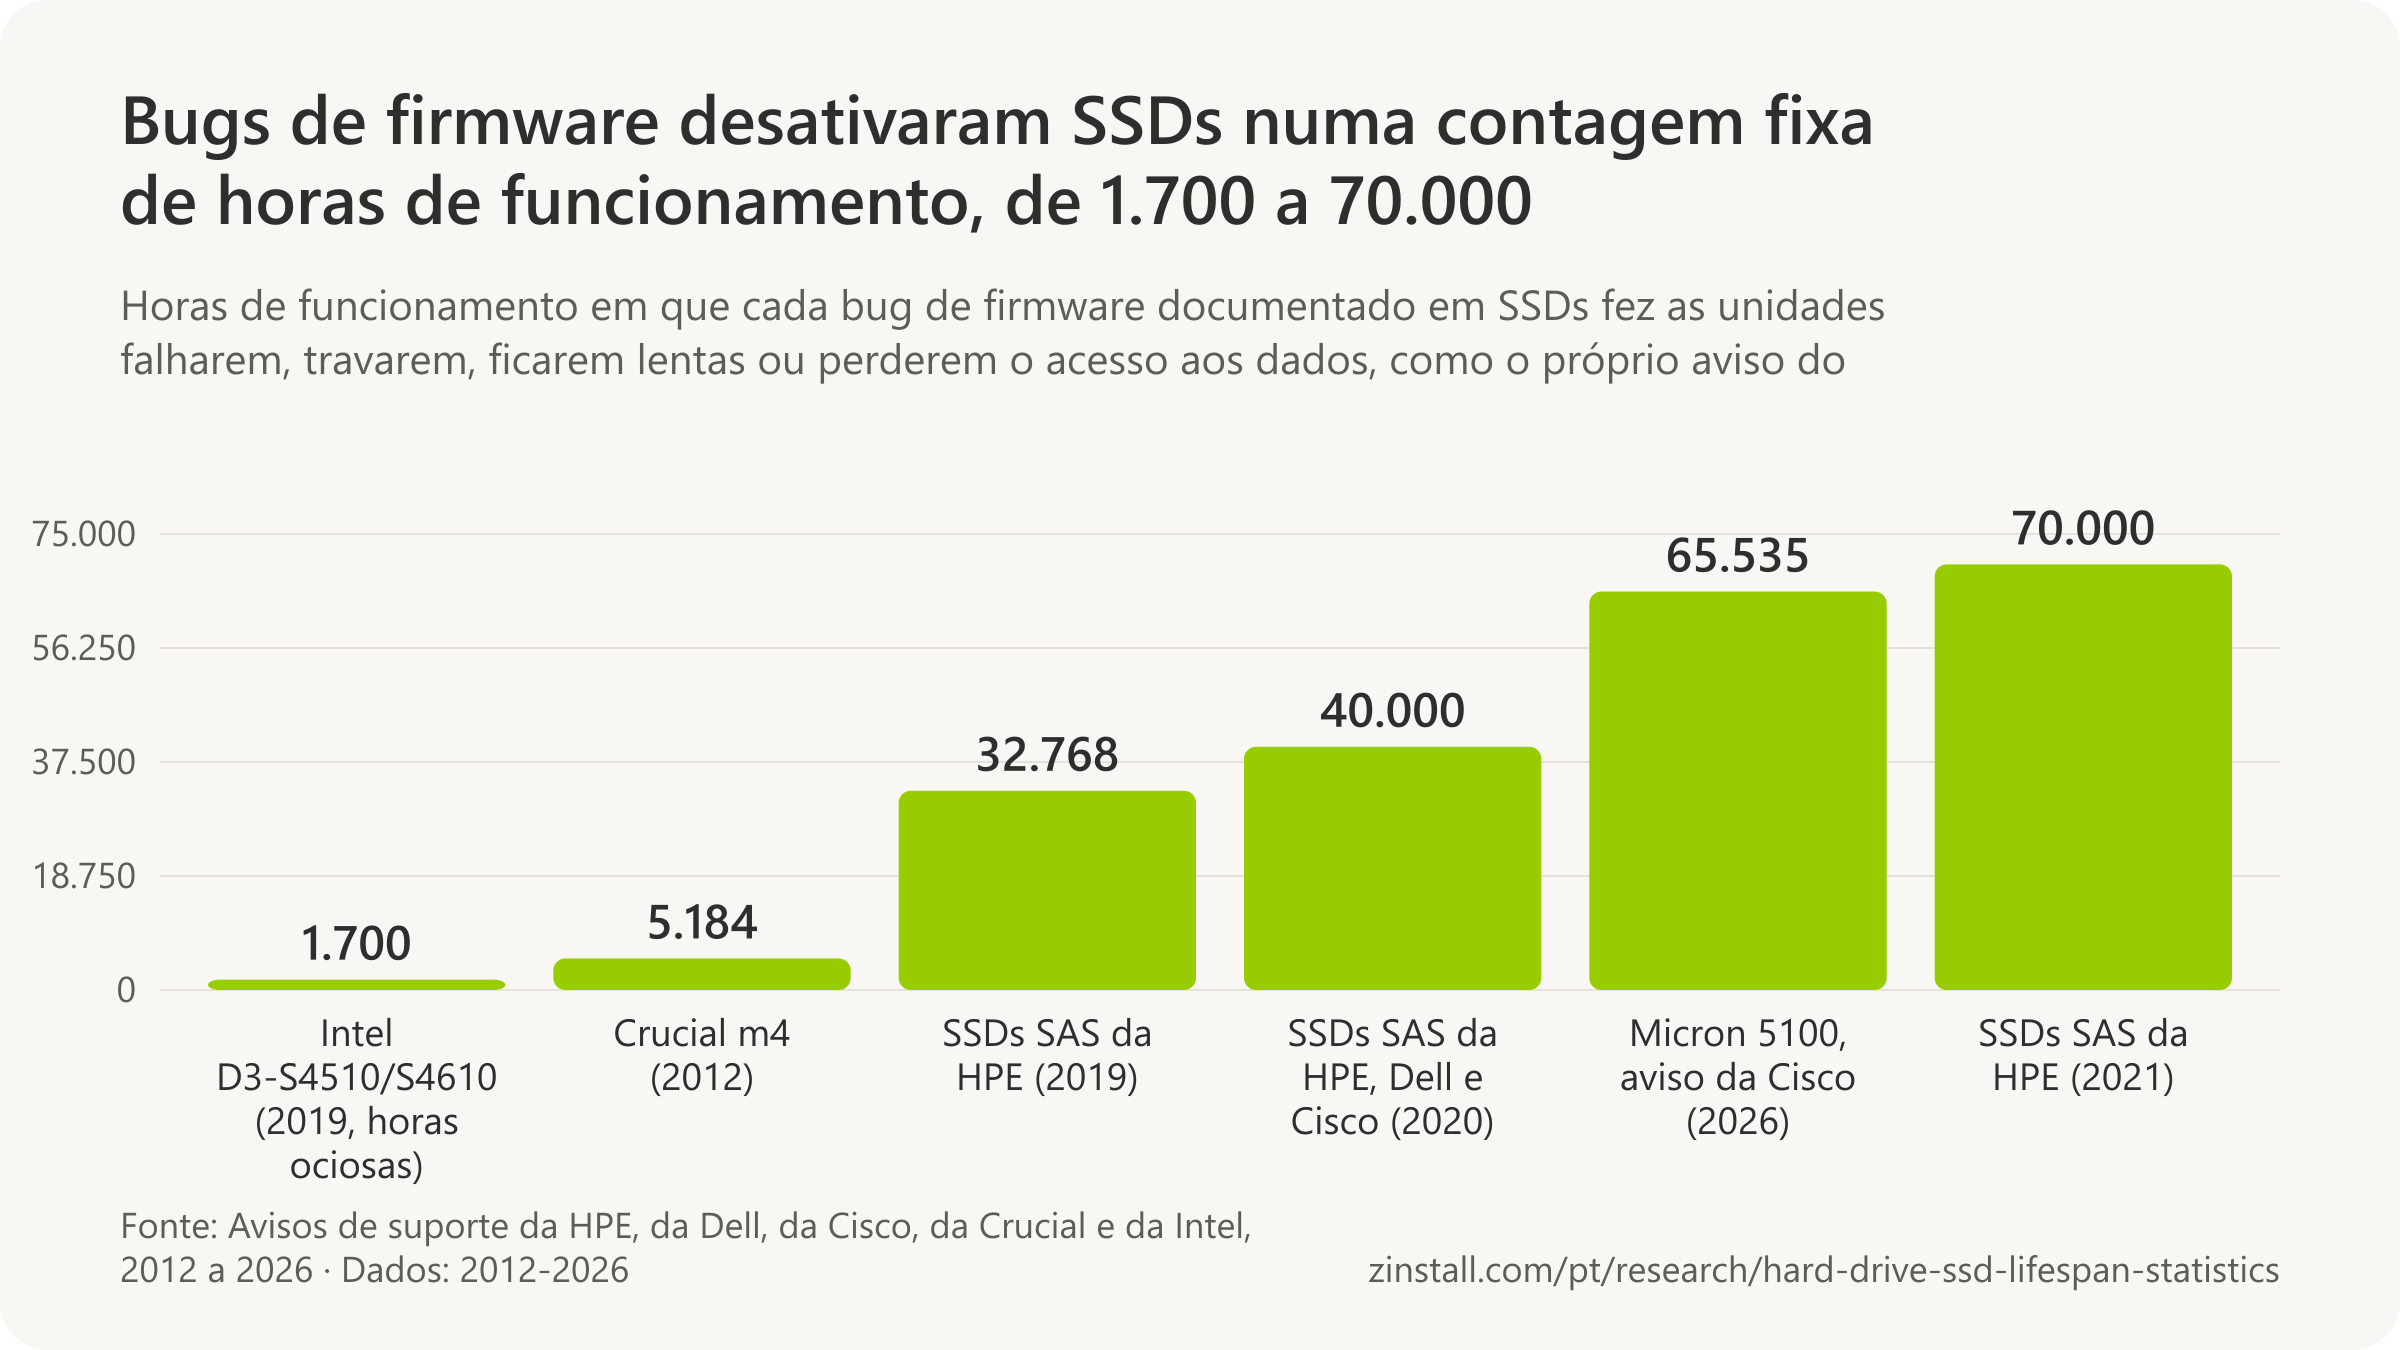
- 145.000 SSDs portáteis SanDisk e WD foram potencialmente afetados por um defeito de firmware de 2022-2023, pela estimativa do fabricante.
- A Western Digital pagou no máximo US$ 2,7 milhões para encerrar a ação coletiva sobre os HDs para NAS WD Red com gravação sobreposta.
- 46.898 pedidos foram apresentados no acordo do WD Red.
- O manual do produto da Seagate dava ao seu HD ST3000DM001 uma taxa de falha anualizada de 0,34%.
- Os SSDs Crucial m4 paravam de responder depois de 5.184 horas de funcionamento, cerca de 216 dias.
| Evento e medida | Número |
|---|---|
| SSDs SAS da HPE: o segundo bug, 2020 | 40.000 horas |
| SSDs SAS da HPE: o terceiro bug, 2021 | 70.000 horas |
| SSDs SAS corporativos da Dell | 40.000 horas |
| SSDs Micron 5100, aviso da Cisco, 2026 | 65.535 horas |
| SSDs Intel D3-S4510 e D3-S4610, 2019 | 1.700 horas |
| Seagate ST3000DM001: taxa do primeiro ano nos próprios testes da Seagate, segundo o perito dos autores da ação | 2,621% |
| Acordo do IBM Deskstar 75GXP, por unidade com falha, 2005 | US$ 100 |
| Acordo dos Fujitsu MPG, por unidade com dados perdidos, 2003 | Até US$ 1.200 |
| Testes da Phison sobre os relatos ligados à atualização de 2025 do Windows 11 | mais de 4.500 horas |
| Pen drives Lexar com recall por risco de queimadura, 2006 | Cerca de 66.000 |
Fontes: Hewlett Packard Enterprise (2021, 2020, 2019); United States District Court, Northern District of California (2026, 2021, 2018); Crucial; Dell Technologies; Cisco Systems; Microsoft; IBM Deskstar 75GXP Litigation settlement administrator; The Register; Phison Electronics; U.S. Consumer Product Safety Commission
Guias relacionados: Um computador quebrado ou que não liga · Faça backup do PC inteiro
Mais estatísticas (43)
Algumas das falhas de unidade mais repentinas não foram desgaste, mas bugs no próprio firmware da unidade. Várias linhas de SSDs pararam de funcionar numa contagem exata de horas de funcionamento (power-on hours), de modo que unidades instaladas juntas falharam juntas. Defeitos em unidades de consumo levaram a programas de substituição e a ações coletivas; nenhum HD ou SSD foi objeto de recall nos EUA por perder dados.
Bugs de horas de funcionamento
- A HPE alertou que os SSDs SAS atingidos pelo seu bug de firmware das 32.768 horas não podiam ser recuperados, nem os seus dados, e que as unidades colocadas em serviço ao mesmo tempo provavelmente falhariam quase simultaneamente, de modo que o RAID não as protegeria (HPE, 2019).
- 19 modelos de SSD SAS da HPE (20 SKUs, de 400 GB a 15,3 TB) foram listados como afetados pela falha de firmware das 32.768 horas, uma lista que a HPE disse ser completa (HPE, 2019).
- A HPE disse que a sua falha de SSD das 40.000 horas não era exclusiva da HPE e podia afetar clientes de outros fabricantes que compraram as mesmas unidades; quatro modelos de SSD SAS da HPE foram listados (HPE, 2020).
- A Dell listou nove dos seus modelos de SSD SAS corporativos (LT0200MO a LT0800WM) como falhando em 40.000 horas de funcionamento com firmware anterior ao D417, e a unidade com falha passava a informar 0 GB de armazenamento disponível (Dell, 2020).
- A Cisco atribuiu a falha de SSD nas 40.000 horas de funcionamento (cerca de 4,5 anos) a um bug de índice de firmware presente em todo o setor, depois do qual a unidade passa a informar 0 GB e precisa ser substituída (Cisco, 2020).
- A base de conhecimento do vSAN da VMware lista uma falha de SSD em 32.000 ou 40.000 horas de funcionamento no firmware de três fabricantes de servidores (Dell abaixo do D417, HPE abaixo do HPD7, Cisco abaixo do C405), com grupos de discos ficando offline e possível perda de dados (Broadcom, 2025).
SSDs de consumo
- A Intel disse que uma unidade SSD 320 Series podia mostrar uma capacidade de 8 MB depois de uma queda inesperada de energia, em condições específicas, sem que nenhum dado nela pudesse ser lido depois disso, e lançou o firmware 4PC10362 para corrigir o problema (Intel, 2011).
- A Samsung disse que a queda anormal na leitura de saúde do S.M.A.R.T. dos seus SSDs 990 PRO foi causada por um problema de firmware, corrigido pelo firmware 1B2QJXD7, lançado em 13 de fevereiro de 2023, que não restaurou a saúde já perdida (Samsung, via ComputerBase, 2023).
- A Samsung lançou o firmware 7B2QJXD7 para o 990 PRO em setembro de 2025 para resolver um problema intermitente de não reconhecimento e de tela azul, e o 8B2QJXD7 em dezembro de 2025 para melhorar a estabilidade das operações de leitura (Samsung, 2025).
- A Puget Systems relatou taxas de falha em campo anormalmente altas do SSD Samsung 980 Pro de 2 TB nas suas estações de trabalho, com as unidades travando de repente em modo somente leitura, e a Samsung confirmou um problema no firmware 3B2QGXA7, corrigido pelo 5B2QGXA7 (Puget Systems, 2023).
- A Western Digital disse que um problema de firmware podia fazer com que as unidades SanDisk Extreme Portable SSD V2, SanDisk Extreme Pro Portable SSD V2 e WD My Passport SSD se desconectassem inesperadamente do computador, e lançou um atualizador de firmware com consulta por número de série (Western Digital, 2023).
- 145.000 SSDs portáteis SanDisk Extreme, Extreme Pro e WD My Passport foram potencialmente afetados pelo defeito de firmware de 2022-2023, pela própria estimativa da Western Digital, 69.173 deles nos Estados Unidos (N.D. Cal., 2026).
- Cerca de 10% dos SSDs portáteis SanDisk Extreme e Extreme Pro estavam “caindo aleatoriamente dos sistemas Mac”, segundo o que revendedores da Ásia-Pacífico e da América do Norte informaram à Western Digital em 20 de janeiro de 2023 (N.D. Cal., 2026).
- A Western Digital suspendeu o envio apenas dos SSDs portáteis SanDisk Extreme e Extreme Pro de 4 TB em 17 de fevereiro de 2023, não fez nenhum recall e corrigiu o firmware das unidades não vendidas em 15 de março de 2023, com um download para os donos só em junho ou julho de 2023 (N.D. Cal., 2026).
- Um tribunal federal certificou, em maio de 2026, classes da Califórnia e da Flórida de compradores dos SSDs portáteis SanDisk e WD com defeito, em pedidos que incluem fraude por omissão e violação de garantia implícita; o processo consolidado, aberto em agosto de 2023, não tinha acordo nos autos (N.D. Cal., 2026).
- A Phison realizou mais de 4.500 horas acumuladas de teste e mais de 2.200 ciclos de teste nos SSDs apontados como afetados pelas atualizações de agosto de 2025 do Windows 11 (KB5063878, KB5062660) e não conseguiu reproduzir as falhas relatadas (Phison, 2025).
- A Microsoft disse não ter encontrado nenhuma ligação entre a atualização de segurança de agosto de 2025 do Windows 11 (KB5063878) e as falhas de SSDs e HDs relatadas nas redes sociais, sem que a telemetria ou os testes internos mostrassem mais falhas de disco ou corrupção de arquivos (Microsoft, via BleepingComputer, 2025).
- A Phison disse que as falhas de SSD no Windows 11 reproduzidas pelo grupo de entusiastas PCDIY! ocorreram com firmware de pré-lançamento de engenharia, e não com o firmware vendido aos consumidores, e que as unidades do varejo submetidas aos mesmos testes de estresse (gravações de 100 GB e de 1 TB) não mostraram nenhuma falha (Phison, via Windows Report, 2025).
- A Samsung atribuiu a lentidão na leitura de dados antigos dos seus SSDs 840 EVO a um erro no seu algoritmo de gerenciamento da NAND que causava novas tentativas de leitura agressivas, e lançou um firmware e uma ferramenta de restauração de desempenho (Performance Restoration) em outubro de 2014; não houve perda de dados (AnandTech, 2014).
- A Samsung reconheceu em fevereiro de 2015 que alguns donos do 840 EVO voltaram a ver a lentidão na leitura de dados antigos depois da correção de outubro de 2014 e prometeu uma ferramenta Magician atualizada, uma correção que lançou em abril de 2015 (Samsung, via AnandTech, 2015).
- A Western Digital lançou um firmware para os SSDs M.2 WD_BLACK SN770, SN770M, WD Blue SN580, SN5000 e SanDisk Extreme de 2 TB, que podiam causar uma tela azul (BSOD) no Windows 11 24H2 por um problema do Host Memory Buffer (Western Digital, via The Register, 2024).
HDs
- A Western Digital confirmou em abril de 2020 que os seus HDs para NAS WD Red de 2 TB, 3 TB, 4 TB e 6 TB usavam gravação magnética sobreposta gerenciada pelo dispositivo (DMSMR) e, em junho de 2020, rebatizou os seus HDs para NAS convencionais (CMR) como WD Red Plus (Western Digital, 2020).
- A Western Digital reconheceu que os seus HDs para NAS WD Red SMR podem levar mais tempo para reconstruir um array RAID em alguns casos, e que o resilvering do ZFS lhes deixava pouco tempo ocioso, o que causou o desempenho bem menor relatado pelos usuários (Western Digital, 2020).
- US$ 2,7 milhões era o pagamento máximo da Western Digital no acordo homologado pela justiça na ação coletiva nos EUA sobre os HDs para NAS WD Red SMR comprados de outubro de 2018 a julho de 2021, incluindo honorários e custas (N.D. Cal., 2021).
- 46.898 pedidos foram apresentados no acordo coletivo do WD Red SMR, e os mais de 10.000 pedidos de pagamento por mais de cinco unidades cada somavam mais de 1 bilhão de unidades, então o tribunal aprovou a verificação de comprovantes de compra (N.D. Cal., 2021).
- A petição inicial da ação coletiva sobre o ST3000DM001 alegava que a taxa de falha anualizada de menos de 1% publicada pela Seagate era falsa, citando a contagem da Backblaze de que 1.423 de 4.829 HDs Seagate de 3 TB instalados (29,5%) tinham falhado até março de 2015; o tribunal deixou essa alegação seguir adiante (N.D. Cal., 2017).
- 0,34% era a taxa de falha anualizada que um manual do produto Seagate Barracuda de abril de 2011 dava para o ST3000DM001, e outros documentos da Seagate davam menos de 1%, segundo as provas descritas pelo tribunal (N.D. Cal., 2018).
- 2,621% era a taxa de falha anualizada real do primeiro ano na aprovação de embarque de outubro de 2011 da Seagate para os HDs ST3000DM001 vendidos pelos canais OEM e de distribuição, segundo o perito dos autores da ação, conforme descrito pelo tribunal (N.D. Cal., 2018).
- 3,436% era a taxa de falha anualizada do primeiro ano nos testes pós-lançamento de junho de 2012 da Seagate com o ST3000DM001 (Grenada Classic), contra a taxa de menos de 1% que ela anunciava, segundo o perito dos autores da ação, conforme descrito pelo tribunal (N.D. Cal., 2018).
- 1,29% era a taxa real de falha em campo de um produto de unidade da Seagate (codinome Pharaoh) ao longo de dois anos, contra 1,24% previstos pelos testes, segundo um gráfico da Seagate citado pelo perito dos autores da ação; o tribunal chamou a diferença de “cerca de doze por cento”, embora as duas taxas difiram em cerca de 4% (N.D. Cal., 2018).
- 2.400 horas de funcionamento por ano (cerca de 6,5 horas por dia) era o uso que a Seagate supunha no cálculo das classificações de confiabilidade das unidades de desktop, como o ST3000DM001, e 730 horas (duas horas por dia) para as unidades externas, segundo os peritos, conforme descrito pelo tribunal (N.D. Cal., 2018).
- A ação coletiva nos EUA sobre o HD ST3000DM001 de 3 TB da Seagate terminou sem classe certificada e sem acordo coletivo: o tribunal negou a certificação da classe em julho de 2018 e de novo em janeiro de 2019, e os autores desistiram da ação em caráter definitivo em maio de 2019, cada parte arcando com as próprias custas (N.D. Cal., 2019).
- A Apple criou um programa mundial para substituir, gratuitamente, um número muito pequeno de HDs Seagate de 1 TB em iMacs de 21,5 e 27 polegadas vendidos entre maio e julho de 2011 que podiam falhar em certas condições (Apple, 2011).
- A Seagate disse que um problema de firmware num número limitado de HDs Barracuda 7200.11 e de unidades SATA relacionadas fabricados até dezembro de 2008 podia, em algumas circunstâncias, tornar os dados inacessíveis quando o computador era ligado, e ofereceu uma atualização de firmware gratuita (Seagate, via MacTech, 2009).
- A Seagate ainda lista o firmware SD1A para oito modelos Barracuda 7200.11 (ST3500320AS a ST31000340AS), em substituição aos firmwares AD14, SD15 a SD19 e SD81, a atualização lançada para o defeito de 2009 (Seagate, 2026).
- US$ 100 por unidade com falha foi a oferta do acordo coletivo de 2005 nos EUA sobre os HDs IBM Deskstar 75GXP cujas falhas estavam documentadas nos registros de suporte ou de devolução da IBM; os donos cujas unidades não tinham falhado podiam escolher 25 CD-ROMs virgens ou um desconto de 15% na IBM (aviso do acordo, 2005).
- US$ 42,5 milhões era o fundo do acordo proposto na ação coletiva da Califórnia sobre os HDs de desktop Fujitsu MPG3xxx, que pagava US$ 45 por unidade substituída e até US$ 1.200 por unidade com dados perdidos, sem que a Fujitsu admitisse responsabilidade (The Register, 2003).
- Até US$ 1.200 por HD foi a oferta para perda de dados comprovada no acordo proposto sobre os HDs Fujitsu MPG3xxx com defeito, contra US$ 45 por unidade para os custos de substituição (The Register, 2003).
Recalls e programas de substituição
- Cerca de 60.000 fontes de alimentação das unidades de disco externas Iomega Jaz foram objeto de recall nos EUA em 1999 porque a sua carcaça podia se soltar e expor componentes eletrônicos energizados, um risco de choque (CPSC, 1999).
- Cerca de 66.000 pen drives Lexar JumpDrive FireFly e Secure II de 1 GB foram objeto de recall nos EUA em 2006 porque podiam superaquecer, um risco de queimadura e de danos materiais (CPSC, 2006).
- Nenhum HD ou SSD foi objeto de recall nos EUA por falhar ou perder dados, até onde mostra o banco de dados de recalls da CPSC: os cinco recalls ligados a armazenamento encontrados (de 1999 a 2009) foram de adaptadores de energia, fontes de alimentação ou pen drives que podiam superaquecer ou dar choque (CPSC, 1999-2009).
- A Apple criou um programa para substituir gratuitamente um número muito pequeno de HDs de 3 TB em iMacs de 27 polegadas vendidos entre dezembro de 2012 e setembro de 2013 que podiam falhar em certas condições (Apple, 2015).
- A Apple disse que um número limitado de SSDs de 128 GB e de 256 GB em notebooks MacBook Pro de 13 polegadas (sem Touch Bar) vendidos entre junho de 2017 e junho de 2018 tinha um problema que podia resultar em perda de dados e falha da unidade, e fez o reparo gratuitamente (Apple, 2018).
Fontes: Hewlett Packard Enterprise (2019, 2020); Dell Technologies; Cisco Systems; Broadcom; Intel Corporation, archived by Solidigm; ComputerBase; Samsung Semiconductor; Puget Systems; Western Digital (2020, 2023); United States District Court, Northern District of California (2017-2026); Phison Electronics; BleepingComputer; Windows Report; AnandTech, reporting Samsung's disclosure; AnandTech, quoting Samsung's statement; The Register (2003, 2024); Apple (2011, 2015, 2018); MacTech; Seagate Technology; IBM Deskstar 75GXP Litigation settlement administrator; U.S. Consumer Product Safety Commission (1999, 2006, 2009)
Quanto custa a recuperação de dados quando uma unidade falha?
A recuperação profissional de um HD pode custar de US$ 300 a mais de US$ 3.000 (SalvageData, 2026).

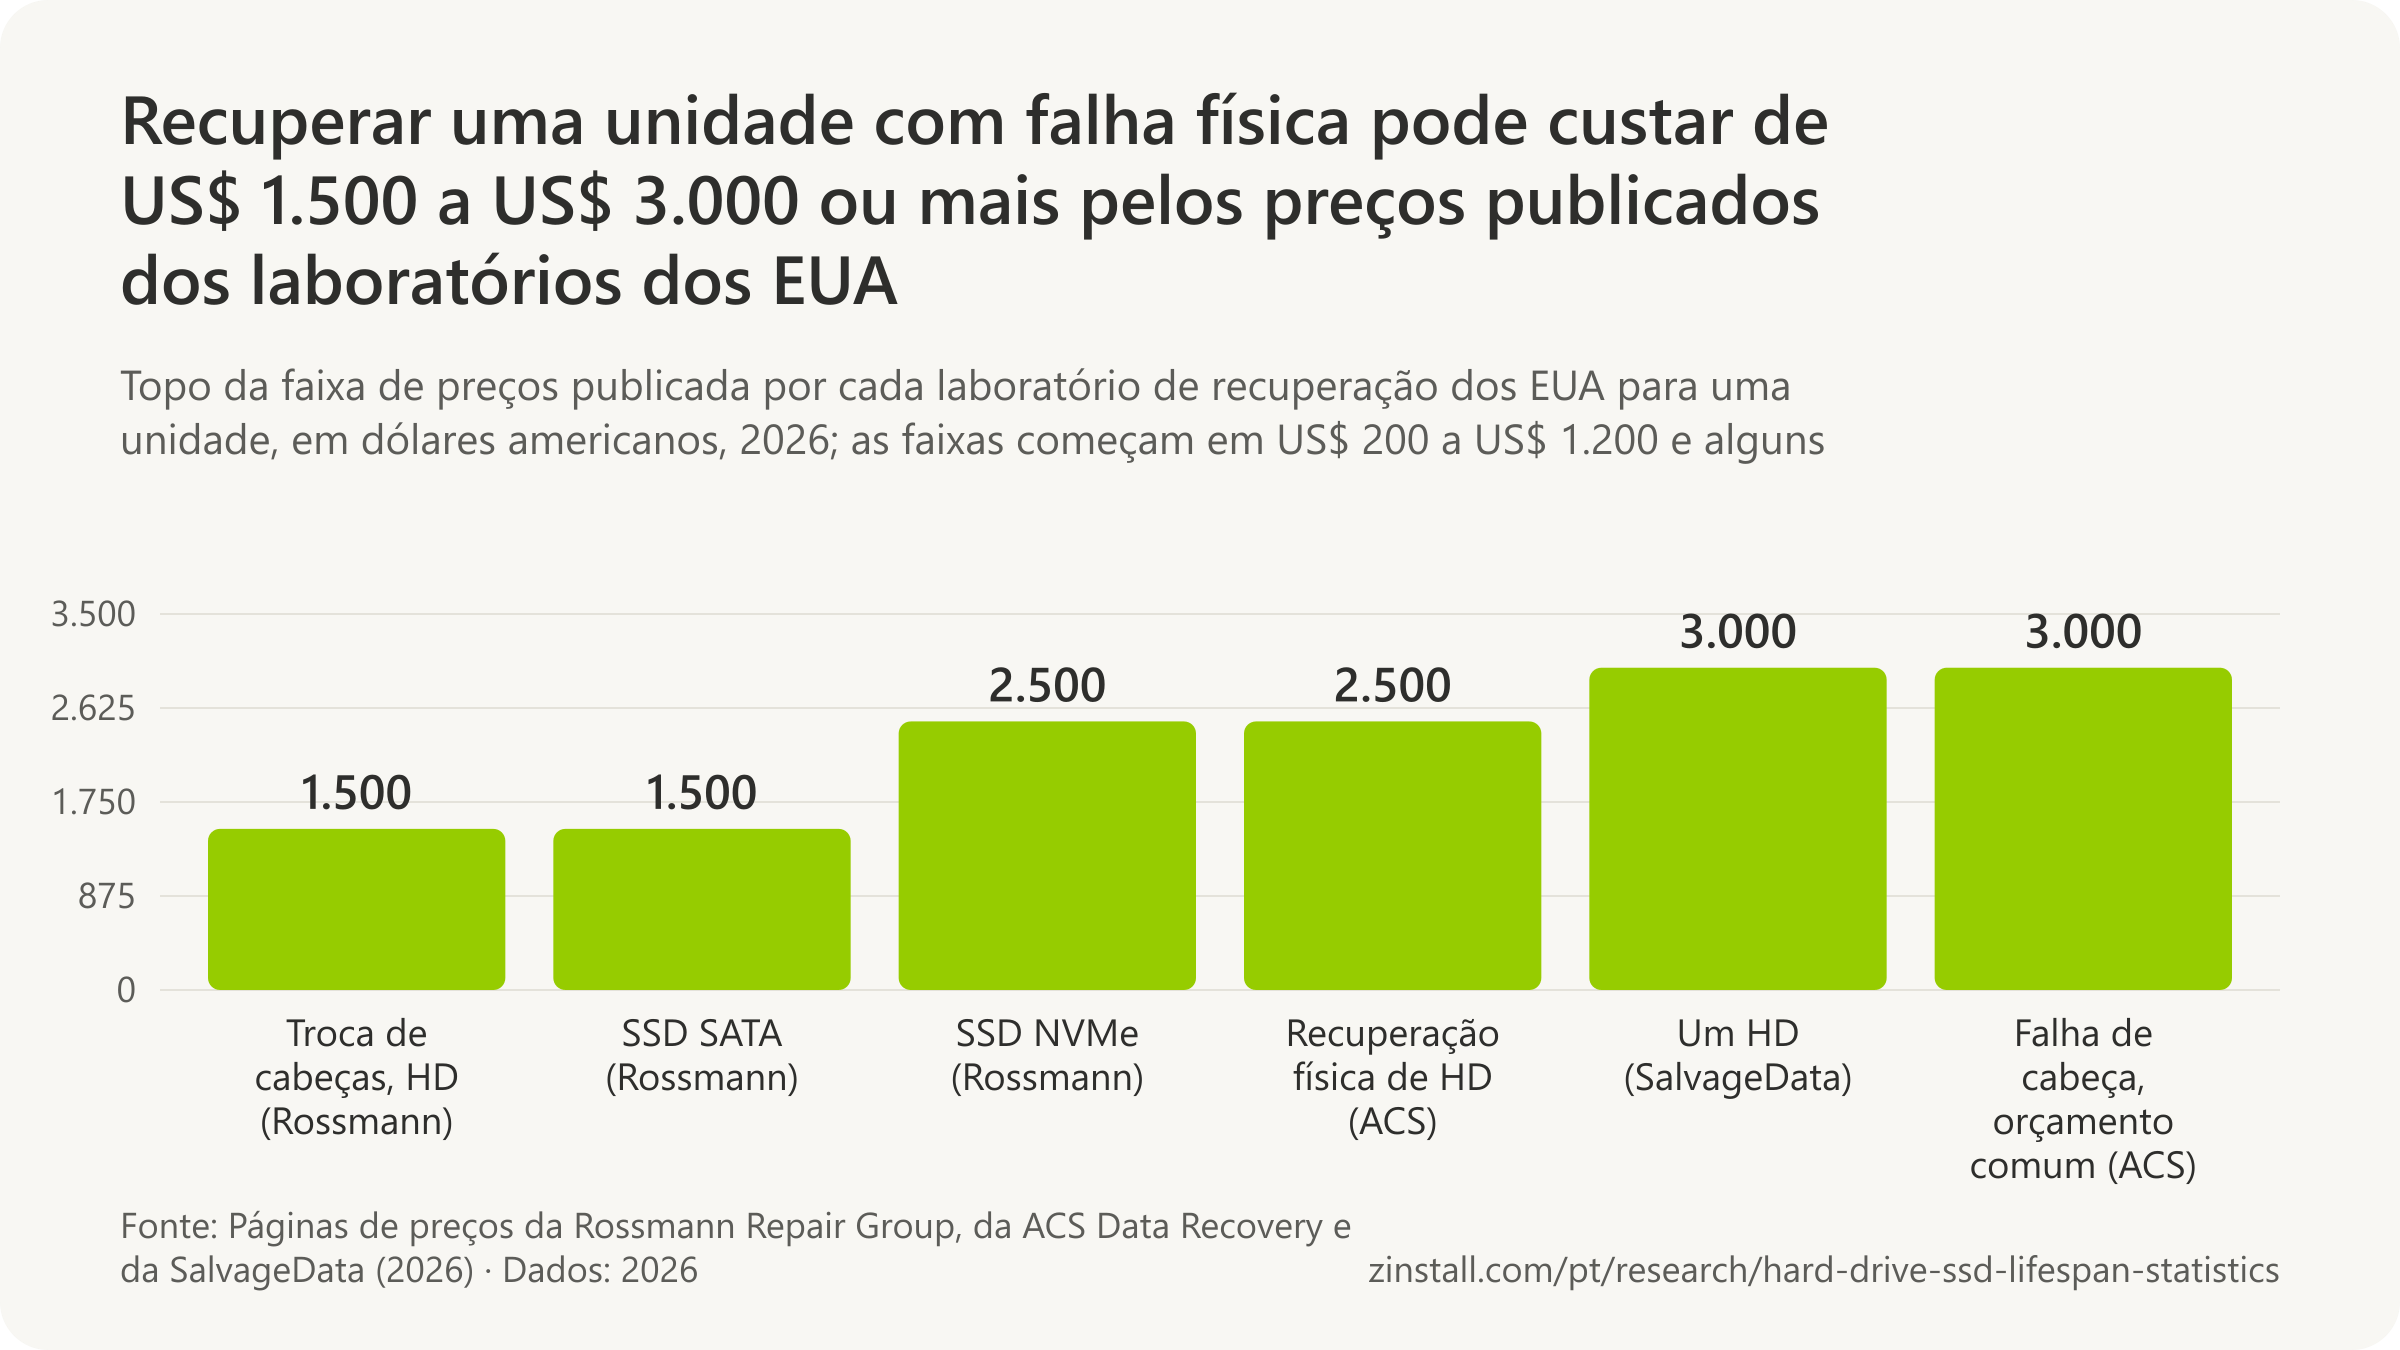
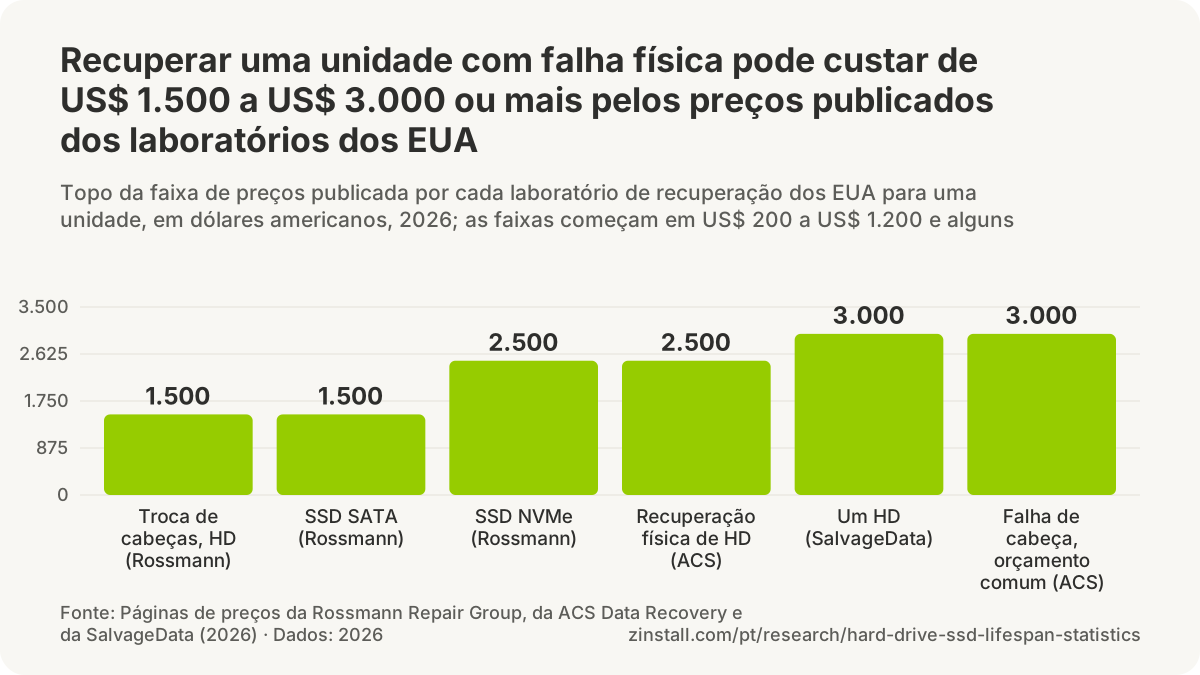
- Os laboratórios costumam cobrar de US$ 100 a US$ 300 por hora pela recuperação de dados.
- Uma recuperação com troca de cabeças num HD comum aparece na tabela por US$ 1.200 a US$ 1.500, mais uma unidade doadora.
- 0% dos HDs com um choque de cabeça grave puderam ser recuperados num laboratório australiano.
- 51% dos americanos já tinham perdido fotos, filmes ou outros arquivos por causa de uma falha do computador ou do HD.
- Cerca de 72.100 unidades foram enviadas para recuperação de dados no Japão em 2024, pela estimativa da associação do setor.
| Fonte e medida | Número |
|---|---|
| ACS: recuperação física de HD | US$ 900 a US$ 2.500 ou mais |
| ACS: um orçamento comum para falha de cabeça hoje | US$ 3.000 ou mais |
| Rossmann: recuperação de SSD SATA e NVMe | US$ 200 a US$ 2.500 |
| Secure Data Recovery: a taxa de sucesso que ela anuncia (sem definição publicada) | 96% |
| Laboratórios de recuperação: casos irrecuperáveis perdidos por danos físicos | 20,7% |
| Clientes da Ontrack que já tinham tido falha de SSD, 2016 | 38% |
| Pesquisa da Kroll Ontrack: dados perdidos após um mau funcionamento de SSD, 2015 | 61% |
| Adultos dos EUA que já perderam dados por qualquer causa, 2025 | 70,7% |
| Incidentes de perda de dados causados por falha de hardware, 2025 | 30% |
| Clientes da Kroll Ontrack que atribuíram a perda a uma falha de hardware, 2014 | 66% |
Fontes: SalvageData Recovery Services; Secure Data Recovery Services (2026, 2024); Rossmann Repair Group; Payam Data Recovery; Deloitte; Data Recovery Association of Japan; ACS Data Recovery; DeepSpar Data Recovery Systems; Ontrack; Kroll Ontrack (2015, 2014); Handy Recovery Advisor
Guias relacionados: Um computador quebrado ou que não liga · Um HD com setores defeituosos
Mais estatísticas (20)
Recuperar dados de uma unidade com falha física exige um reparo em sala limpa, e os laboratórios dos EUA publicam preços que vão de algumas centenas de dólares por um serviço simples a vários milhares para cabeças com defeito ou um SSD NVMe. O sucesso não é garantido: danos graves nos pratos podem tornar os dados irrecuperáveis. As pesquisas mostram que cerca de metade das pessoas já perdeu arquivos por causa de uma falha do computador ou da unidade em algum momento.
Preços
- 5,7 horas era o tempo médio de recuperação de um HD com dano físico na Secure Data Recovery, contra 3,4 horas para um problema de software (lógico), e 7,4 contra 4,1 horas nos SSDs, pela contagem da própria empresa (Secure Data Recovery, 2024).
- A recuperação profissional de dados costuma custar de US$ 100 a US$ 300 por hora, segundo a Secure Data Recovery, uma empresa de recuperação dos EUA (Secure Data Recovery, 2024).
Sucesso e fracasso
- 0% dos HDs com um choque de cabeça grave (dano nos pratos) puderam ser recuperados na Payam Data Recovery, enquanto as falhas de cabeça e de setores defeituosos tiveram uma alta taxa de sucesso, entre cerca de 30.000 unidades atendidas de 2020 a 2025 (Payam Data Recovery, 2025).
- 20,7% dos casos irrecuperáveis em 55 empresas de recuperação foram perdidos por danos físicos irreparáveis, como pratos riscados, e 13,3% por tentativas amadoras de recuperação feitas antes (pesquisa da DeepSpar, 2007-2010).
- A Secure Data Recovery anuncia uma taxa de sucesso de 96% nos seus serviços de recuperação, um número do seu próprio marketing, sem definição publicada (Secure Data Recovery, 2026).
Quantas unidades vão para recuperação

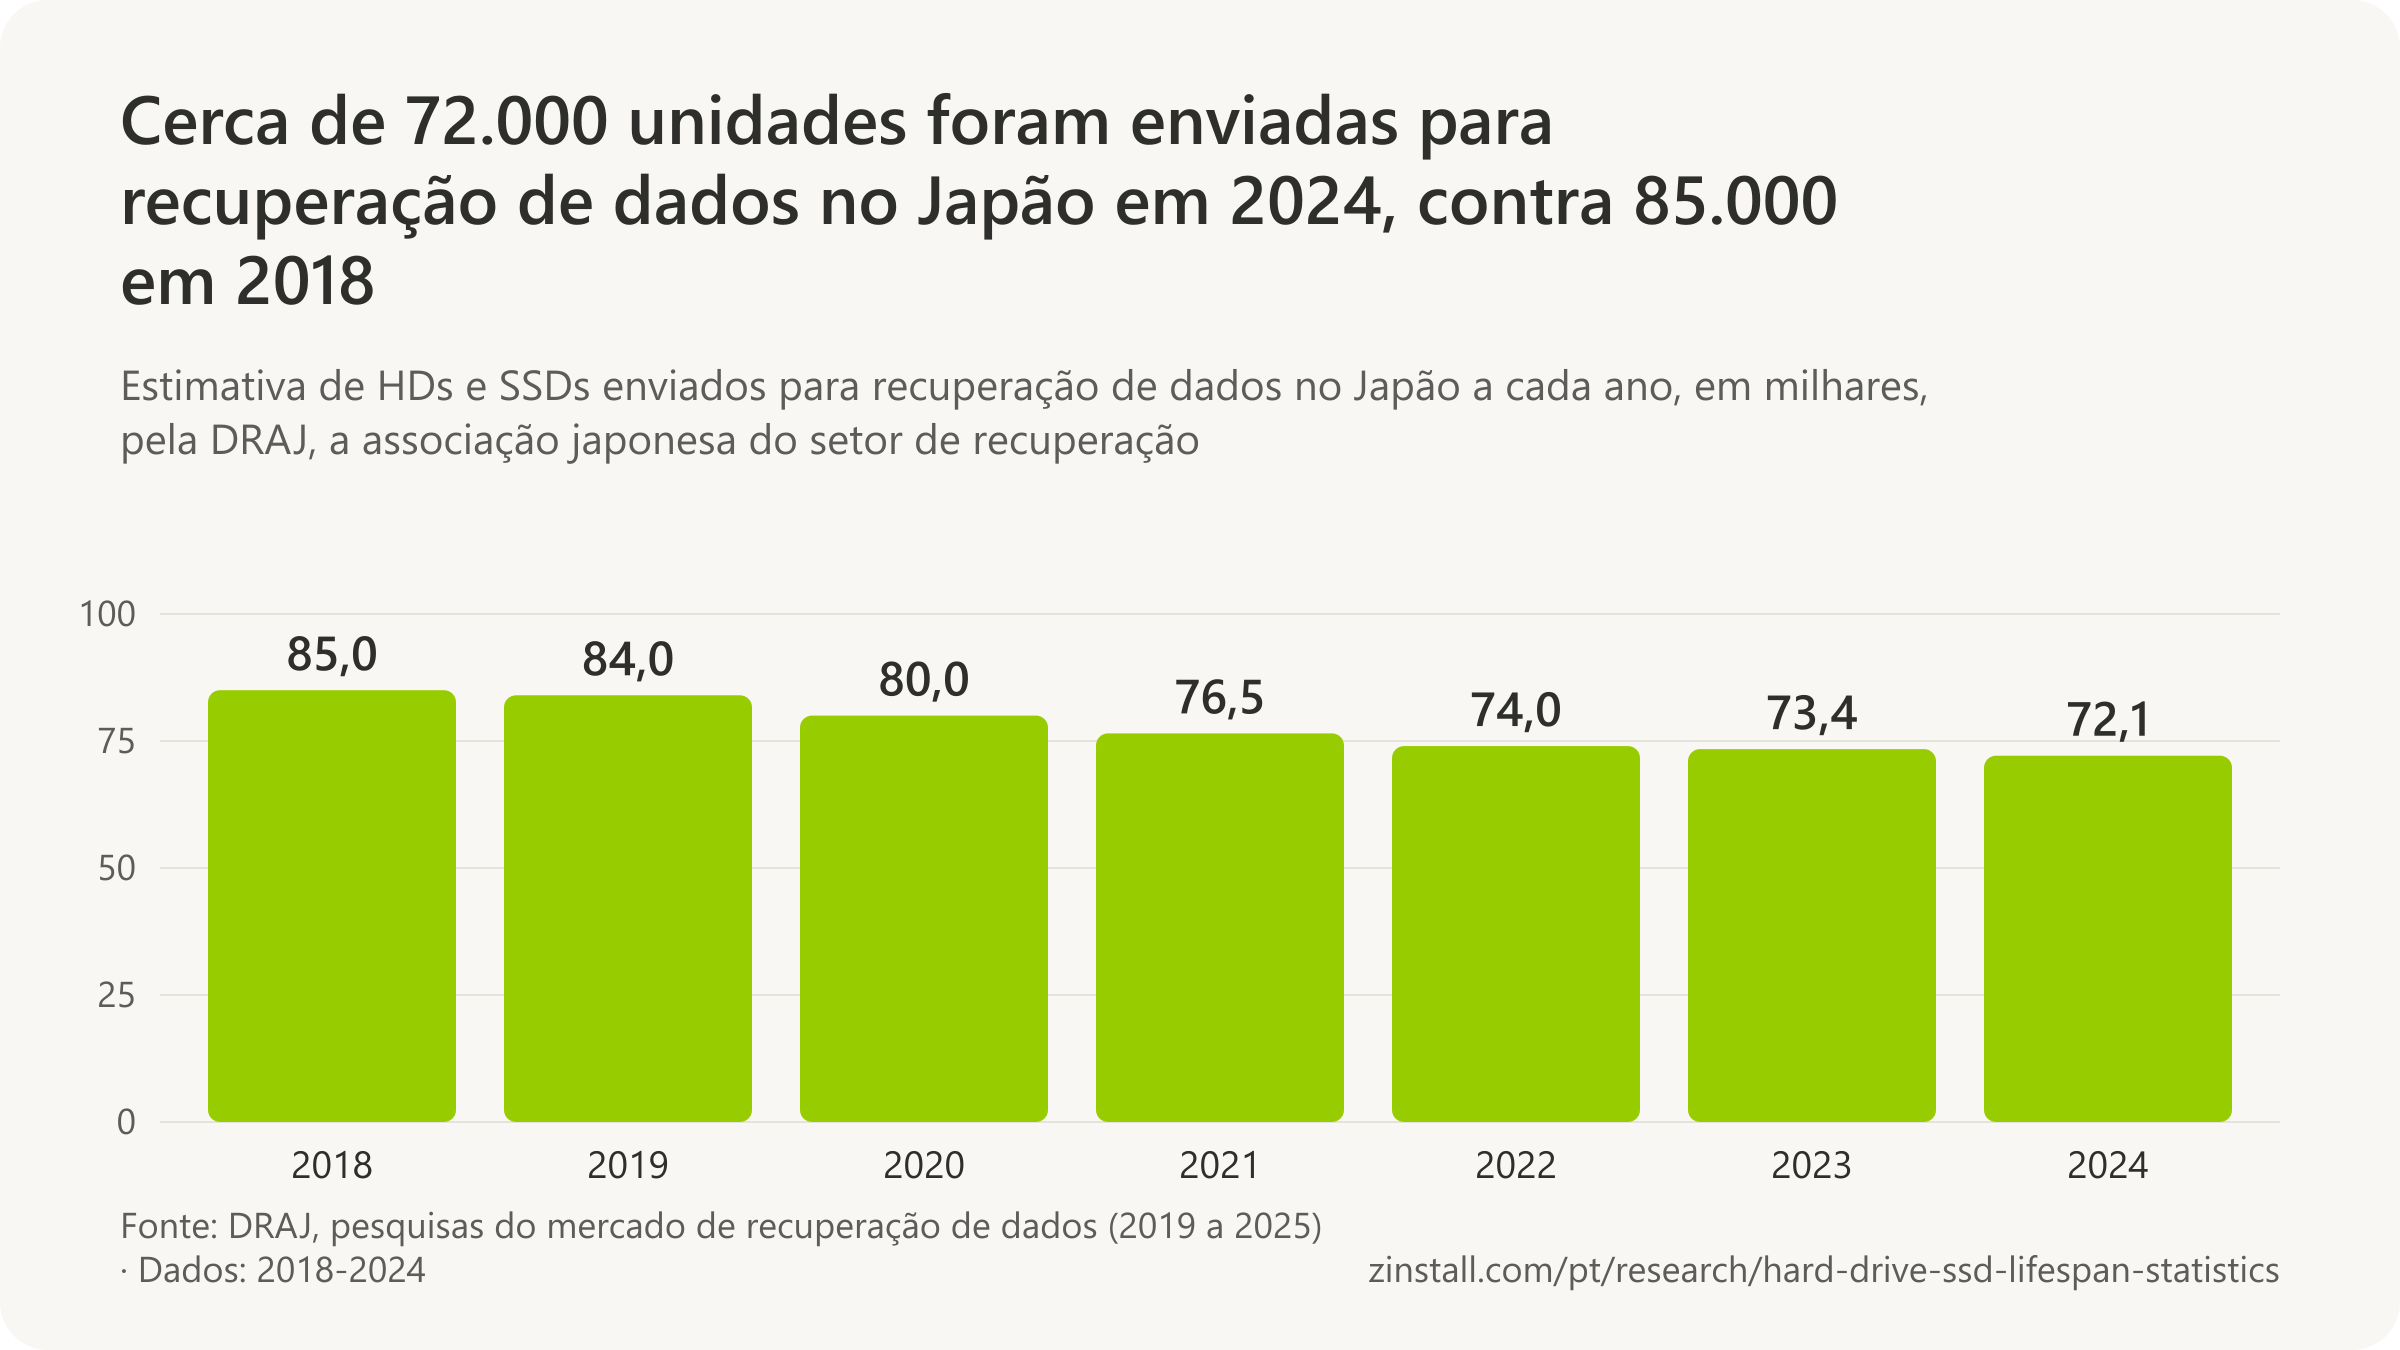
- 78% dos pedidos de recuperação de dados que a Ontrack recebeu em 2020 foram de HDs envelhecidos ou com dano físico, contra 3% de SSDs e 10% de dispositivos móveis, pela contagem da própria empresa (Ontrack, 2021).
- 85.700 unidades foram enviadas para recuperação profissional de dados no Japão em 2015, estimou a DRAJ (a Data Recovery Association of Japan) (DRAJ, 2016).
- 79.600 unidades foram enviadas para recuperação profissional de dados no Japão em 2016, estimou a DRAJ (a Data Recovery Association of Japan) (DRAJ, 2018).
- 87.500 unidades foram enviadas para recuperação profissional de dados no Japão em 2017, estimou a DRAJ (a Data Recovery Association of Japan) (DRAJ, 2019).
- Os pedidos de recuperação de SSDs na Kroll Ontrack mais que dobraram a cada ano, em média, de 2011 a 2014, pela contagem da própria empresa (Kroll Ontrack, 2015).
Pessoas que perderam dados por causa de uma unidade com falha
- 30% dos 496.142 cenários de perda de dados que a EaseUS registrou entre os usuários do seu software de recuperação vieram de danos físicos ao hardware, e cerca de 40% de erros lógicos (EaseUS, 2024).
- 38% dos casos de perda de dados recebidos por 55 empresas de recuperação em 15 países começaram com um HD que não respondia de jeito nenhum, e 29,9% com instabilidade de leitura, contra 12,8% por software e 12,1% por erro do usuário (pesquisa da DeepSpar, 2007-2010).
- 66% dos clientes recentes de recuperação de dados da Kroll Ontrack atribuíram a sua perda de dados mais recente a uma pane ou falha de hardware, contra 29% em 2010, entre 1.066 pesquisados (Kroll Ontrack, 2014).
- 72% dos clientes recentes de recuperação de dados da Kroll Ontrack disseram que a sua perda de dados mais recente veio de um HD de desktop ou de notebook, contra 15% de um SSD e 13% de sistemas RAID ou virtuais, entre 1.066 pesquisados (Kroll Ontrack, 2014).
- 61% dos entrevistados da pesquisa de SSDs de 2015 da Kroll Ontrack que tinham tido um mau funcionamento de SSD (um terço de quase 2.000) perderam dados, e menos de 20% os recuperaram (Kroll Ontrack, 2015).
- 38% dos 1.849 clientes de recuperação de dados da Ontrack pesquisados em maio de 2016 já tinham tido a falha de um SSD, e 64% deles perderam dados (Ontrack, 2016).
- 30% dos incidentes de perda de dados foram causados por falha de hardware e 34% por exclusão acidental, segundo 1.000 adultos dos EUA pesquisados pela Handy Recovery Advisor em junho de 2025 (Handy Recovery Advisor, 2025).
- 70,7% de 1.000 adultos dos EUA pesquisados pela Handy Recovery Advisor em junho de 2025 disseram ter perdido dados pelo menos uma vez, por qualquer causa (Handy Recovery Advisor, 2025).
- 51% dos americanos tinham passado por uma falha do computador ou do HD que os fez perder fotos, filmes ou outros conteúdos digitais, entre quase 2.000 consumidores de 14 a 75 anos pesquisados para a Deloitte em 2010 (Deloitte, 2011).
- 65% dos australianos da pesquisa de clientes de 2014 da Kroll Ontrack disseram que a sua perda de dados mais recente veio de um HD de desktop ou de notebook, contra 16% de um SSD e 12% de um tablet ou smartphone (Kroll Ontrack, 2014).
Fontes: Secure Data Recovery Services (2024, 2026); Payam Data Recovery; DeepSpar Data Recovery Systems; Ontrack (2014, 2016, 2021); Data Recovery Association of Japan (2016-2025); Kroll Ontrack (2014, 2015); EaseUS Software; Handy Recovery Advisor; Deloitte
Quanto tempo duram pen drives, cartões SD, CDs, DVDs e fitas?
Estimou-se que 10% dos CDs prensados falhariam em menos de 25 anos, em testes de envelhecimento acelerado (Library of Congress, 2009).

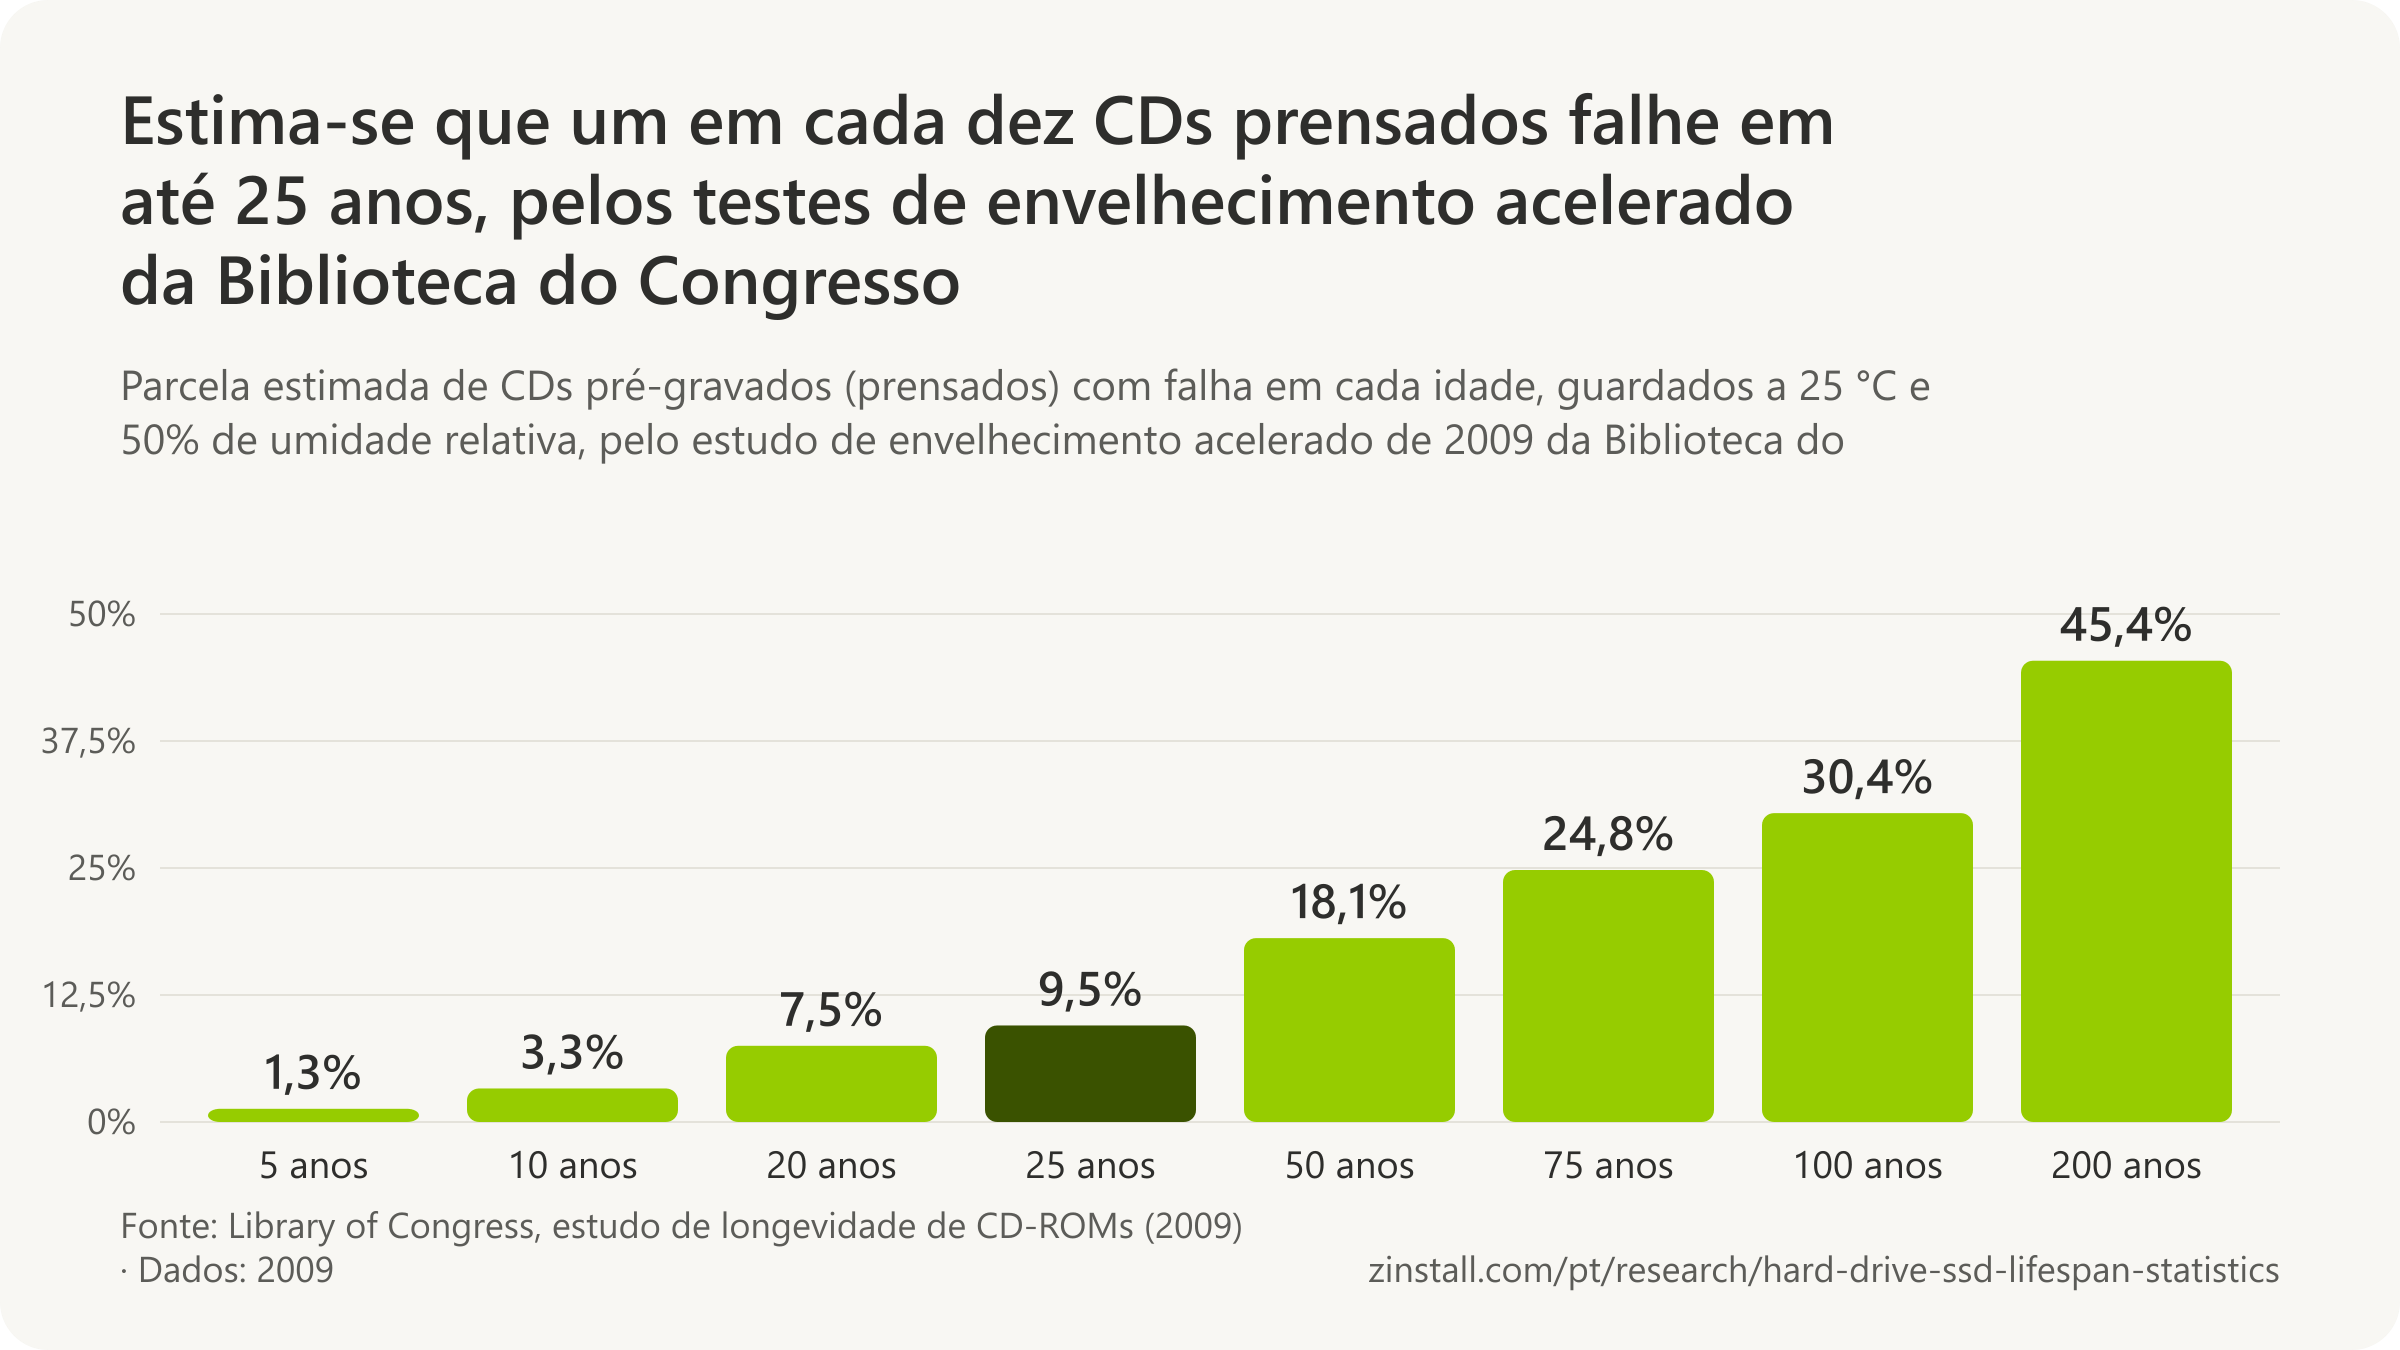
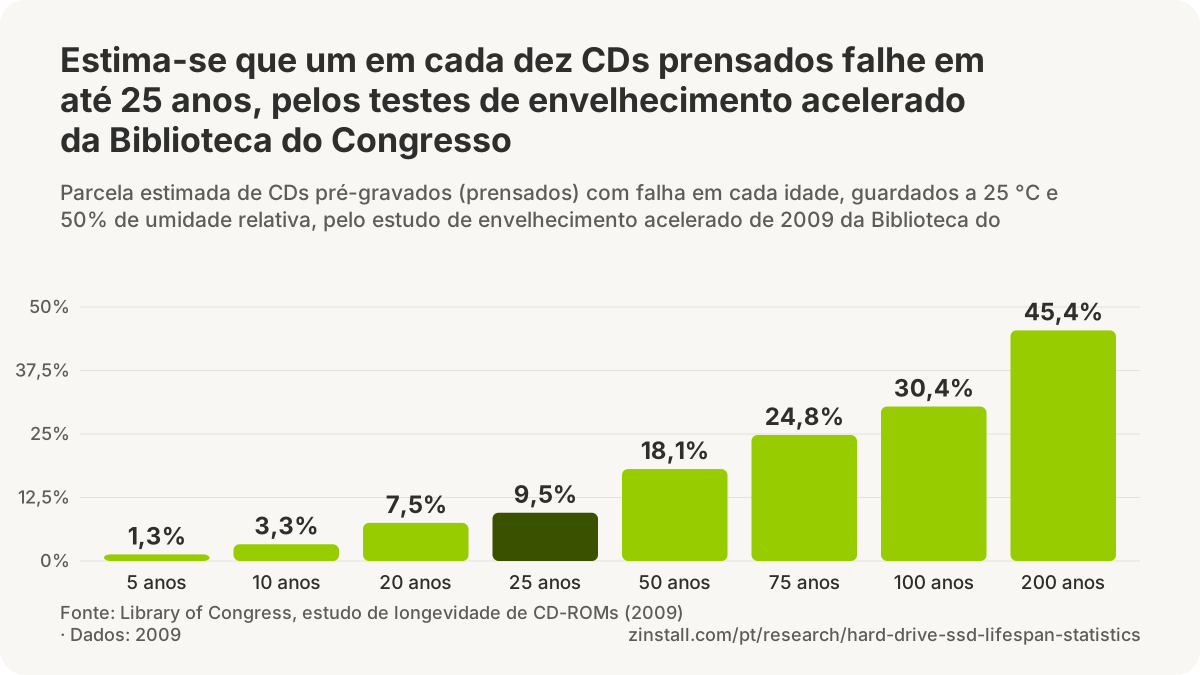
- Os discos Blu-ray graváveis dividem a classificação de longevidade mais baixa de todos os discos, 5 a 10 anos, com o DVD+R de camada dupla.
- Os DVDs M-DISC duraram menos de 250 horas no teste de calor e umidade do laboratório nacional de ensaios da França, nada melhor que os DVDs comuns.
- Um cartão microSD tem classificação de 140.160 horas de gravação, 16 anos, mas garantia de 5.
- A fita de dados LTO pode proteger os dados por até 30 anos, segundo as empresas por trás do formato.
- Os arquivistas recomendam fazer cópias novas dos arquivos digitais em mídias novas pelo menos a cada cinco anos.
| Tipo de disco | Longevidade média |
|---|---|
| CD-R, corante de ftalocianina, camada de ouro | mais de 100 anos |
| CD-R, corante de ftalocianina, camada de liga de prata | 50 a 100 anos |
| CD-R, corante de cianina ou azo, camada de liga de prata | 20 a 50 anos |
| CD somente leitura (CD de áudio, CD-ROM) | 50 a 100 anos |
| DVD-R, camada de ouro | 50 a 100 anos |
| DVD-R, camada de liga de prata | 10 a 20 anos |
| DVD+R, camada de liga de prata | 20 a 50 anos |
| DVD+R DL (camada dupla) | 5 a 10 anos |
| DVD ou Blu-ray somente leitura (discos de filmes) | 10 a 20 anos |
| Regraváveis CD-RW, DVD+RW, BD-RE | 20 a 50 anos |
Fontes: Library of Congress, Preservation Research and Testing Division; Canadian Conservation Institute; Laboratoire national de métrologie et d'essais; Samsung Electronics; LTO Program; Library of Congress
Guias relacionados: Faça backup do PC inteiro · Transferir com um HD externo ou pen drive
Mais estatísticas (69)
Os CDs prensados foram os que melhor resistiram nos testes da Biblioteca do Congresso, e os discos graváveis variaram muito mais pelo corante e pelo metal do que pela marca; o Blu-ray gravável divide com o DVD+R de camada dupla a classificação mais baixa de todos os discos. Cartões de memória e pen drives vêm com classificações de resistência e garantias, mas sem taxas de falha publicadas. Os fabricantes de fitas classificam seus cartuchos para décadas, e os provedores de nuvem publicam metas de projeto para a durabilidade. O conselho dos arquivistas é o mesmo para qualquer mídia: fazer cópias novas a cada cinco a dez anos.
CDs e DVDs
- 100 a 200 anos ou mais é a expectativa de vida com que os fabricantes de discos concordaram para os discos CD-R, DVD-R e DVD+R gravados, em armazenamento recomendado, uma alegação dos fabricantes baseada em envelhecimento acelerado, com poucos testes independentes por trás (NIST, 2003).
- 25 anos ou mais é a expectativa de vida que os fabricantes de discos alegavam para os discos regraváveis CD-RW, DVD-RW, DVD+RW e DVD-RAM, contra 100 a 200 anos para os discos de gravação única (NIST, 2003).
- 20 a 100 anos era a faixa de expectativas de vida dos discos prensados CD-ROM e DVD-ROM (áudio, vídeo, software), com pouca informação publicada sobre eles (NIST, 2003).
- 5 a 10 anos é o prazo de validade antes da gravação que os fabricantes alegavam para discos CD-R e DVD-R virgens, uma alegação que o NIST não encontrou testes publicados para verificar (NIST, 2003).
- Cerca de 1.000 ciclos de apagamento e regravação é o limite dos CDs e DVDs regraváveis, e cerca de 100.000 o dos discos DVD-RAM, e cada regravação encurta a vida do disco (NIST, 2003).
- Algumas semanas de luz solar direta podem bastar para fazer um CD ou DVD gravável falhar, conforme o disco e a intensidade da luz, nos testes de estresse do NIST com discos comerciais (NIST, 2004).
- 5 dos 7 produtos CD-R testados tiveram uma expectativa de vida estimada de mais de 45 anos a 25 °C e 50% de umidade relativa, e os outros dois de 30 a 45 anos, no estudo de envelhecimento acelerado do NIST e da Biblioteca do Congresso com discos comprados em 2005 (NIST e Library of Congress, 2007).
- 7 dos 15 produtos DVD graváveis e regraváveis testados tiveram uma expectativa de vida estimada de mais de 45 anos a 25 °C e 50% de umidade relativa, e mais 4 de 30 a 45 anos (NIST e Library of Congress, 2007).
- 4 dos 15 produtos DVD testados tiveram duração estimada de menos de 30 anos a 25 °C e 50% de umidade relativa, 2 deles de menos de 15 anos, contra nenhum dos produtos CD-R (NIST e Library of Congress, 2007).
- 776 anos era a vida média estimada dos CDs pré-gravados guardados a 25 °C e 50% de umidade relativa no estudo de envelhecimento acelerado da Biblioteca do Congresso, embora a estimativa fosse de que 10% dos discos falhariam em menos de 25 anos (Library of Congress, 2009).
- Estimou-se que 10% dos CDs pré-gravados testados falhariam em menos de 25 anos, incluindo 5% que falharam cedo demais para uma estimativa, enquanto 16% mostraram um aumento de erros pequeno demais para chegar a falhar no teste (Library of Congress, 2009).
- Guardar CDs a 7 °C e 35% de umidade relativa poderia fazê-los durar 17 vezes mais que a 25 °C e 50%, e um grau a menos já acrescenta 18% à vida média, pelo modelo da Biblioteca do Congresso para o seu teste de discos (Library of Congress, 2009).
- 4% de 125 CDs de áudio do acervo da Biblioteca do Congresso tinham passado do limite de erros da ISO depois de 15 anos de envelhecimento natural em condições ambientes, acompanhados por testes periódicos desde 1996 (Library of Congress, 2015).
- 2 a 5 anos é a expectativa de vida empírica de um CD ou DVD segundo a orientação do Arquivo Nacional dos EUA para os órgãos que guardam registros temporários, embora as expectativas de vida publicadas muitas vezes sejam citadas como de 10 ou 25 anos ou mais (NARA, 2007).
- 15 a 200 anos é a vida útil que os fabricantes de mídias ópticas alegavam com base em experimentos de envelhecimento acelerado, com prazos mais longos para discos gravados do que para os virgens, disse o Arquivo Nacional dos EUA aos gestores de documentos (NARA, 2007).
- 70 a mais de 200 anos é a vida útil dos CD-R que os próprios estudos de longevidade dos fabricantes alegavam, disse a Optical Storage Technology Association (a entidade do setor de discos) (OSTA, 2001).
- 5 a 10 anos é o prazo de validade de um CD-R virgem antes da gravação pela estimativa dos fabricantes de mídias, como disse a entidade do setor de discos (OSTA, 2001).
- Muitos discos Blu-ray, graváveis, regraváveis e discos de filmes somente leitura, ficaram significativamente degradados depois de apenas 21 dias a 80 °C e 85% de umidade relativa, o que põe o Blu-ray muito abaixo em estabilidade entre os formatos ópticos (Canadian Conservation Institute, 2018).
| Tipo de disco | Longevidade média |
|---|---|
| CD-R, corante de ftalocianina, camada de ouro | mais de 100 anos |
| CD-R, corante de ftalocianina, camada de liga de prata | 50 a 100 anos |
| CD-R, corante de cianina ou azo, camada de liga de prata | 20 a 50 anos |
| CD somente leitura (CD de áudio, CD-ROM) | 50 a 100 anos |
| DVD-R, camada de ouro | 50 a 100 anos |
| DVD-R, camada de liga de prata | 10 a 20 anos |
| DVD+R, camada de liga de prata | 20 a 50 anos |
| DVD+R DL (camada dupla) | 5 a 10 anos |
| DVD ou Blu-ray somente leitura (discos de filmes) | 10 a 20 anos |
| BD-R, com ou sem corante (Blu-ray gravável) | 5 a 10 anos |
| BD-R, sem corante, camada de ouro | 10 a 20 anos |
| Regraváveis CD-RW, DVD+RW, BD-RE | 20 a 50 anos |
- De uns dois anos a mais de 200 anos é quanto os discos ópticos graváveis podem durar, segundo as pesquisas, os relatos e a literatura dos fabricantes que o Canadian Conservation Institute analisou, e é por isso que bibliotecas e arquivos desconfiam deles (Canadian Conservation Institute, 2019).
- 2 a 10 anos é o prazo em que os discos graváveis podem falhar se forem mal escolhidos, gravados, manuseados ou guardados, alerta o Canadian Conservation Institute (Canadian Conservation Institute, 2019).
M-DISC
- 1.332 anos é a vida média esperada que a Millenniata calculou para o seu DVD M-DISC guardado a 25 °C e 50% de umidade relativa, pelo seu próprio teste de envelhecimento acelerado ISO/IEC 10995 (Millenniata, 2013).
- Os discos M-DISC DVD+R duraram menos de 250 horas a 90 °C e 85% de umidade relativa no laboratório nacional de ensaios da França, não mais que os DVDs graváveis comuns, enquanto um DVD de vidro passou 1.000 horas sem alteração (LNE, 2012).
- Apenas 1 de 7 modelos de disco, um DVD gravado em vidro, sobreviveu a 1.000 horas a 90 °C e 85% de umidade relativa, mais de quatro vezes o tempo do melhor DVD gravável (LNE, 2012).
Cartões de memória e pen drives
- A Samsung classifica o seu cartão microSD PRO Endurance de 256 GB para até 140.160 horas (16 anos) de gravação contínua em Full HD, mas a sua garantia limitada cobre 5 anos (Samsung, 2022).
- Cerca de 1.640 TB de vídeo, aproximadamente 6.400 regravações completas do cartão, é o que a classificação de 140.160 horas da Samsung para o cartão PRO Endurance de 256 GB implica, à taxa de gravação declarada de 3,25 MB/s (derivado de dados da Samsung, 2022).
- A SanDisk classifica o seu cartão microSD MAX ENDURANCE de 256 GB para até 120.000 horas (mais de 13 anos) de gravação em Full HD, com garantia limitada de 15 anos, contra 15.000 horas e 3 anos para o cartão de 32 GB (SanDisk, 2026).
- A SanDisk classifica os seus cartões microSD HIGH ENDURANCE para 2.500 horas (32 GB) a 40.000 horas (512 GB) de gravação em Full HD, todos com garantia limitada de 2 anos (SanDisk, 2026).
- A Kingston classifica o seu cartão microSD High Endurance para 3.000 ciclos de programação/apagamento e 26.900 horas de gravação 24/7, que a sua garantia de 3 anos cobre (Kingston, 2026).
- A Kingston classifica o seu cartão microSD Industrial, que usa flash TLC no modo pSLC de um bit, para 30.000 ciclos de programação/apagamento e até 3.840 TB gravados, dez vezes os ciclos do seu cartão High Endurance, com garantia de 3 anos (Kingston, 2026).
- A Lexar classifica o seu cartão microSD High-Endurance para até 12.000 horas de gravação em Full HD no modelo de 128 GB (3.000 horas no de 32 GB), com garantia limitada de 2 anos (Lexar, 2026).
- 10 anos é a garantia limitada do cartão microSD PRO Plus da Samsung, mas ela não se estende a câmeras veiculares (dashcams), CFTV, câmeras de vigilância ou outros usos com gravação intensa, para os quais a Samsung vende a linha PRO Endurance, de 5 anos (Samsung, 2026).
- A SanDisk vende os seus cartões microSD Extreme com garantia limitada vitalícia em todas as capacidades, contra 2 anos para os seus cartões HIGH ENDURANCE, feitos para gravação contínua (SanDisk, 2026).
- 5 anos é a garantia que a Kingston dá aos seus pen drives DataTraveler, enquanto os seus cartões SD e microSD são cobertos pela vida útil do produto, que ela define como o tempo normal de vida esperado desses produtos, 10 anos na Rússia (Kingston, 2024).
- 5 anos é a garantia limitada do pen drive SanDisk Ultra USB 3.0, o mesmo prazo que a Kingston dá aos seus pen drives DataTraveler (SanDisk, 2026).
- O cartão microSD mediano falhou por completo depois de 3.616 ciclos completos de gravação e verificação (média de 5.362), entre 119 cartões que um testador amador gravou até a morte, um teste de tortura e não um uso cotidiano (Matt Cole, 2025).
- 84 de 119 cartões microSD (71%) que falharam no teste amador de gravação até a morte pararam de funcionar ou se travaram em modo somente leitura antes mesmo de metade dos seus setores ficar defeituosa, então os cartões tendem a morrer de repente, e não a se desgastar aos poucos (Matt Cole, 2025).
Fitas
- Cerca de 100 anos à temperatura ambiente (20 a 25 °C) se passariam antes que fitas de áudio de poliéster reproduzíveis chegassem à condição das que não podem mais ser reproduzidas, contra a expectativa de vida de 10 a 30 anos das orientações mais antigas, num estudo de envelhecimento acelerado da Biblioteca do Congresso e da Fujifilm (CLIR, 2022).
- Cerca de 30 anos é o tempo que fitas de áudio em bom estado podem continuar reproduzíveis num armazenamento quente e sem controle, como sótãos ou depósitos antigos (40 °C), contra cerca de 100 anos à temperatura ambiente (CLIR, 2022).
- Até 30 anos é o tempo que a fita de dados LTO pode proteger os dados, afirma o LTO Program (as empresas por trás do formato, HPE, IBM e Quantum), uma alegação de fabricante, e não uma vida útil medida (LTO Program, 2025).
- 1 erro de leitura incorrigível a cada 12,5 exabytes lidos (10^20 bits) é a especificação de fim de vida da fita LTO-9, um número de projeto que o LTO Program compara aos 10^15 bits de um HD típico (LTO Program, 2022).
- Mais de 50 anos é a vida magnética que a Fujifilm e a associação japonesa do setor eletrônico JEITA estimaram para a fita LTO-7 de ferrita de bário a 25 °C, contra pelo menos 20 anos para a fita LTO-5 de partículas metálicas, mais antiga, em testes acelerados do fabricante da fita (Fujifilm e JEITA, 2019).
Durabilidade do armazenamento em nuvem
- 99,999999999% (11 noves) é a durabilidade de dados que o Amazon S3 é projetado para superar, uma meta de projeto e não uma taxa de perda medida, com os dados armazenados em pelo menos três Zonas de Disponibilidade por padrão (Amazon Web Services, 2026).
- 1 objeto a cada 10.000 anos é a perda média que a AWS disse esperar ao armazenar 10.000.000 de objetos no Amazon S3, a sua própria ilustração de uma meta de projeto de durabilidade anual de 11 noves (Amazon Web Services, 2018).
- 99,999999999% (11 noves) ao ano é a durabilidade mínima para a qual a Microsoft projeta a opção mais barata do Azure, o armazenamento com redundância local (cópias num único data center), uma meta de projeto (Microsoft, 2026).
- 99,99999999999999% (16 noves) ao ano é a durabilidade mínima para a qual a Microsoft projeta o armazenamento com redundância geográfica do Azure, que copia os dados para uma segunda região a centenas de milhas de distância, uma meta de projeto (Microsoft, 2026).
- 99,999999999% (11 noves) ao ano é a durabilidade mínima para a qual o Google Cloud Storage é projetado, qualquer que seja a classe de armazenamento e o local, com codificação de apagamento (erasure coding) em vários dispositivos, uma meta de projeto (Google Cloud, 2026).
- 99,999999999% (11 noves) ao ano é a durabilidade que a Backblaze calcula para o seu armazenamento em nuvem B2, um número modelado para arquivos divididos em 17 fragmentos de dados e 3 de paridade, acima dos 8 noves que ela publicava antes (Backblaze, 2018).
O que os arquivistas recomendam
- Pelo menos a cada 5 anos, as pessoas devem criar novas cópias de arquivamento dos seus arquivos digitais em mídias novas, recomenda a Biblioteca do Congresso, porque todas as mídias de armazenamento digital têm vida curta (Library of Congress, 2011).
- 10 anos é a idade até a qual os órgãos federais dos EUA precisam copiar os registros permanentes guardados em mídias de armazenamento magnético para mídias novas testadas, pelo regulamento de armazenamento de registros do Arquivo Nacional dos EUA (NARA, 2016).
- Pelo menos 10 anos de vida útil comprovada é o que o Arquivo Nacional do Reino Unido pede de uma mídia de armazenamento escolhida para preservação de longo prazo, acrescentando que, além disso, a obsolescência das unidades que a leem importa mais que a deterioração da mídia (The National Archives, 2008).
- Os pen drives e os cartões de memória flash tiveram a nota mais baixa em longevidade (1 de 3) e no geral (10 de 18) no exemplo de avaliação de mídias de armazenamento do Arquivo Nacional do Reino Unido, contra 2 para os HDs e 3 para CD-R, DVD-R e fita LTO (The National Archives, 2008).
- 100 anos é a vida média de arquivamento que a Sony estima para os discos dos seus cartuchos Optical Disc Archive, pelos seus próprios testes acelerados pelo método ISO/IEC 16963, uma estimativa do fabricante para um sistema profissional já descontinuado (Sony, 2025).
- Mais de 10.000 anos à temperatura ambiente é o tempo que, segundo as projeções, os dados gravados a laser em vidro devem permanecer estáveis, pelo envelhecimento acelerado do Project Silica da Microsoft Research, um sistema de pesquisa e não um produto à venda (Nature, 2026).
Números que circulam
Fontes: National Institute of Standards and Technology and Council on Library and Information Resources; National Institute of Standards and Technology; National Institute of Standards and Technology and Library of Congress; Library of Congress, Preservation Research and Testing Division (2009, 2015); US National Archives and Records Administration (2007); Optical Storage Technology Association; Canadian Conservation Institute, in Restaurator 39, 129-155; Canadian Conservation Institute; Millenniata, Inc. (2011, 2013); Laboratoire national de métrologie et d'essais; Samsung Electronics (2022, 2026); Sandisk (2026); Kingston Technology (2024, 2026); Lexar; Matt Cole; Council on Library and Information Resources, research by the Library of Congress Preservation Research and Testing Division and FUJIFILM Recording Media Products Division; Council on Library and Information Resources, research by the Library of Congress and FUJIFILM; LTO Program (2022, 2025); FUJIFILM Corporation and JEITA; Amazon Web Services (2018, 2026); Microsoft; Google Cloud; Backblaze; Library of Congress; US National Archives and Records Administration, Code of Federal Regulations; The National Archives; Sony; Nature
Ainda vale a pena comprar HDs?
As remessas mundiais de HDs somaram 124,3 milhões de unidades em 2025, cerca de um quinto dos 651 milhões de 2010 (Coughlin Associates, 2026).

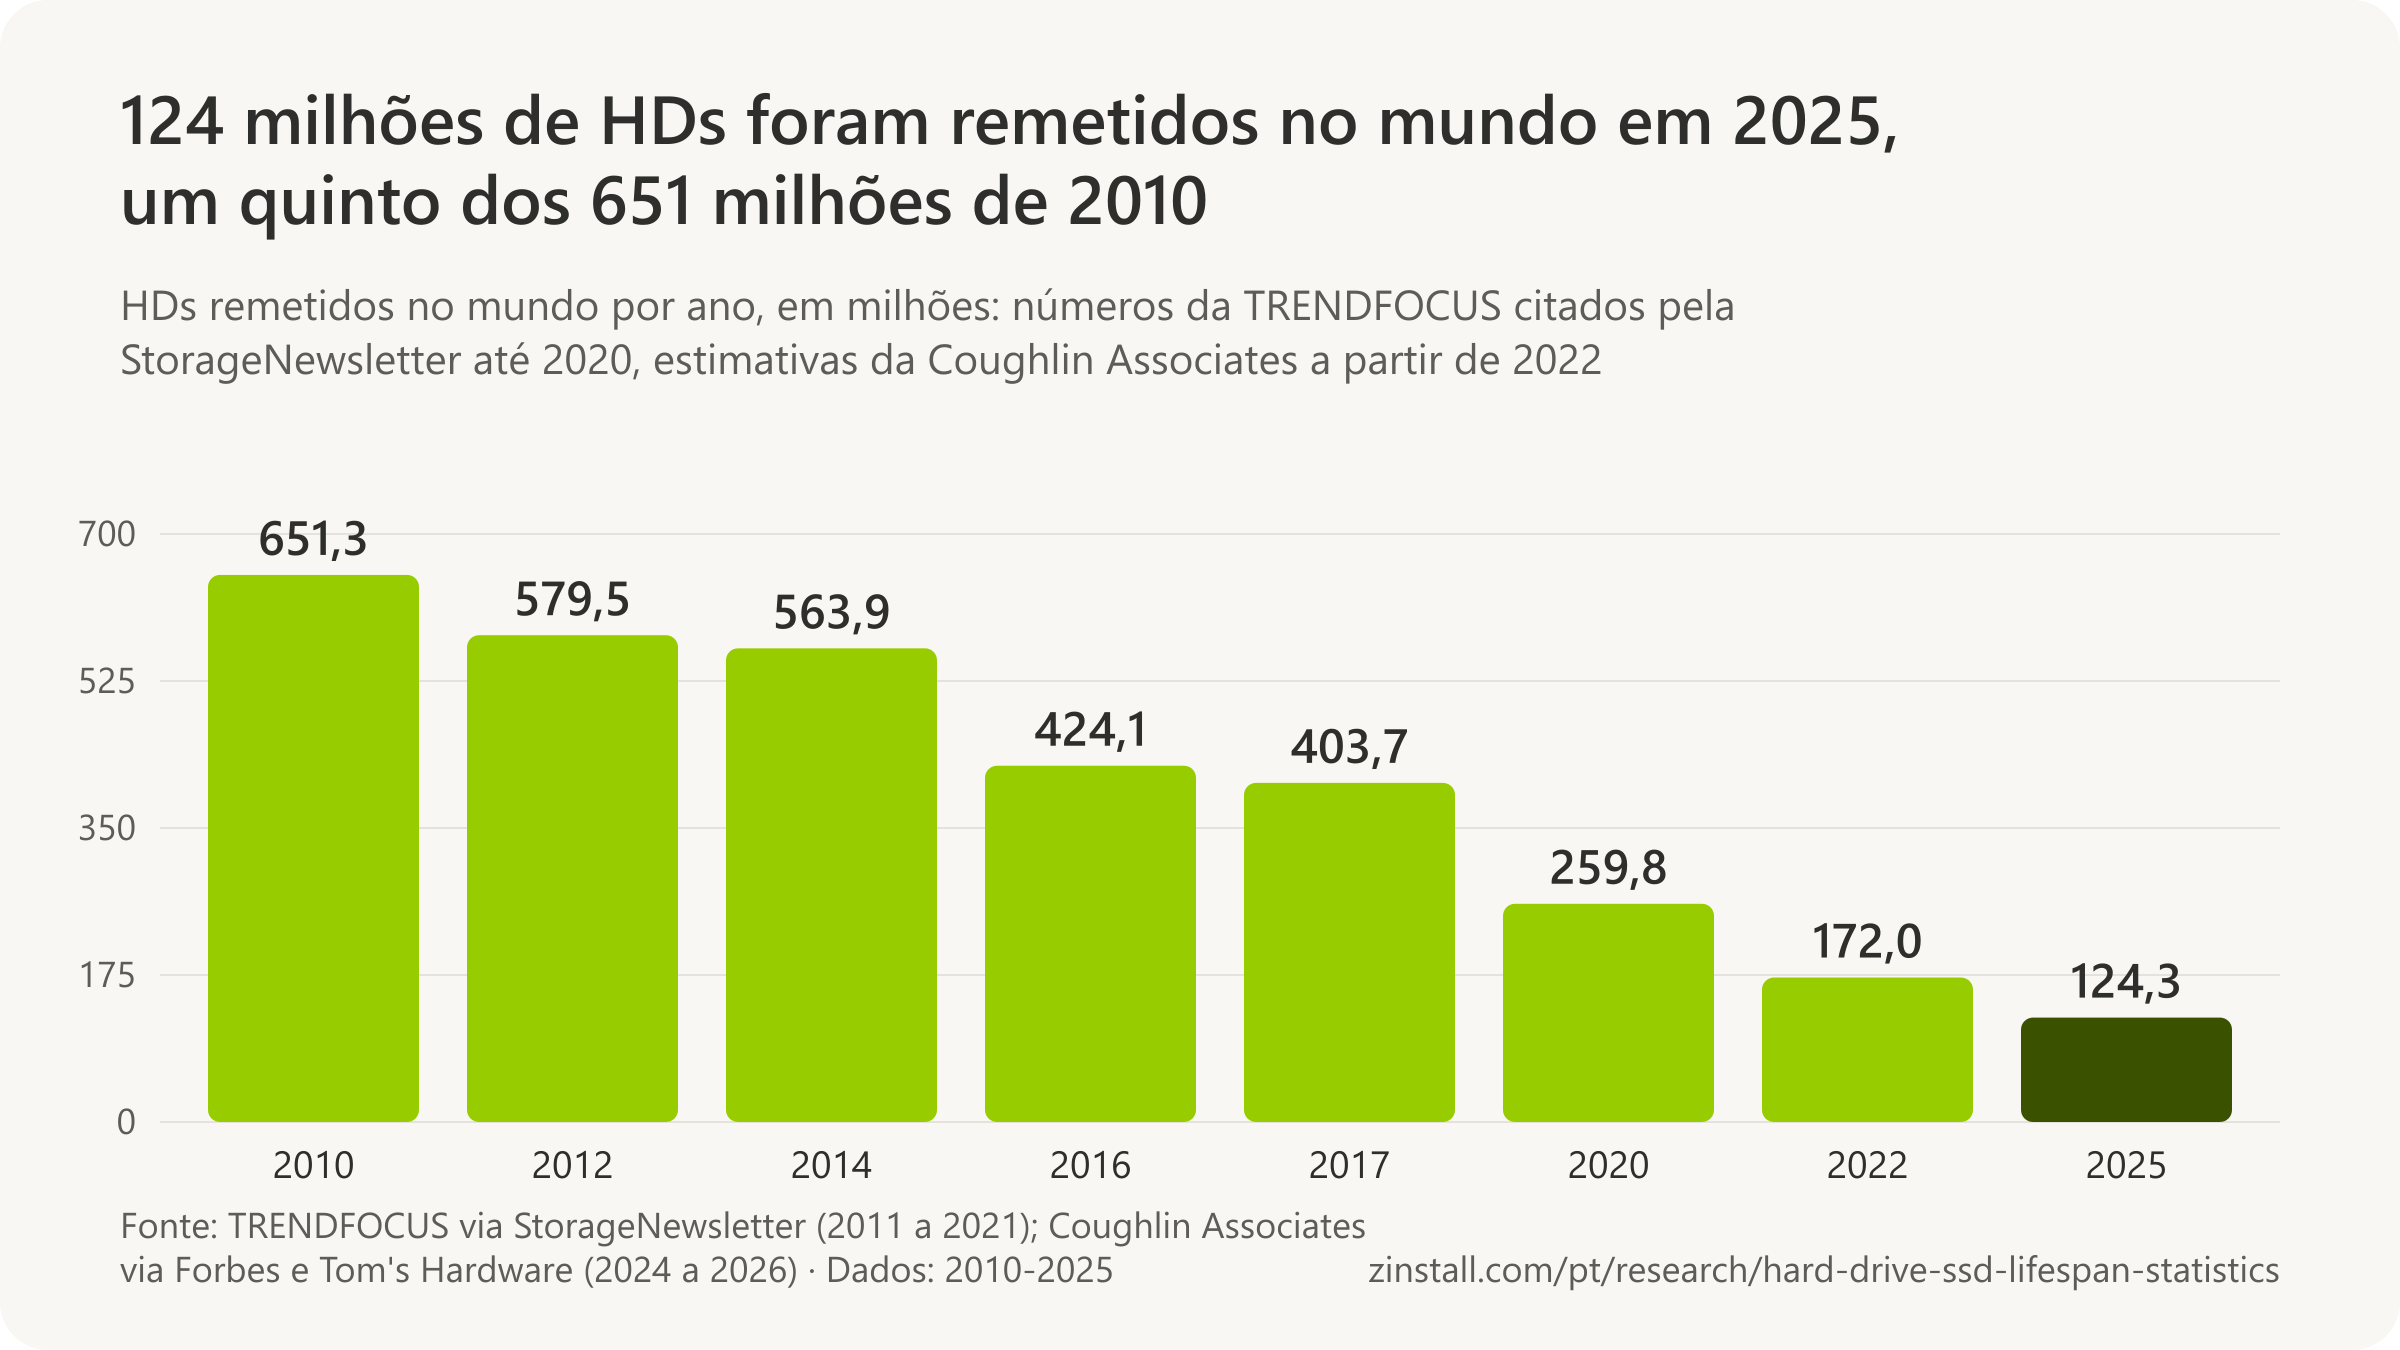
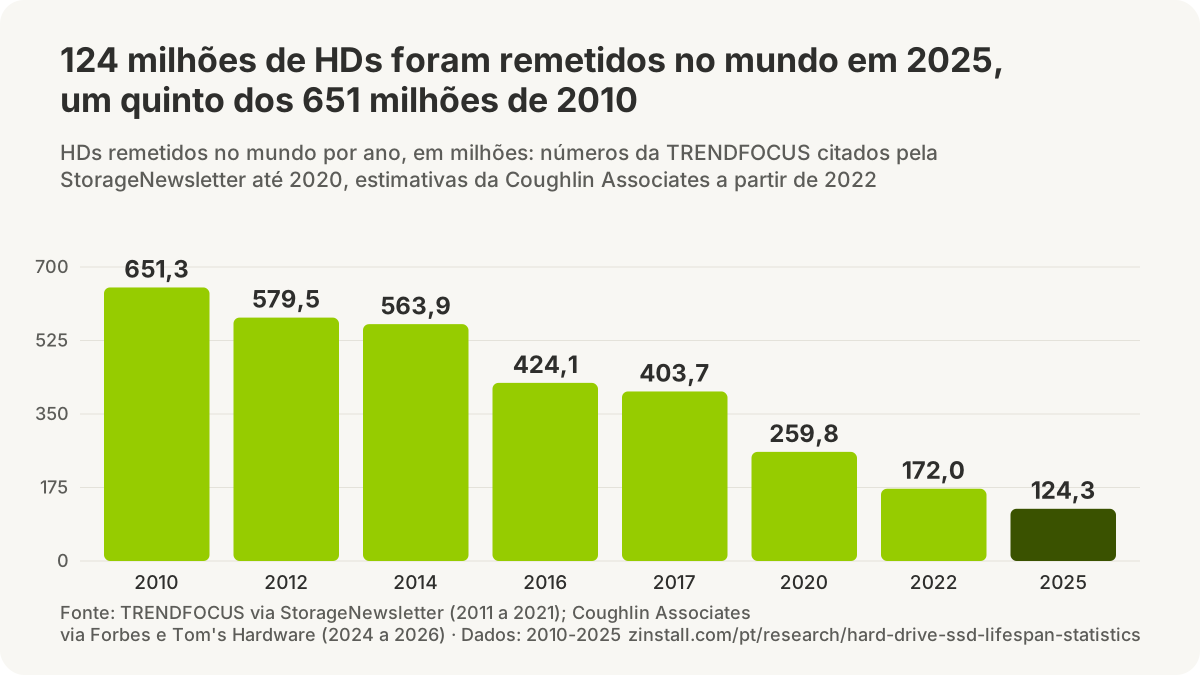
- As remessas de SSDs somaram 333 milhões em 2020, contra 260 milhões de HDs, o primeiro ano em que os SSDs venderam mais que eles.
- 87% dos dados armazenados em grandes data centers ficam em HDs.
- 85% dos PCs de consumo guardavam tudo apenas num HD numa amostra de 2019, a última contagem desse tipo.
- Os prazos de entrega dos HDs de data center passaram de 52 semanas em 2025, com a demanda de armazenamento para IA superando a oferta.
| Medida e data | Número |
|---|---|
| HDs de data center (nearline) remetidos, 2025 | 80,8 milhões |
| Capacidade de HDs remetida, 2025 | 1,62 ZB |
| Fabricantes de HD que restaram depois de 2012 | 3 |
| Preço do HD por gigabyte, 2025 | US$ 0,015-0,016 por GB |
| Preços contratuais de wafers de flash, novembro de 2025 | 20% a mais de 60% |
| Preços dos PCs em 2026 em relação a 2025 (previsão) | +17% (previsão) |
| PCs da pesquisa do Steam com mais de 1 TB de armazenamento, outubro de 2026 | 48,6% |
| Capacidade de montagem de HDs paralisada pelas enchentes de 2011 na Tailândia | cerca de 45% |
| Preço médio por unidade da Seagate depois das enchentes, ano fiscal de 2012 | US$ 66 (antes US$ 54) |
| HDs de marca (na maioria externos) remetidos, 4º trim. 2014 | cerca de 17 milhões |
Fontes: Forbes; StorageNewsletter (2013-2022); Seagate Technology (2025, 2013, 2012); Avast; TrendForce (2025a, 2025b, 2025c); Gartner, Inc.; Valve; Western Digital Corporation; Tom's Hardware
Guias relacionados: Um PC novo com SSD · Clonar ou transferir
Mais estatísticas (53)
Os HDs saíram da maioria dos PCs: os SSDs venderam mais que eles a partir de 2020 e estão em quase todo notebook novo. Mas os HDs ainda guardam a maior parte dos dados do mundo, porque os data centers os compram pela capacidade, e os exabytes remetidos continuam subindo enquanto o número de unidades vendidas cai. Restam três fabricantes. Em 2025 e 2026, a demanda por armazenamento para IA pressionou a oferta tanto de HDs quanto de flash, e os preços subiram.
Remessas de HDs

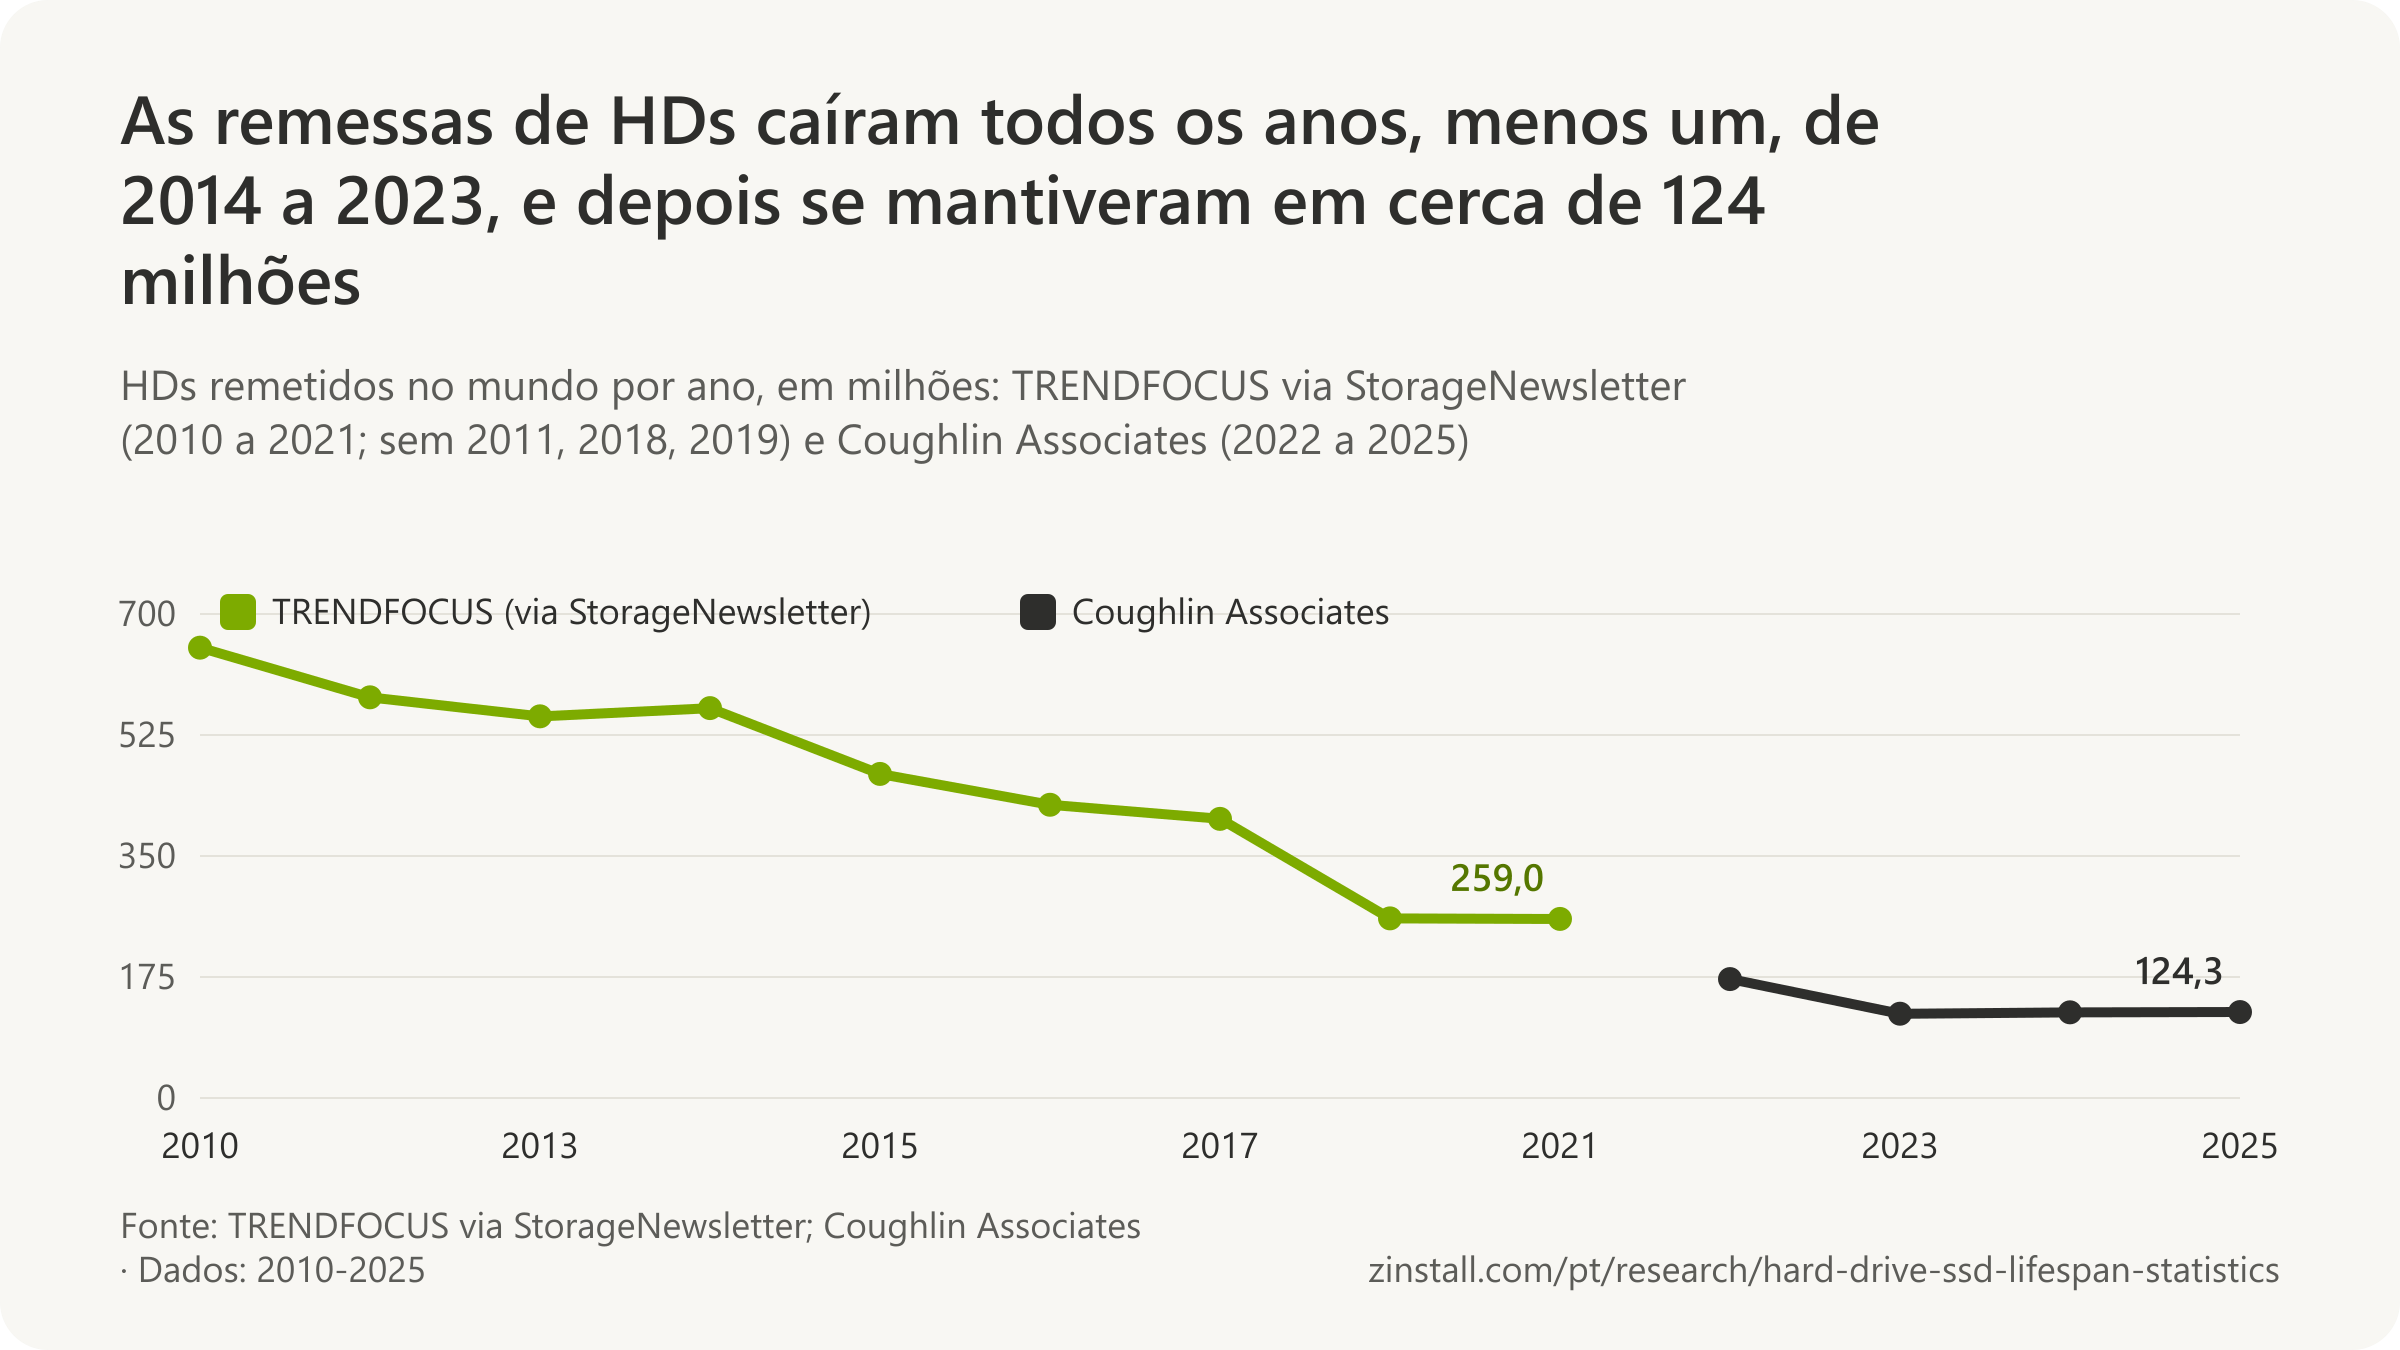
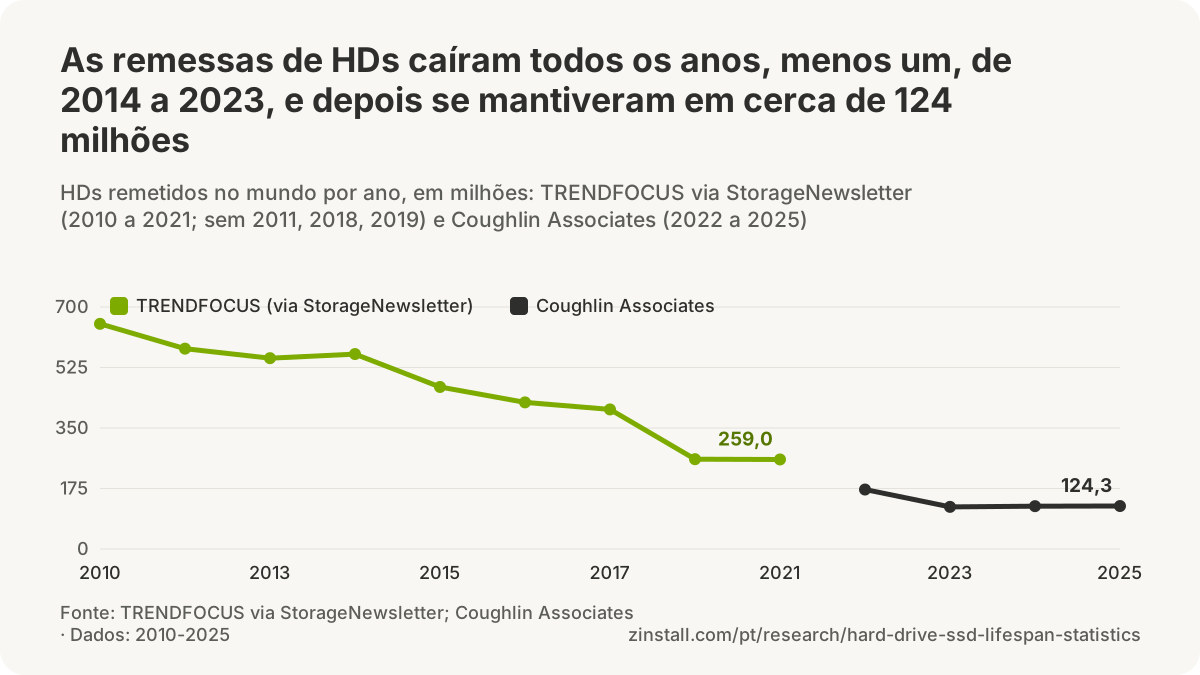

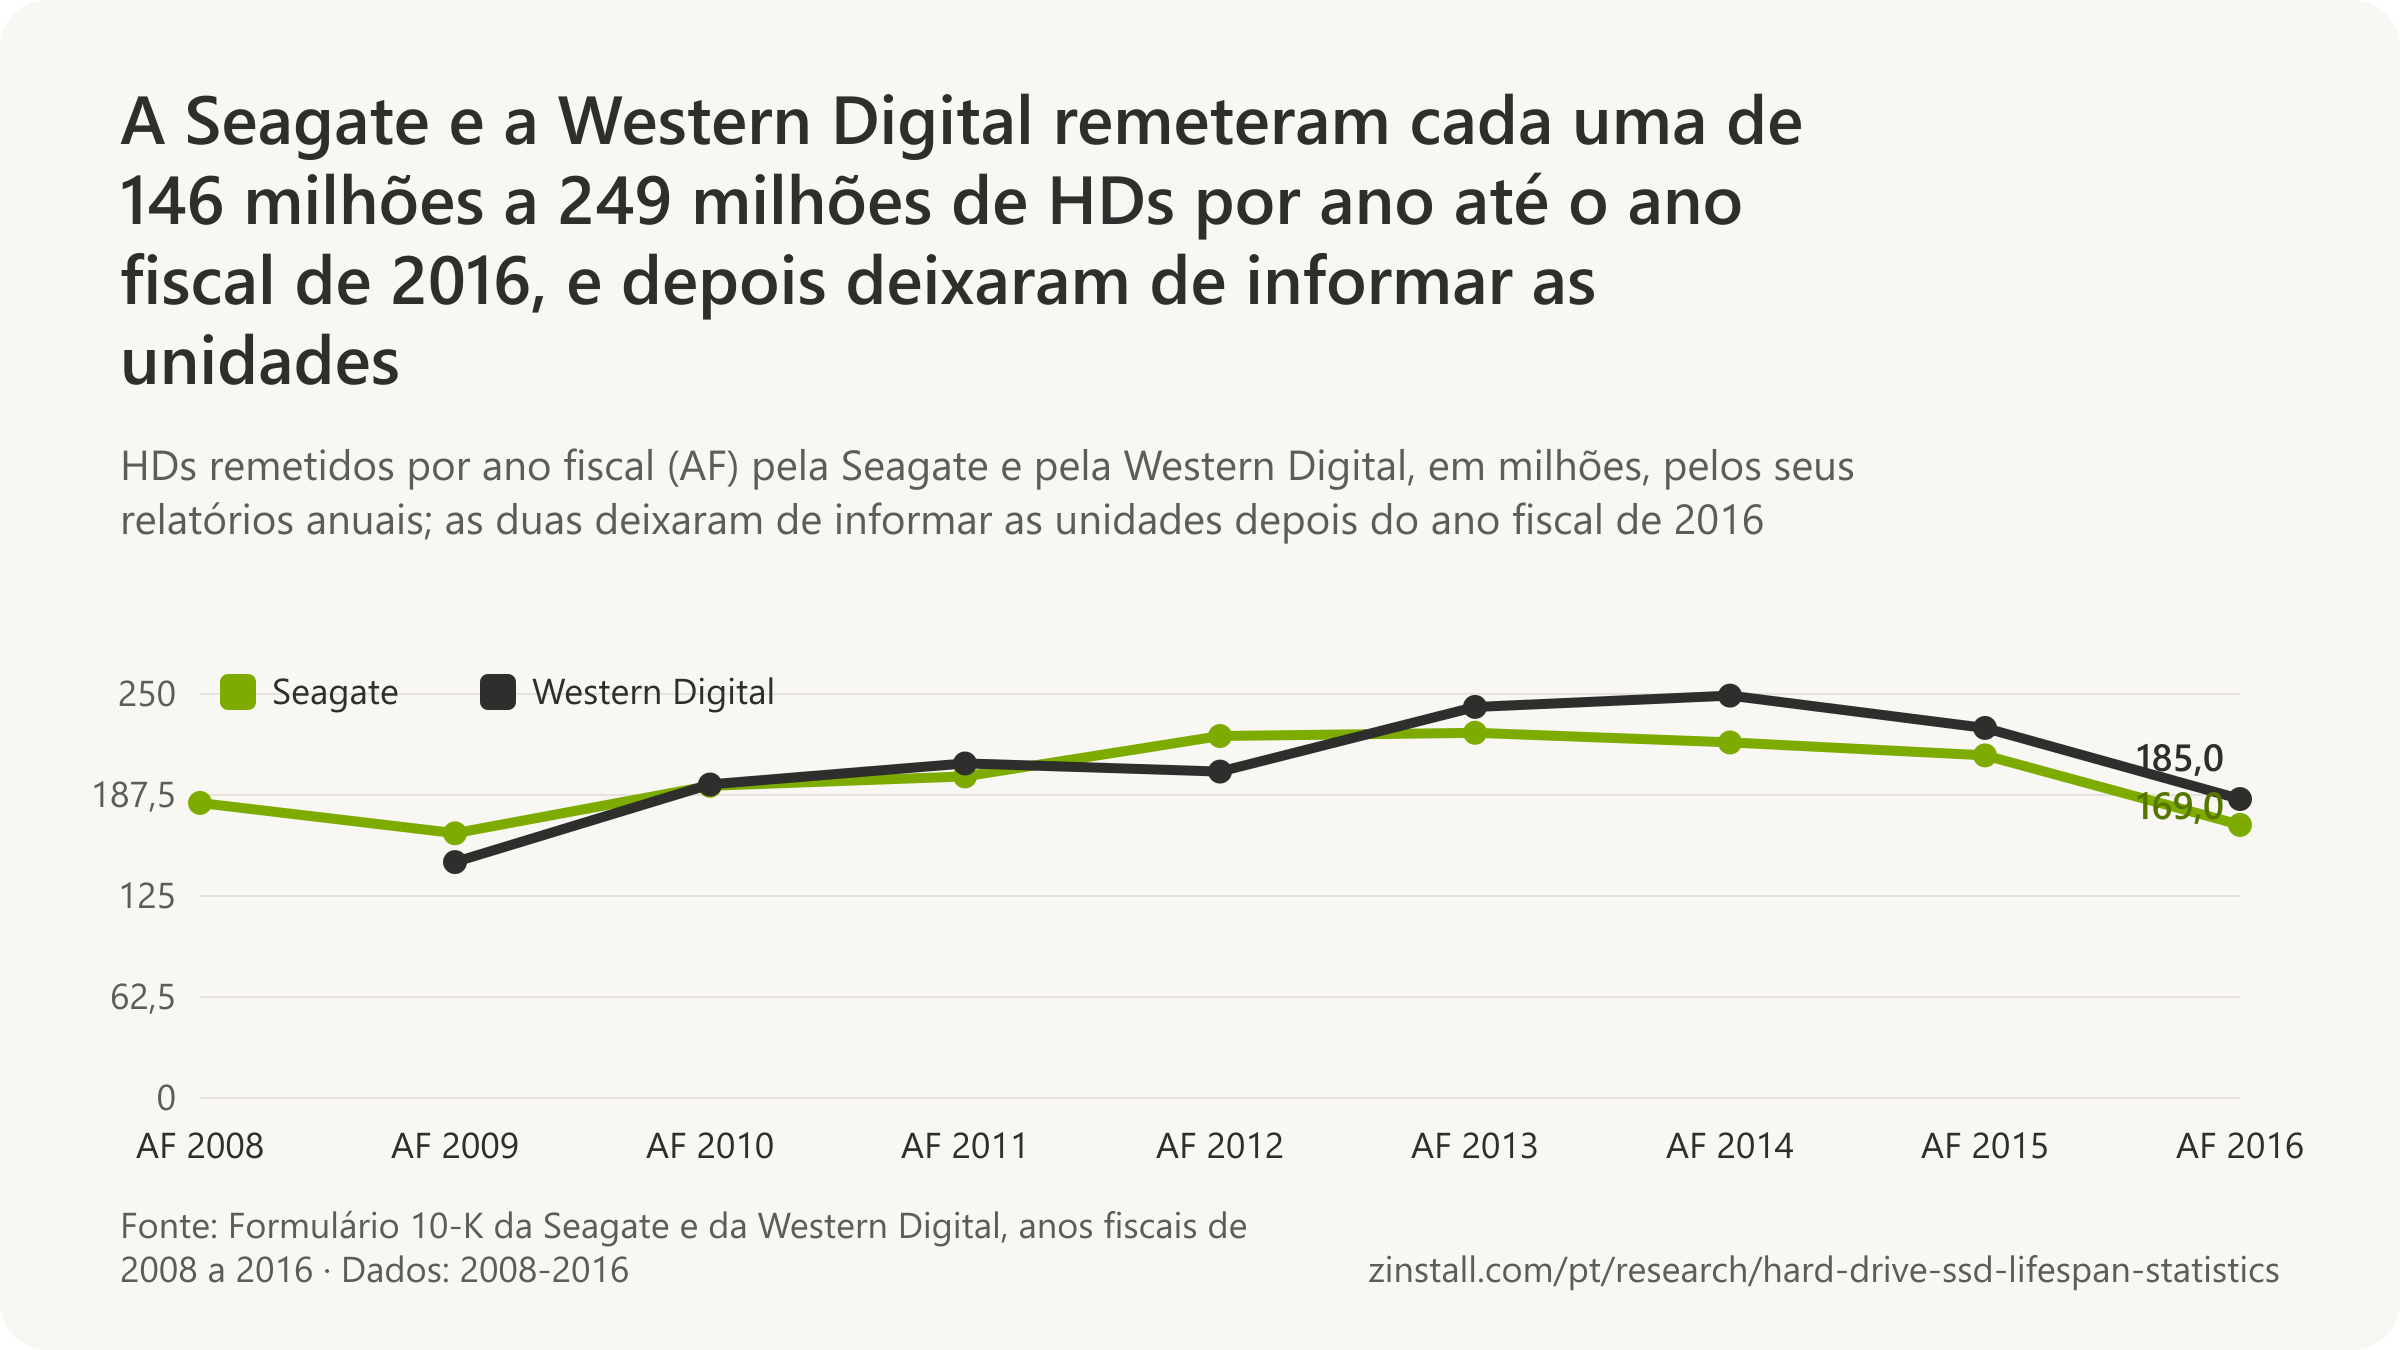
- As remessas mundiais de SSDs somaram 333 milhões em 2020, contra 260 milhões de HDs, o primeiro ano em que os SSDs venderam mais que os HDs (números da TRENDFOCUS citados pela StorageNewsletter, 2021).
- As remessas mundiais de SSDs somaram 373 milhões em 2021, alta de 12% sobre 2020, contra 259 milhões de HDs (números da TRENDFOCUS citados pela StorageNewsletter, 2022).
- As remessas mundiais de SSDs somaram 333 milhões em 2022, queda de 11% sobre 2021 (números da TRENDFOCUS citados pela StorageNewsletter, 2023).
- 80,8 milhões dos HDs remetidos no mundo em 2025 eram unidades nearline para data centers, cerca de dois em cada três de todos os HDs remetidos, uma alta de 13,6% em um ano (estimativa da Coughlin Associates, 2026).
- 2012 foi o ano de pico da receita do setor de HDs, e 2010 o das remessas em unidades, uma diferença que o Tom's Hardware associa às enchentes de 2011 na Tailândia, que causaram falta de unidades (números da Coughlin Associates citados pelo Tom's Hardware, 2024).
- Foram remetidos no mundo 33,4% menos HDs e 14,5% menos capacidade em HDs em 2022 do que em 2021, com a maior queda nas unidades de data center (nearline) (estimativa da Coughlin Associates, 2023).
- Cerca de 45% da capacidade de montagem do setor de HDs foi paralisada pelas enchentes na Tailândia de meados de outubro de 2011 a fevereiro de 2012, e os volumes do setor em unidades caíram 5% em 2011, pela estimativa da Western Digital (formulário 10-K da Western Digital, 2012).
- Três empresas ainda fabricam HDs, Seagate, Western Digital e Toshiba, depois da consolidação de 2012, em que a Seagate assumiu o negócio de unidades da Samsung e a Western Digital comprou a Hitachi GST (formulário 10-K da Seagate, 2013).
- As remessas mundiais de HDs de desktop e de notebook (client) somaram 420 milhões em 2013: 251,6 milhões de unidades móveis de 2,5 polegadas e 168,7 milhões de unidades de desktop (números da TRENDFOCUS citados pela StorageNewsletter, 2014).
- As remessas mundiais de HDs de desktop e de notebook (client) somaram 268 milhões em 2016, com as unidades móveis em queda de 12% por causa do avanço dos SSDs, sobretudo nos notebooks corporativos (números da TRENDFOCUS citados pela StorageNewsletter, 2017).
- 139 milhões de HDs de desktop e de notebook (client) ainda foram remetidos no mundo em 2020, um terço do número de 2013, enquanto as unidades corporativas ficaram com 64% da capacidade remetida (números da TRENDFOCUS citados pela StorageNewsletter, 2021).
- Cerca de 17 milhões de HDs de marca (varejo, na maioria externos) foram remetidos no mundo no quarto trimestre de 2014 pelos três fabricantes: Western Digital 7,16 milhões, Seagate 5,95 milhões e Toshiba 3,82 milhões (números da TRENDFOCUS citados pela StorageNewsletter, 2015).

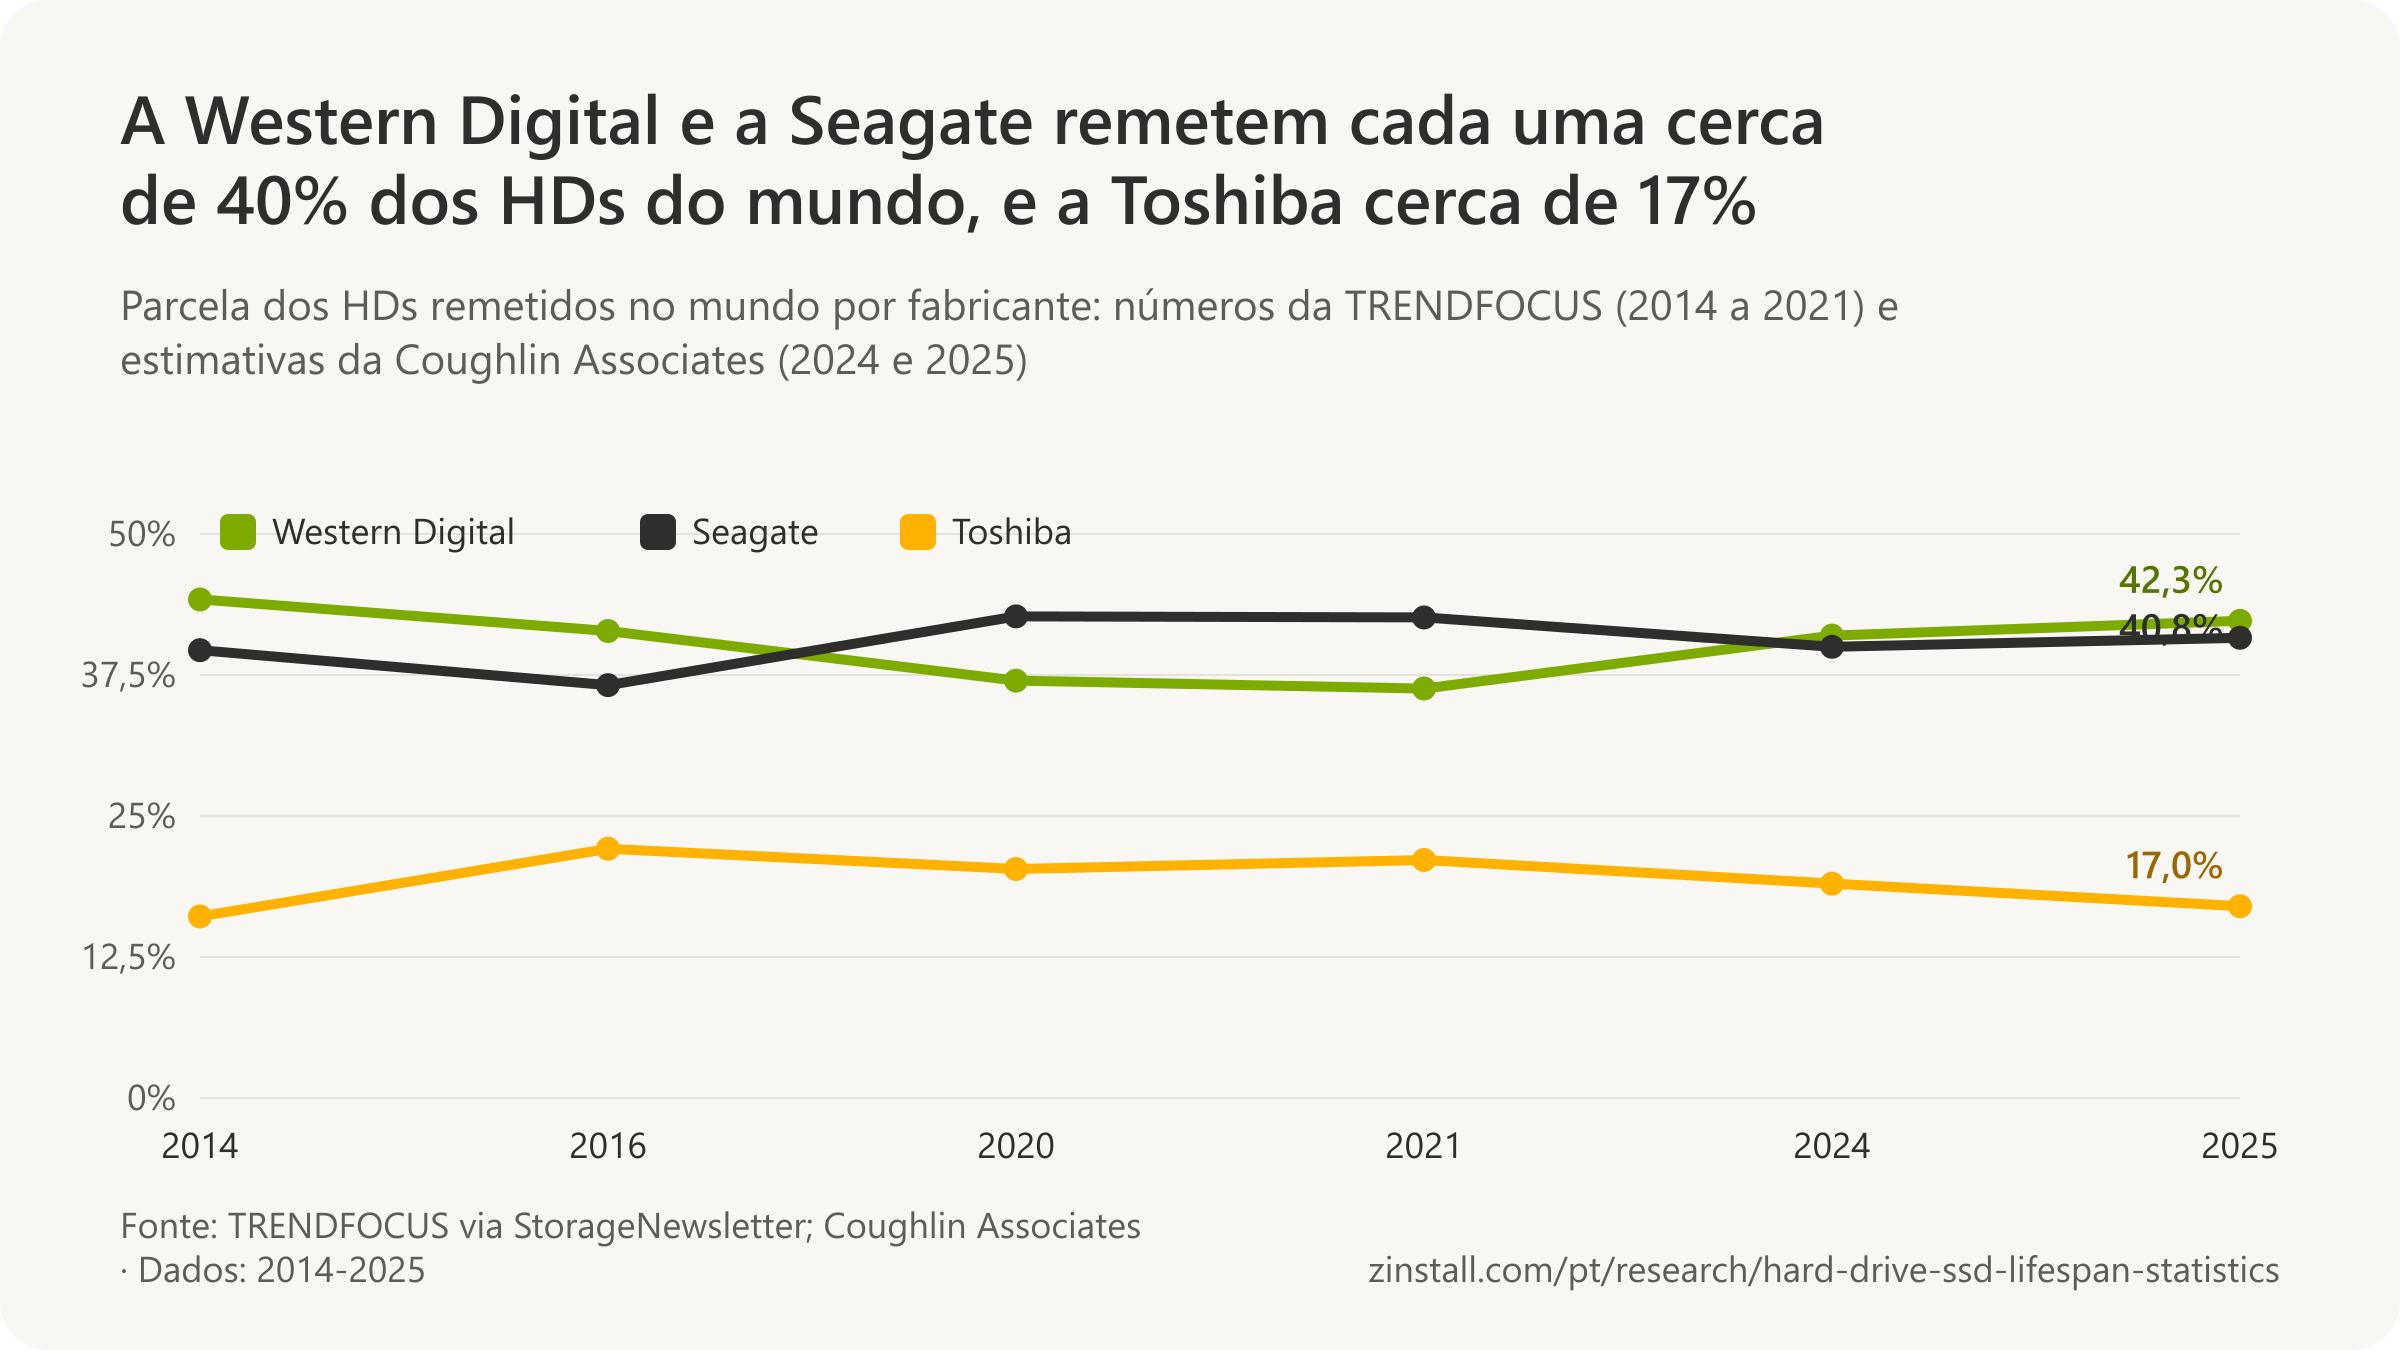
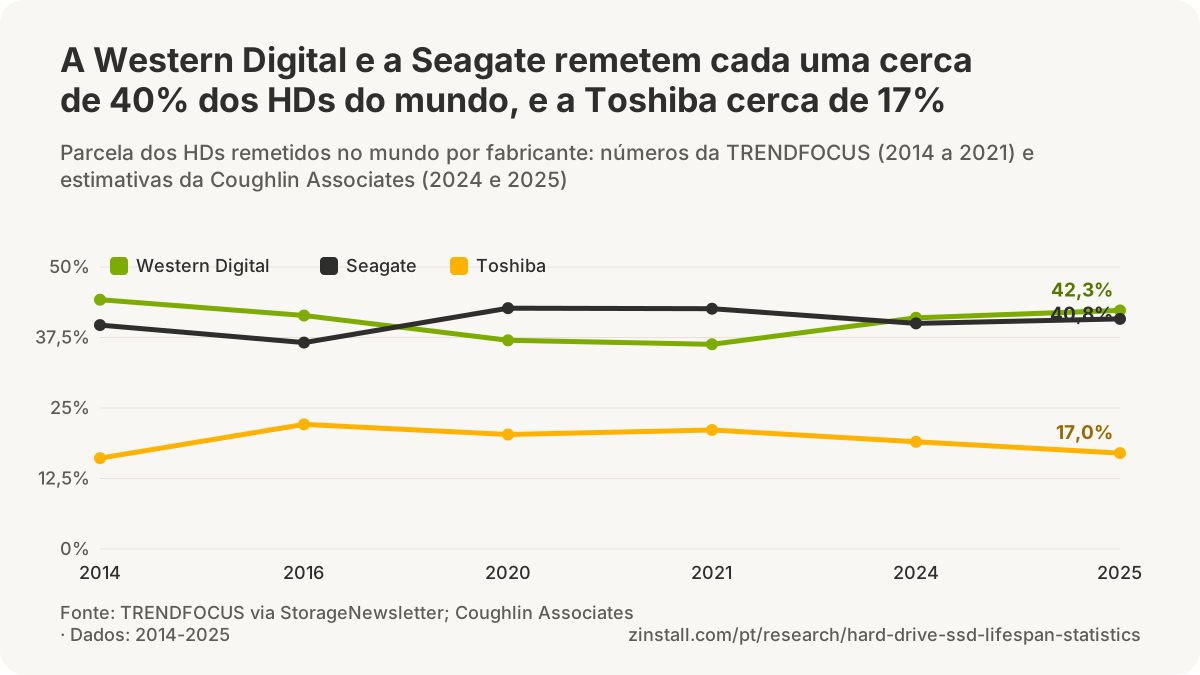
Capacidade remetida

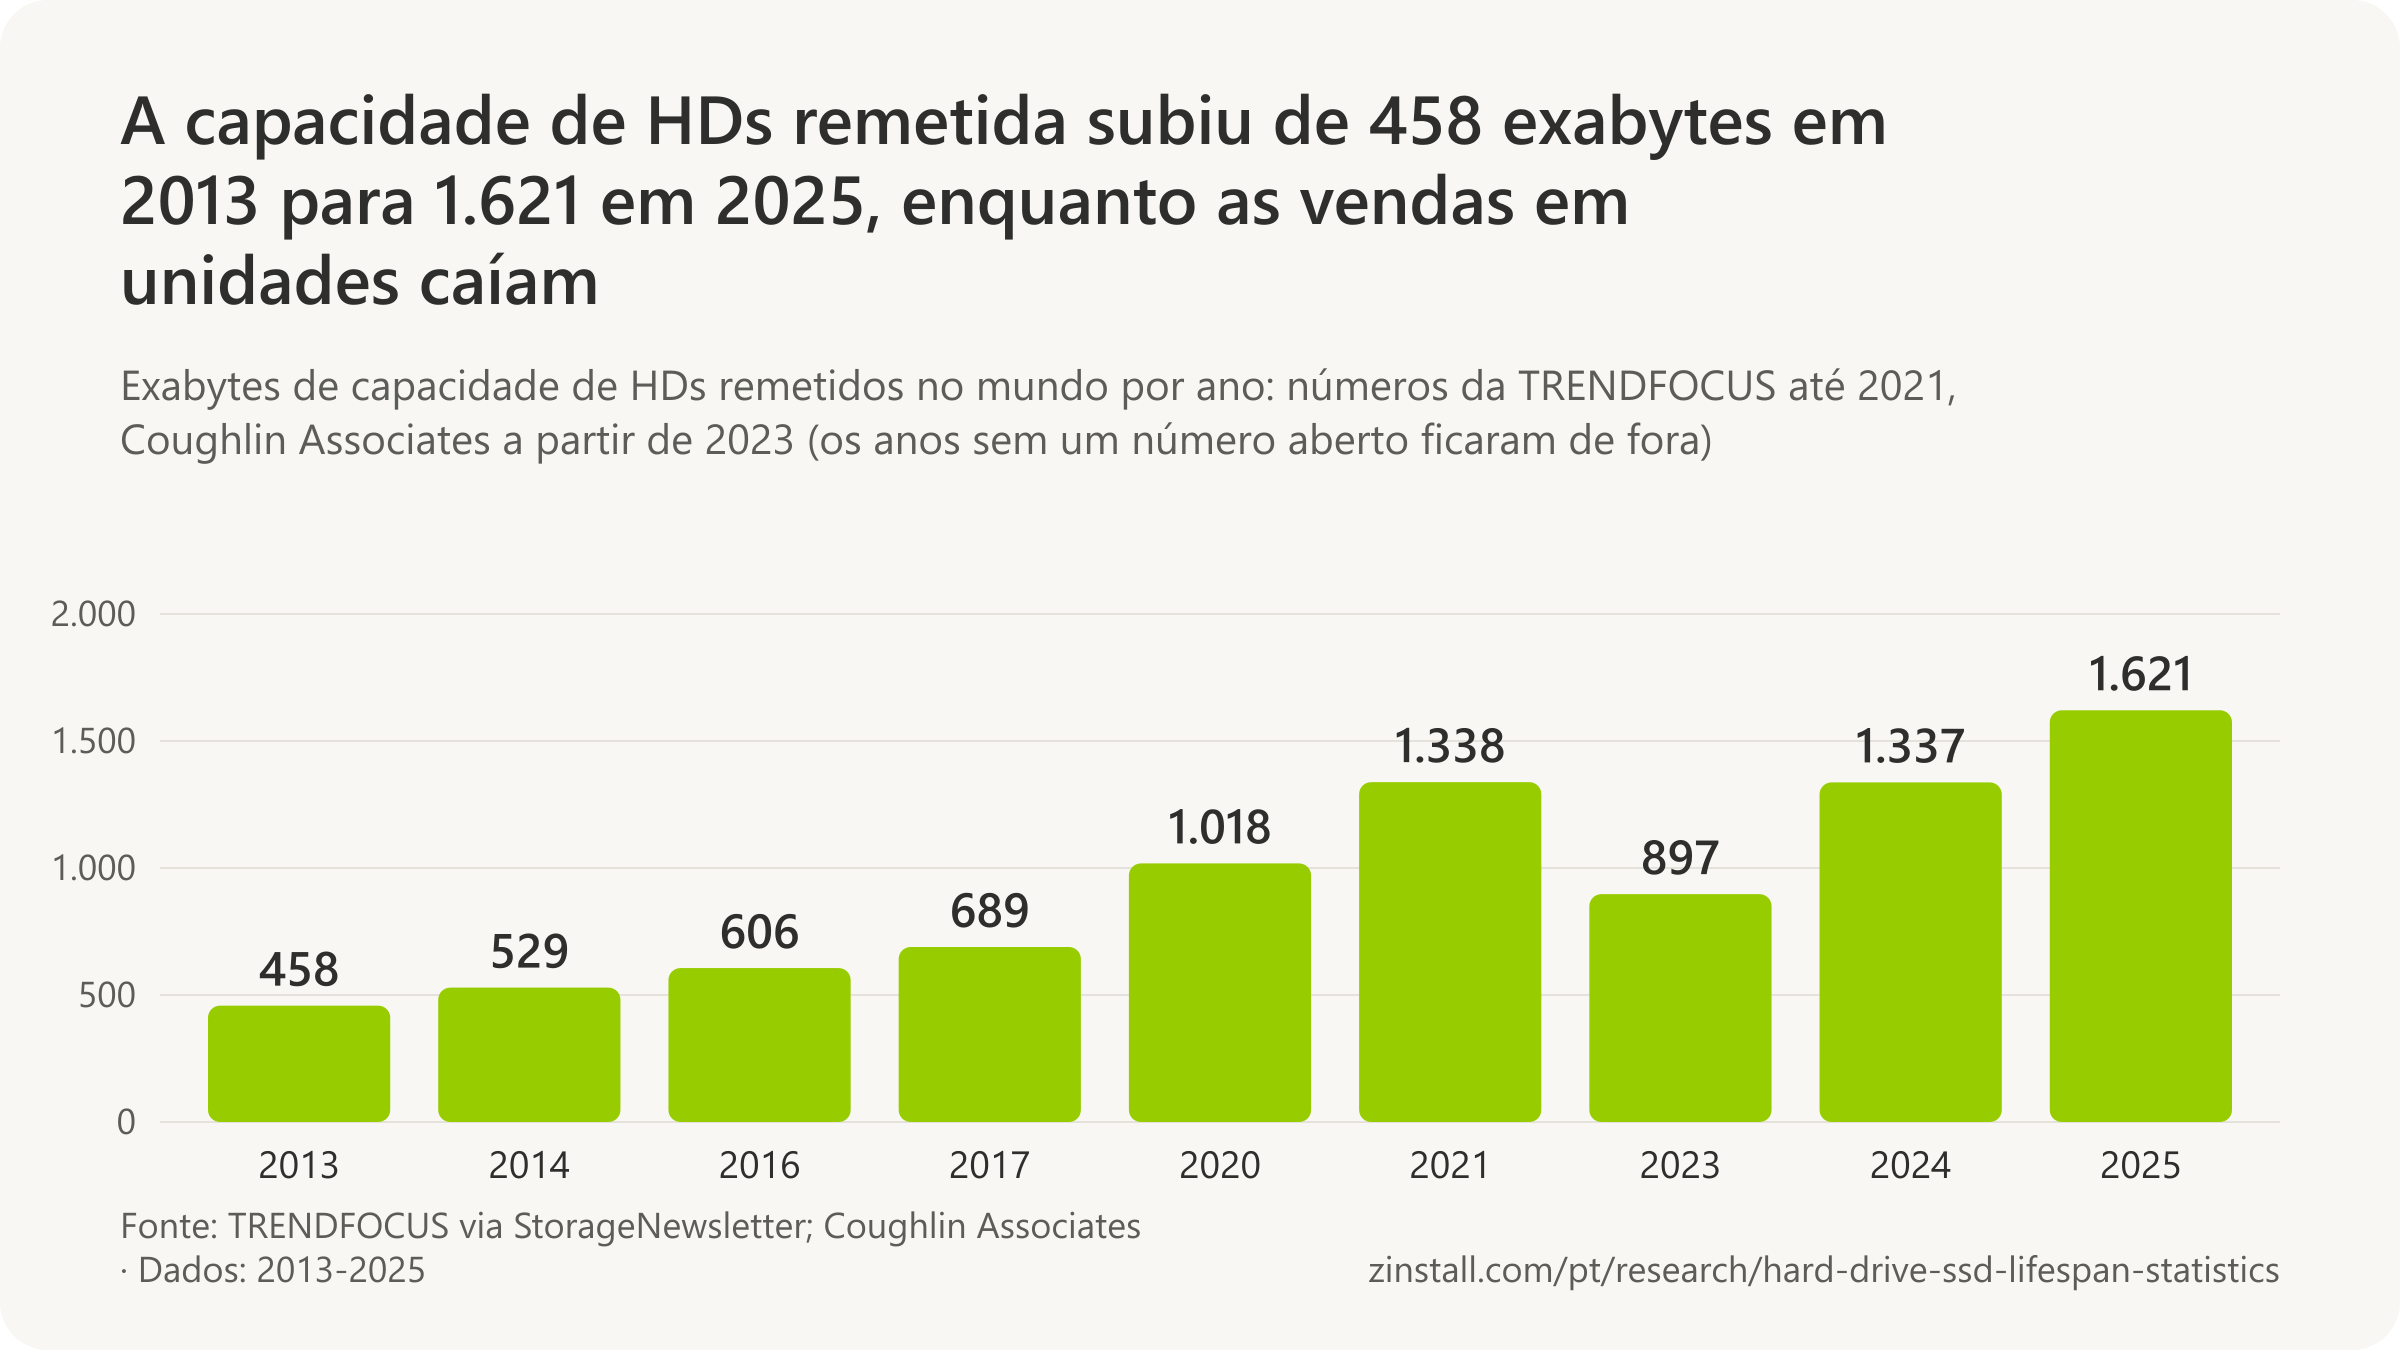

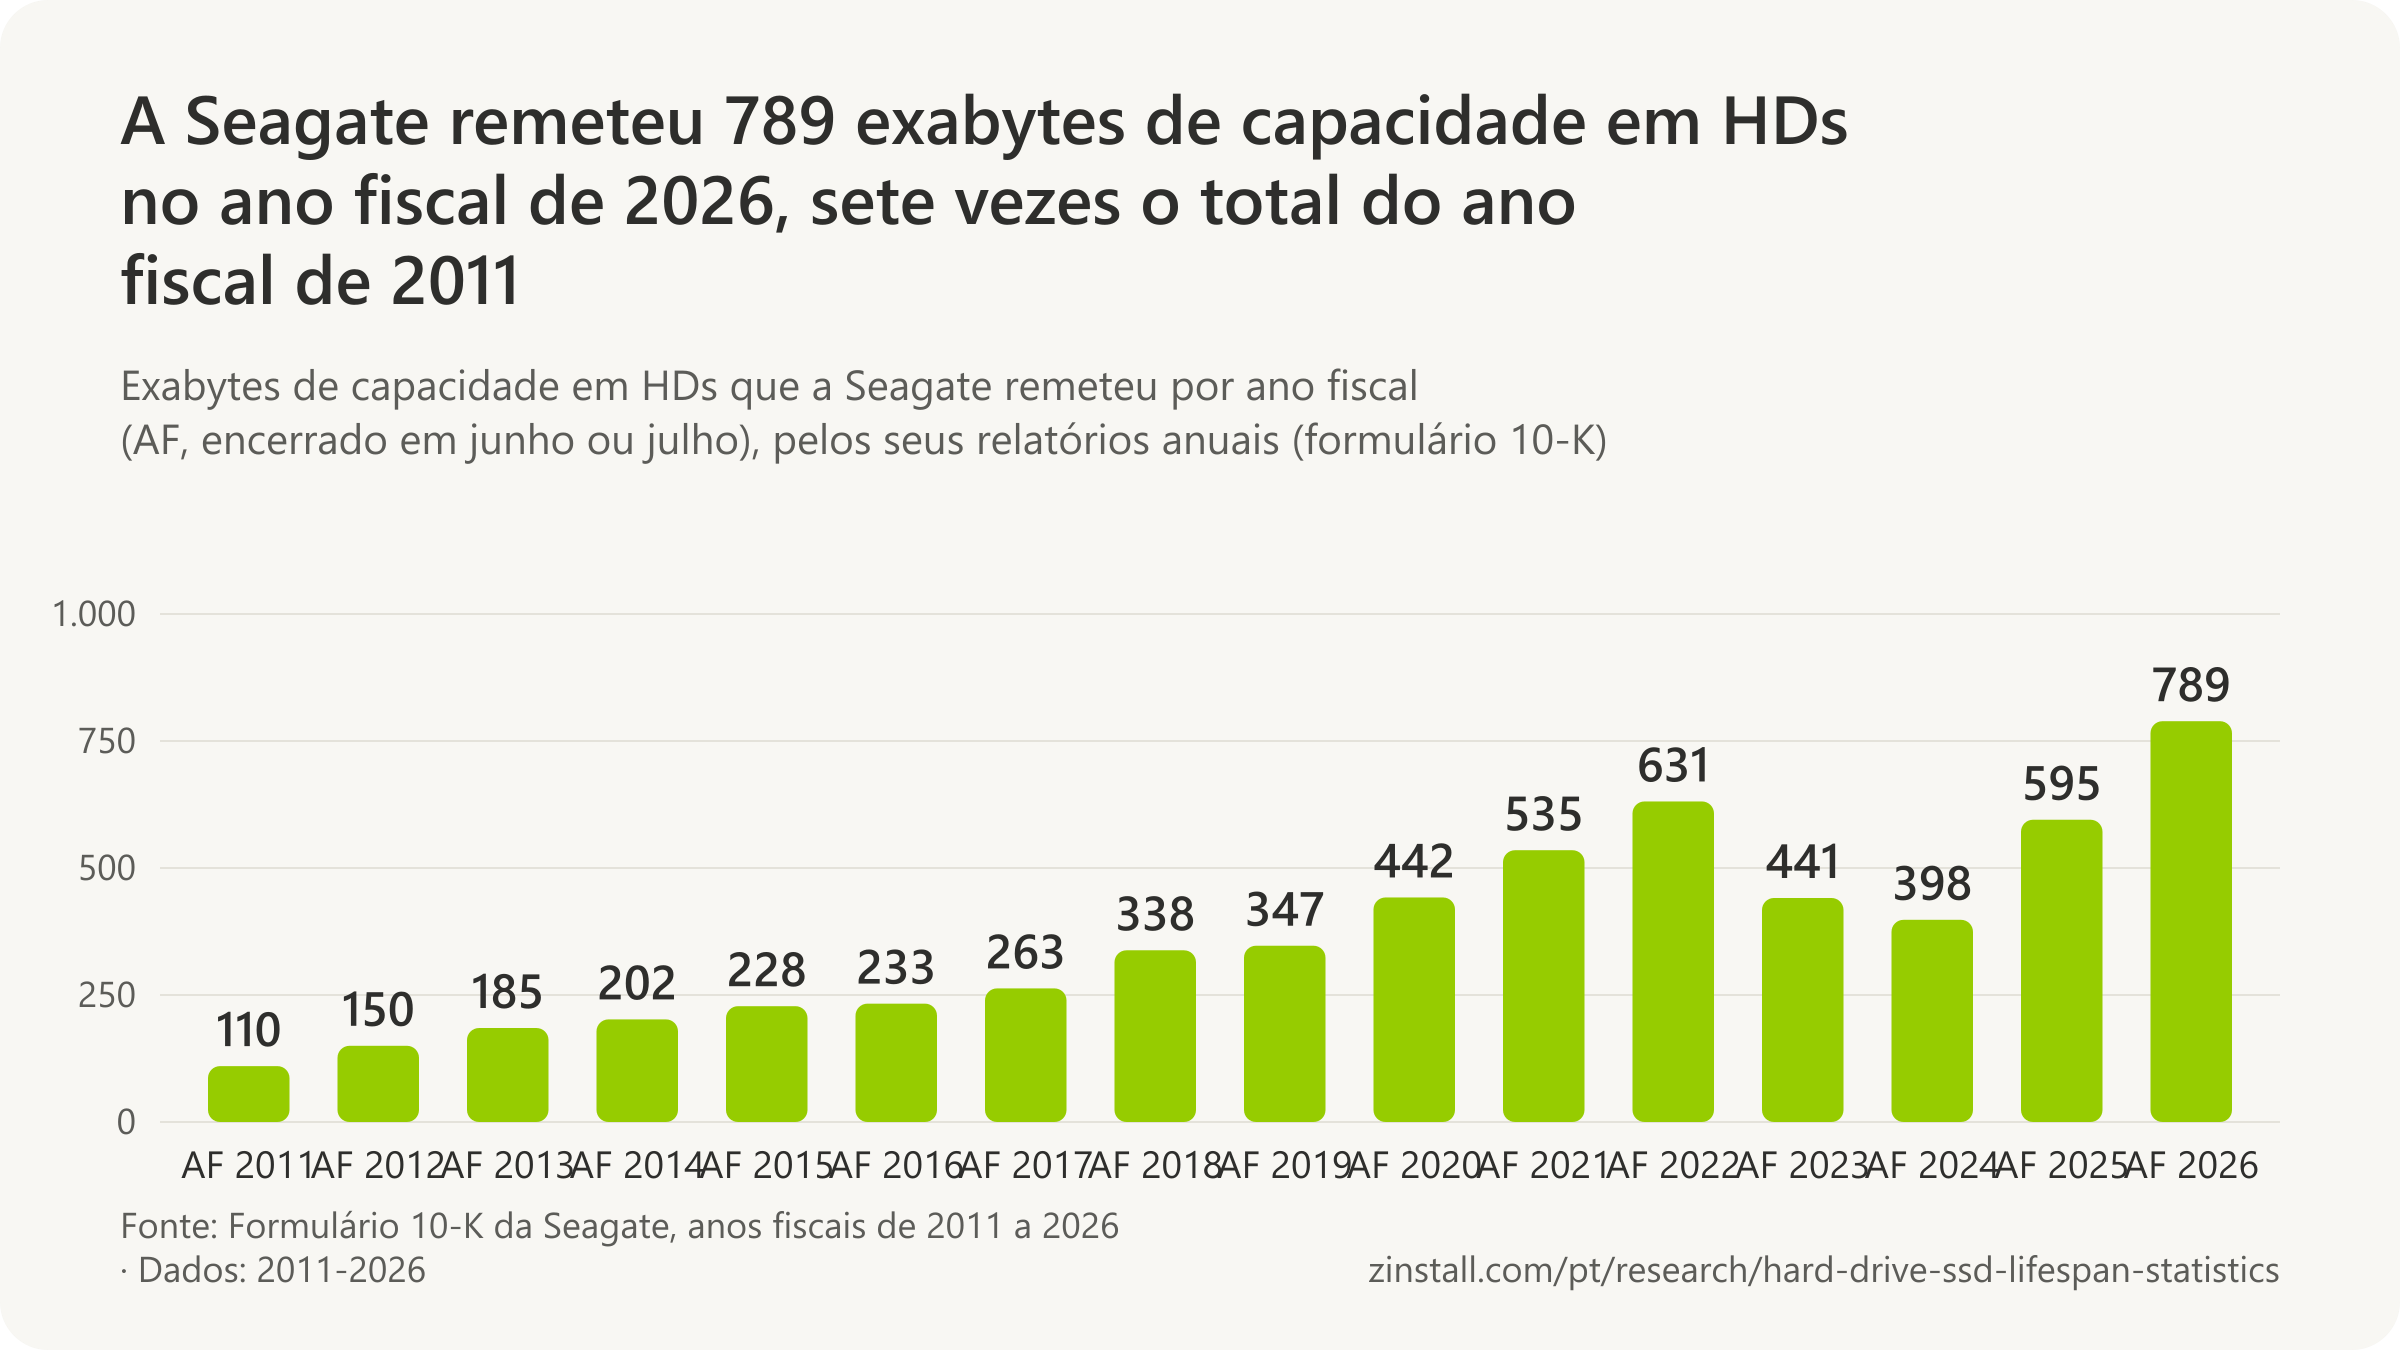
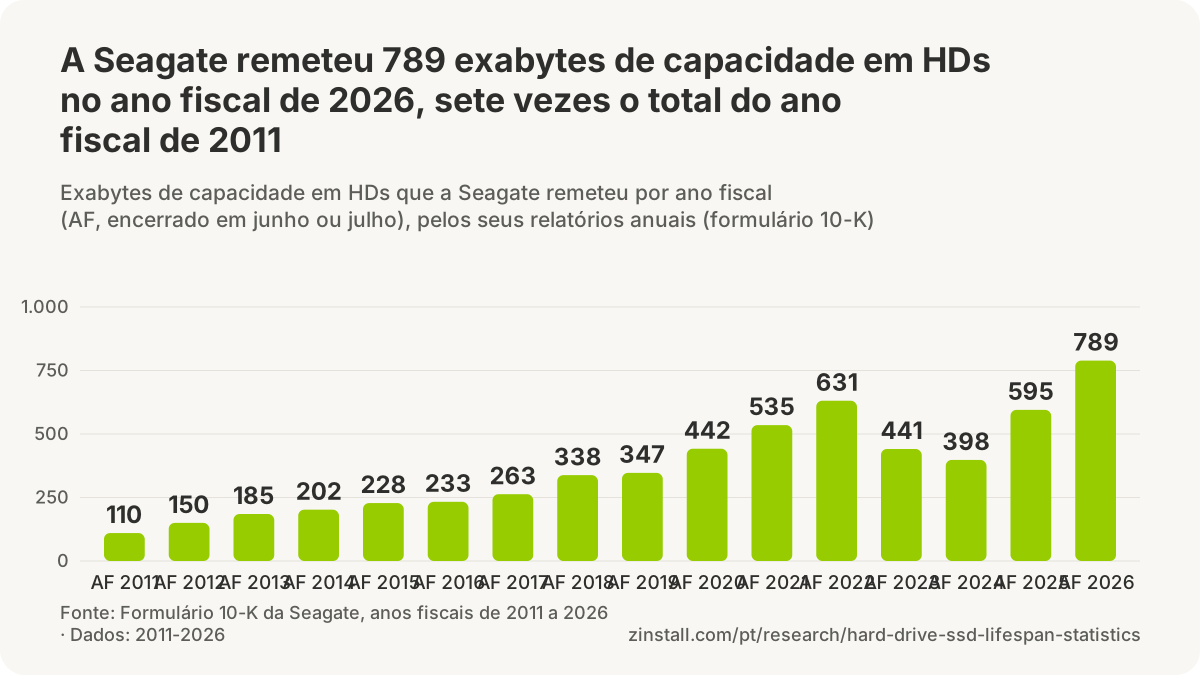

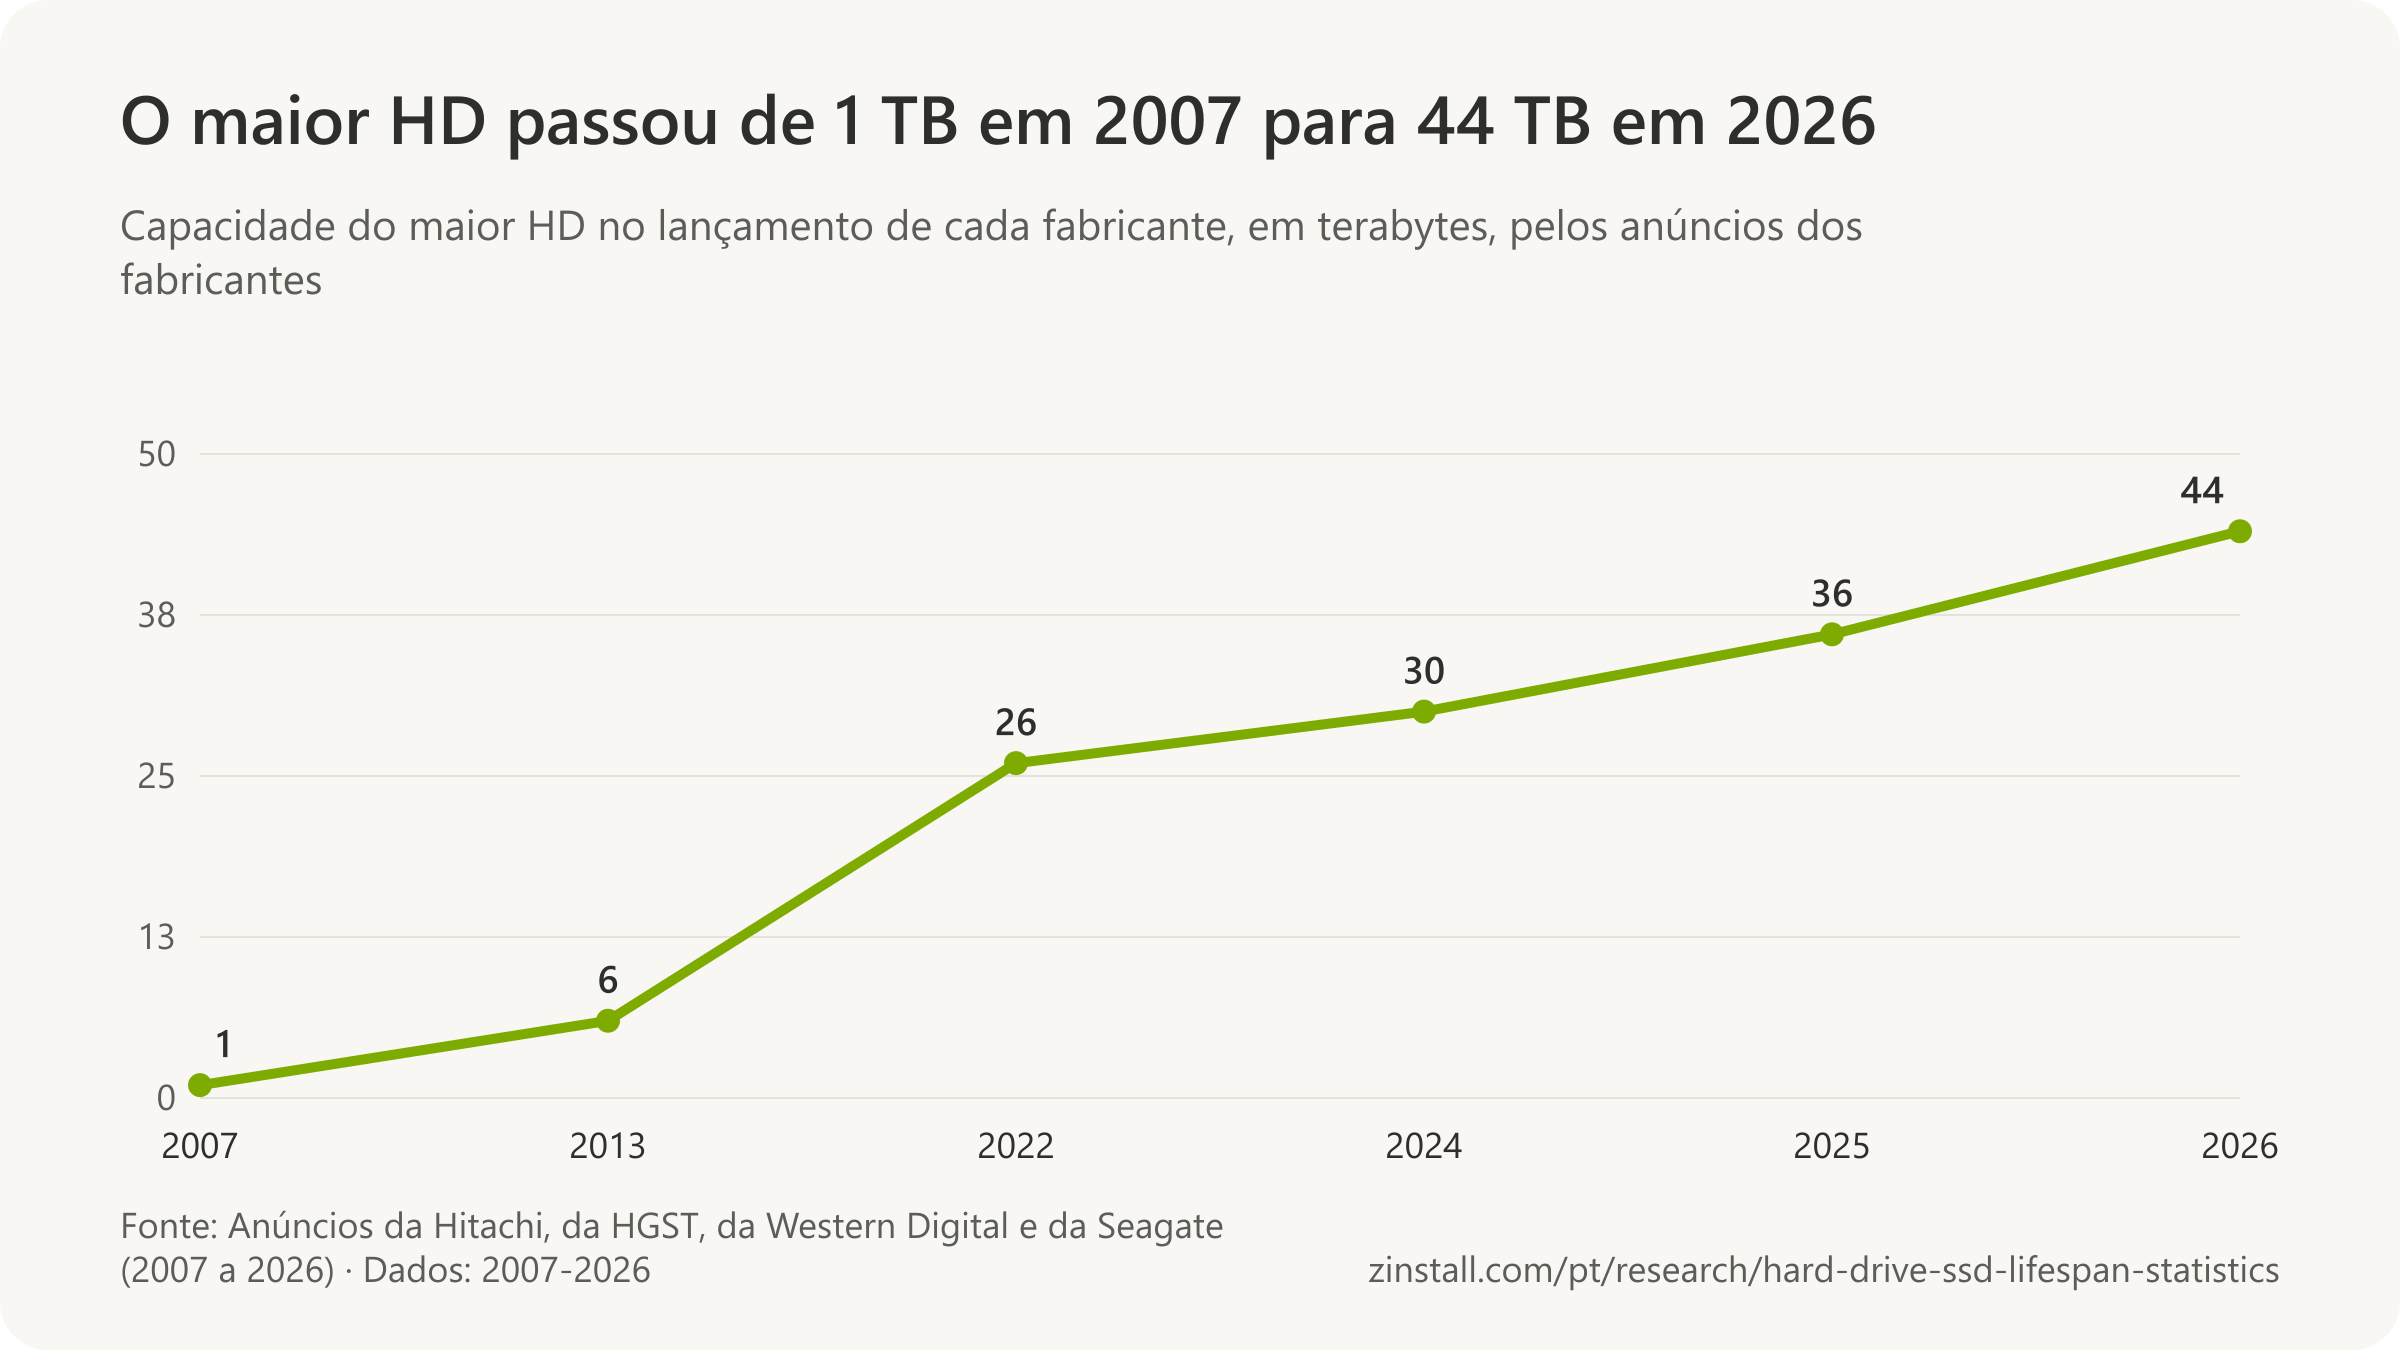
- A Western Digital remeteu 696 exabytes de capacidade em HDs no seu ano fiscal de 2025, contra 443 no ano fiscal de 2024 e 412 no de 2023 (formulário 10-K da Western Digital, 2025).
- A Western Digital vendeu 25% mais exabytes de capacidade em HDs no seu ano fiscal de 2026 do que no de 2025, com os clientes de nuvem respondendo por 89% da sua receita (formulário 10-K da Western Digital, 2026).
- 207 exabytes de capacidade em SSDs foram remetidos no mundo em 2020, cerca de um quinto dos 1.018 exabytes remetidos em HDs (números da TRENDFOCUS citados pela StorageNewsletter, 2021).
- 32-33% dos notebooks remetidos no mundo no segundo trimestre de 2016 vieram com SSD em vez de HD (TrendForce, 2016).
- 45% dos notebooks remetidos no mundo em 2017 vieram com SSD, abaixo do esperado porque os preços dos SSDs subiram (TrendForce, 2018).
- Mais da metade dos notebooks remetidos no mundo em 2018 veio com SSD, e a TrendForce esperava 60-65% em 2019 (TrendForce, 2019).
- 92% dos notebooks remetidos no mundo em 2022 deviam vir com SSD, e cerca de 96% em 2023 (projeção da TrendForce, 2022).
- Perto de 100% dos notebooks novos saem com SSD (TrendForce: taxas de adoção “chegando a 100%”), e 101 milhões de SSDs foram vendidos pelos canais de varejo e distribuição em 2024, queda de 14% (TrendForce, 2025).
- 87% dos exabytes armazenados em grandes data centers ficam em HDs, pelo Cloud Infrastructure Index de 2025 da IDC, conforme citado no relatório anual da Seagate (IDC via formulário 10-K da Seagate, 2025).
- 912 exabytes de armazenamento foram remetidos em HDs e SSDs juntos em 2018, mais de 800 deles em HDs, então os SSDs levaram no máximo cerca de um oitavo (TRENDFOCUS, 2019).
- Os SSDs levaram 17% da capacidade de armazenamento remetida em HDs e SSDs em 2020 (207 de 1.226 exabytes), embora tenham vendido mais que os HDs em unidades (números da TRENDFOCUS citados pela StorageNewsletter, 2021).
- A TRENDFOCUS previu em 2018 que os SSDs estariam em mais de 80% dos notebooks e em mais de um terço dos PCs desktop por volta de 2022, com HDs de desktop e móveis ainda sendo remetidos por anos (números da TRENDFOCUS citados pela StorageNewsletter, 2018).
- 284 exabytes de capacidade em SSDs foram remetidos no mundo em 2023, alta de 2% sobre 2022, enquanto toda a flash NAND remetida chegou a 779 exabytes (números da TRENDFOCUS citados pela StorageNewsletter, 2024).
SSDs em PCs

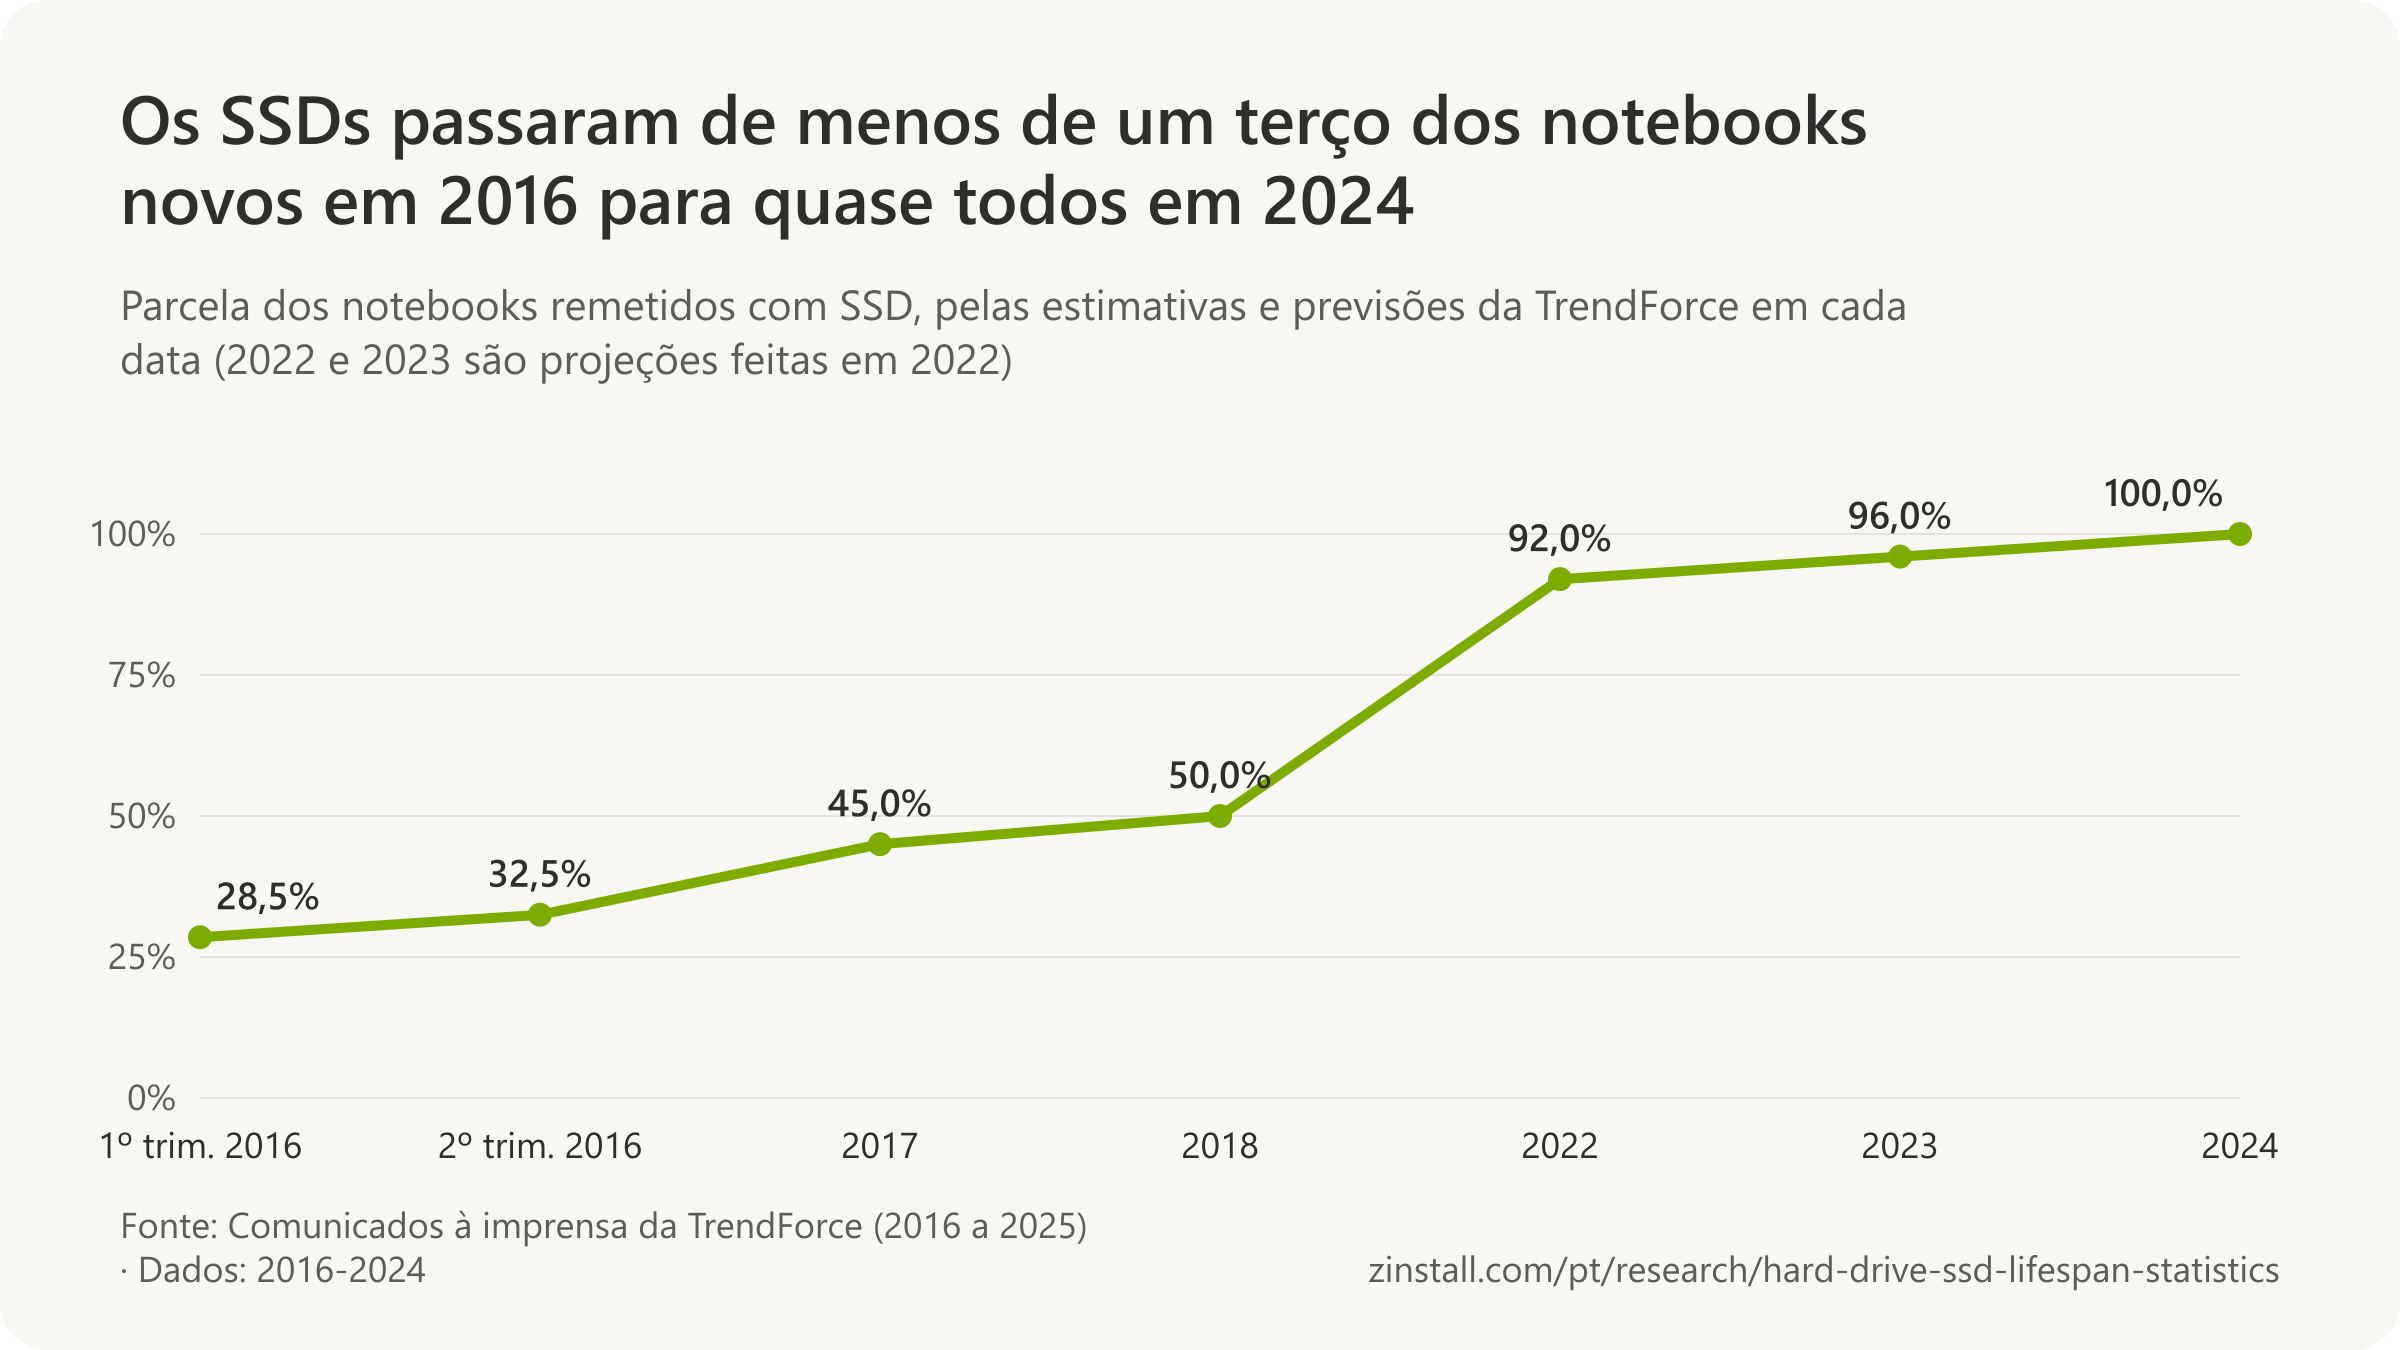
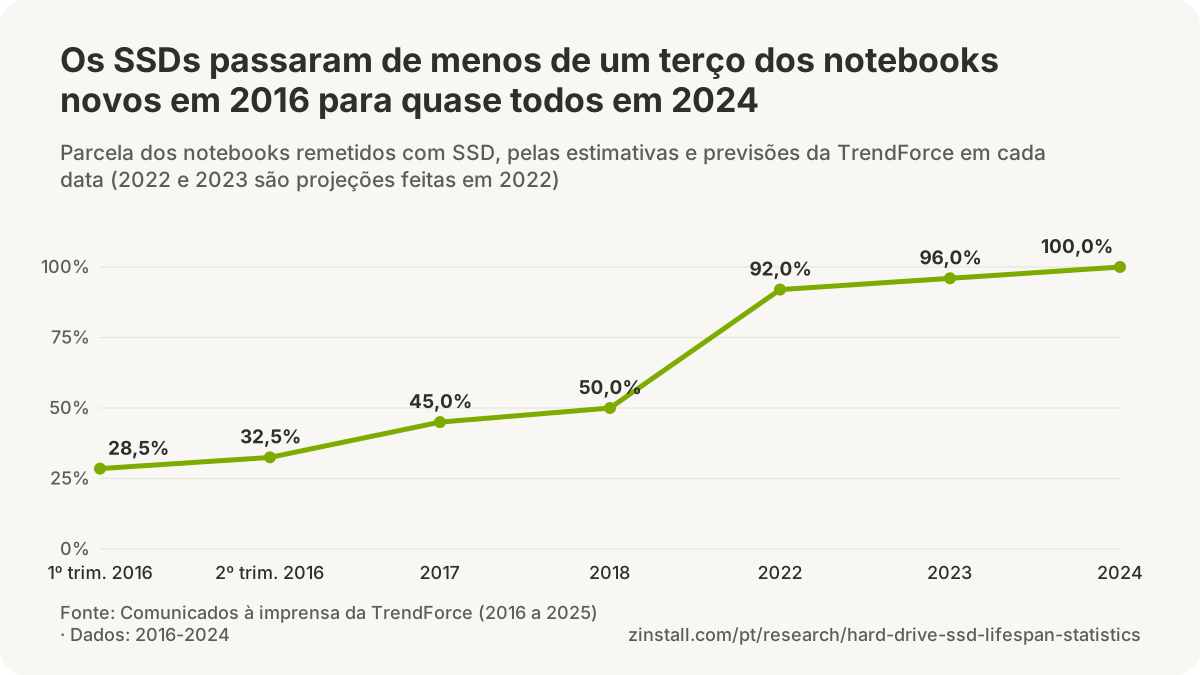
- Os SSDs de 512GB para notebooks tinham cotação perto do preço dos HDs de 512GB no fim de 2022, e o SSD cliente médio tinha mais de 500GB (TrendForce, 2022).
- A TrendForce previu em 2016 que os SSDs de 128GB custariam menos que os HDs de 500GB até o fim daquele ano, e que os SSDs de 256GB custariam menos de US$ 5 a mais que os HDs de 1TB (TrendForce, 2016).
- 85% dos PCs de consumo nos dados PC Trends de 2019 da Avast guardavam tudo apenas num HD; 7,7% tinham só um SSD e 7,4% tinham os dois (Avast, 2019).
- 85,9% dos PCs nos dados PC Trends de 2017 da Avast tinham apenas um HD; 7,4% tinham um SSD e 6,7% um híbrido de SSD e HD (Avast, 2017).
- 48,6% dos PCs da pesquisa de hardware do Steam de outubro de 2026 tinham mais de 1 TB de espaço total em disco, e 25,1% tinham de 750 GB a 999 GB (Valve Steam Hardware and Software Survey, 2026).
- Previa-se que os preços contratuais da flash NAND subissem 15-20% no quarto trimestre de 2026, enquanto as marcas de PCs cortavam a capacidade de SSD dos modelos comuns para conter custos (previsão da TrendForce, 2026).
- Uma alta de 130% nos preços combinados de DRAM e SSD até o fim de 2026 devia elevar os preços dos PCs em 17% em relação aos níveis de 2025 (previsão do Gartner, 2026).
Preços e a escassez de 2025-2026

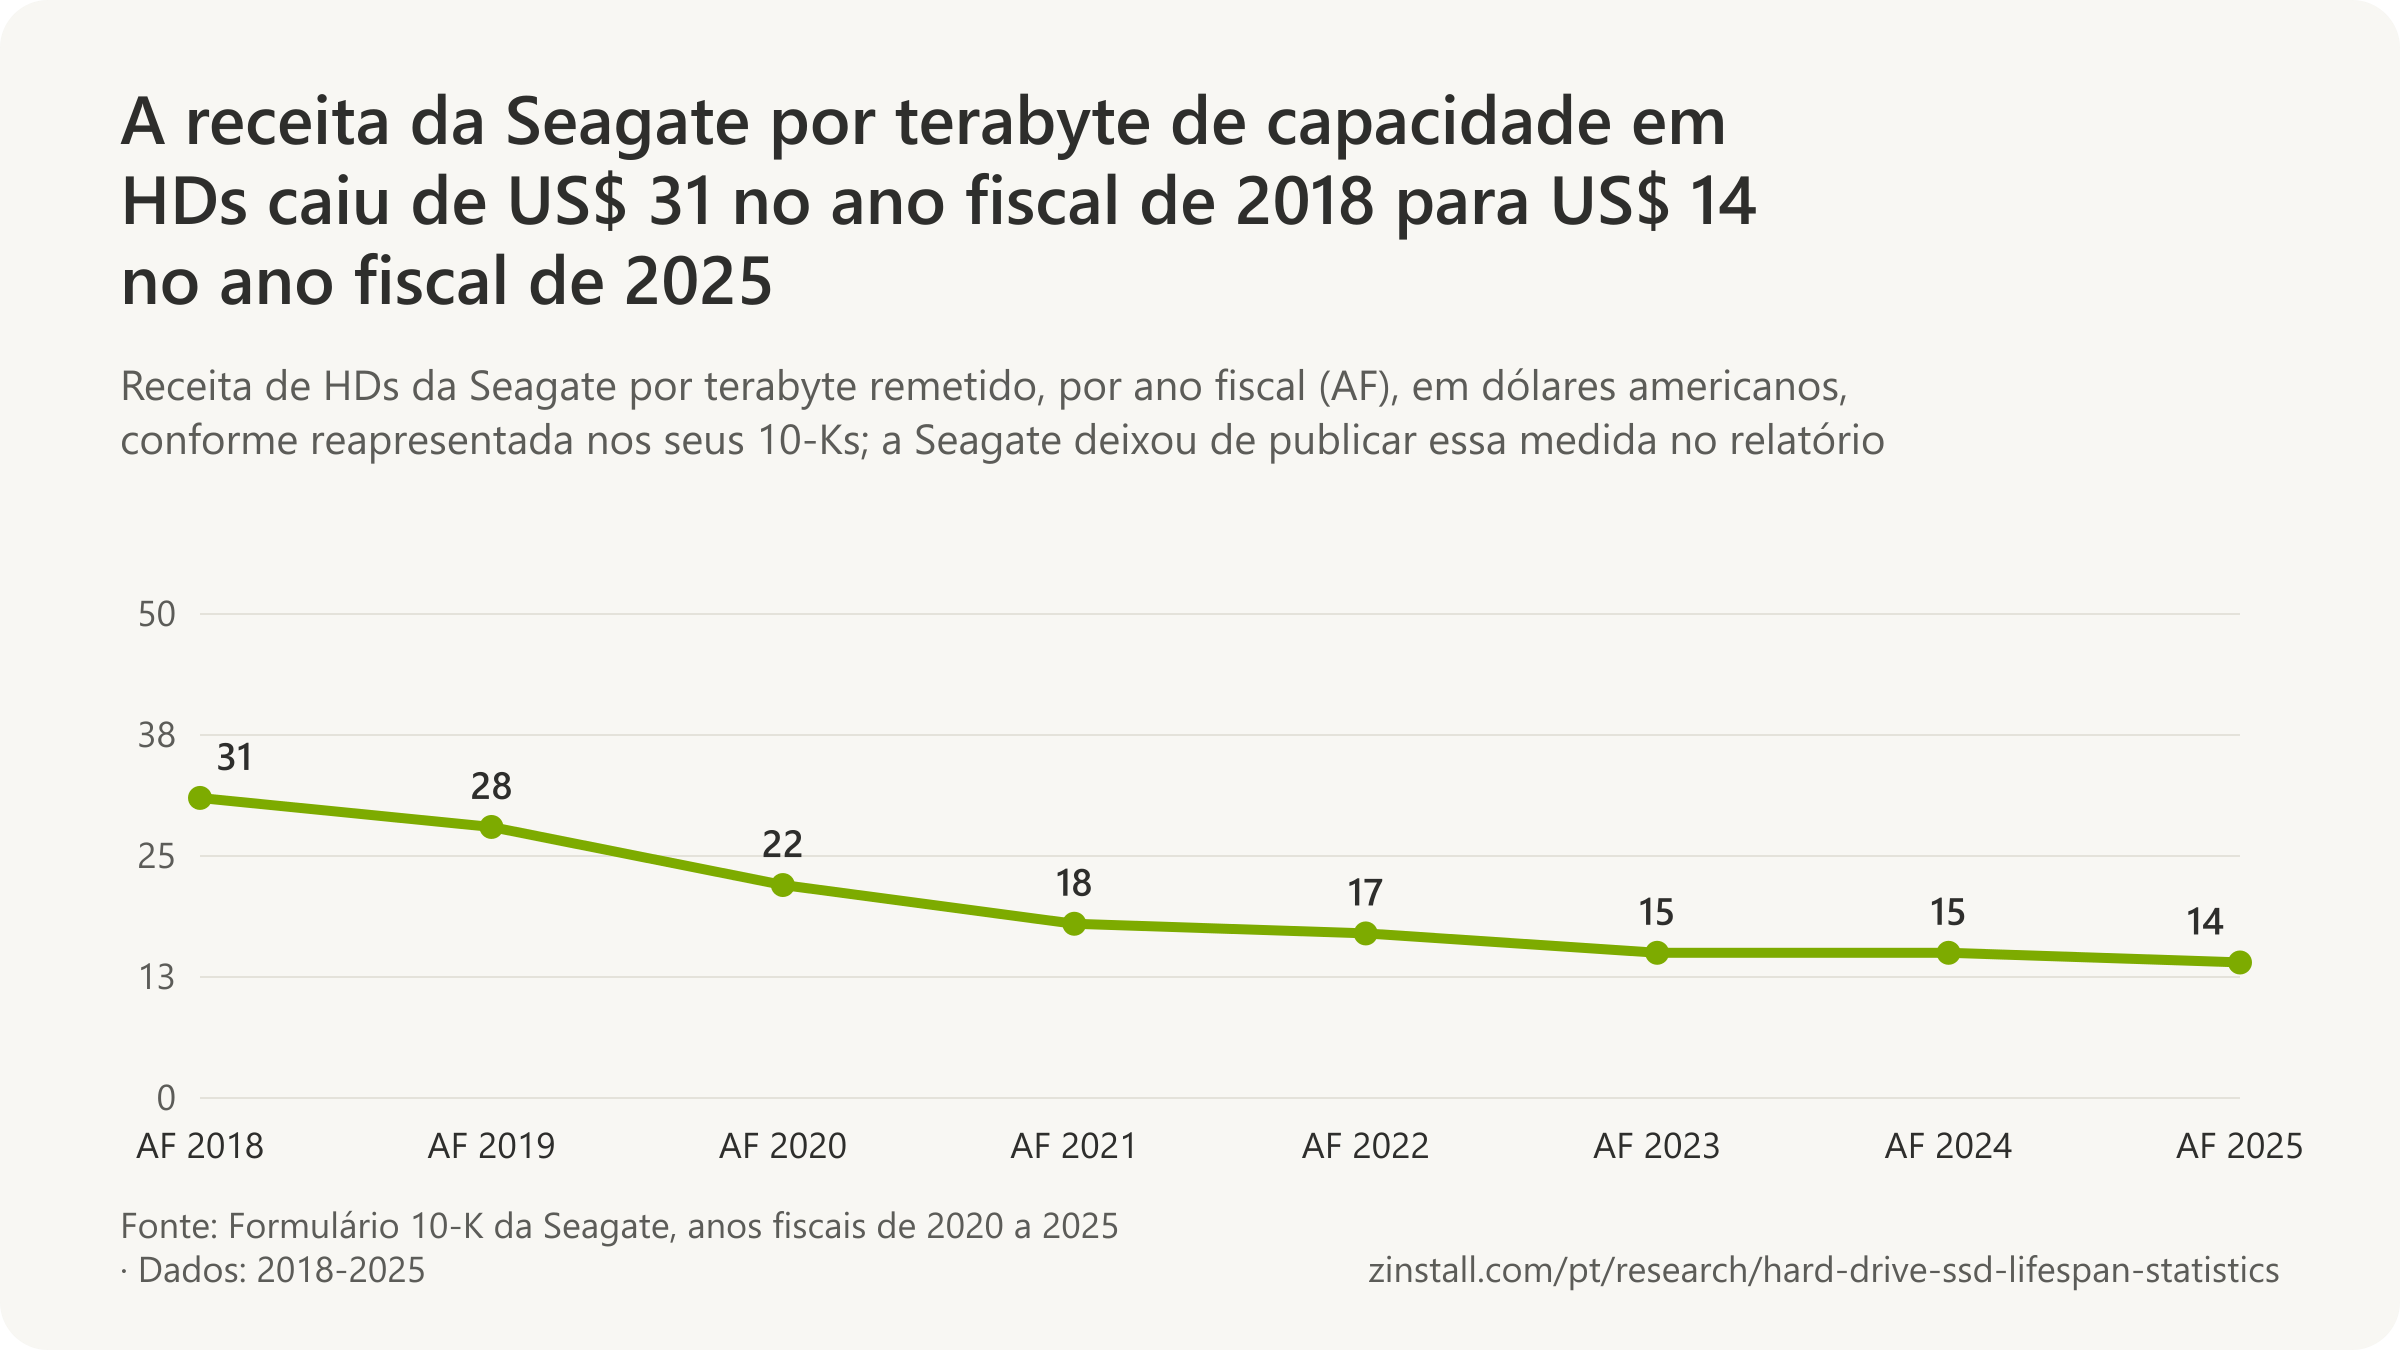

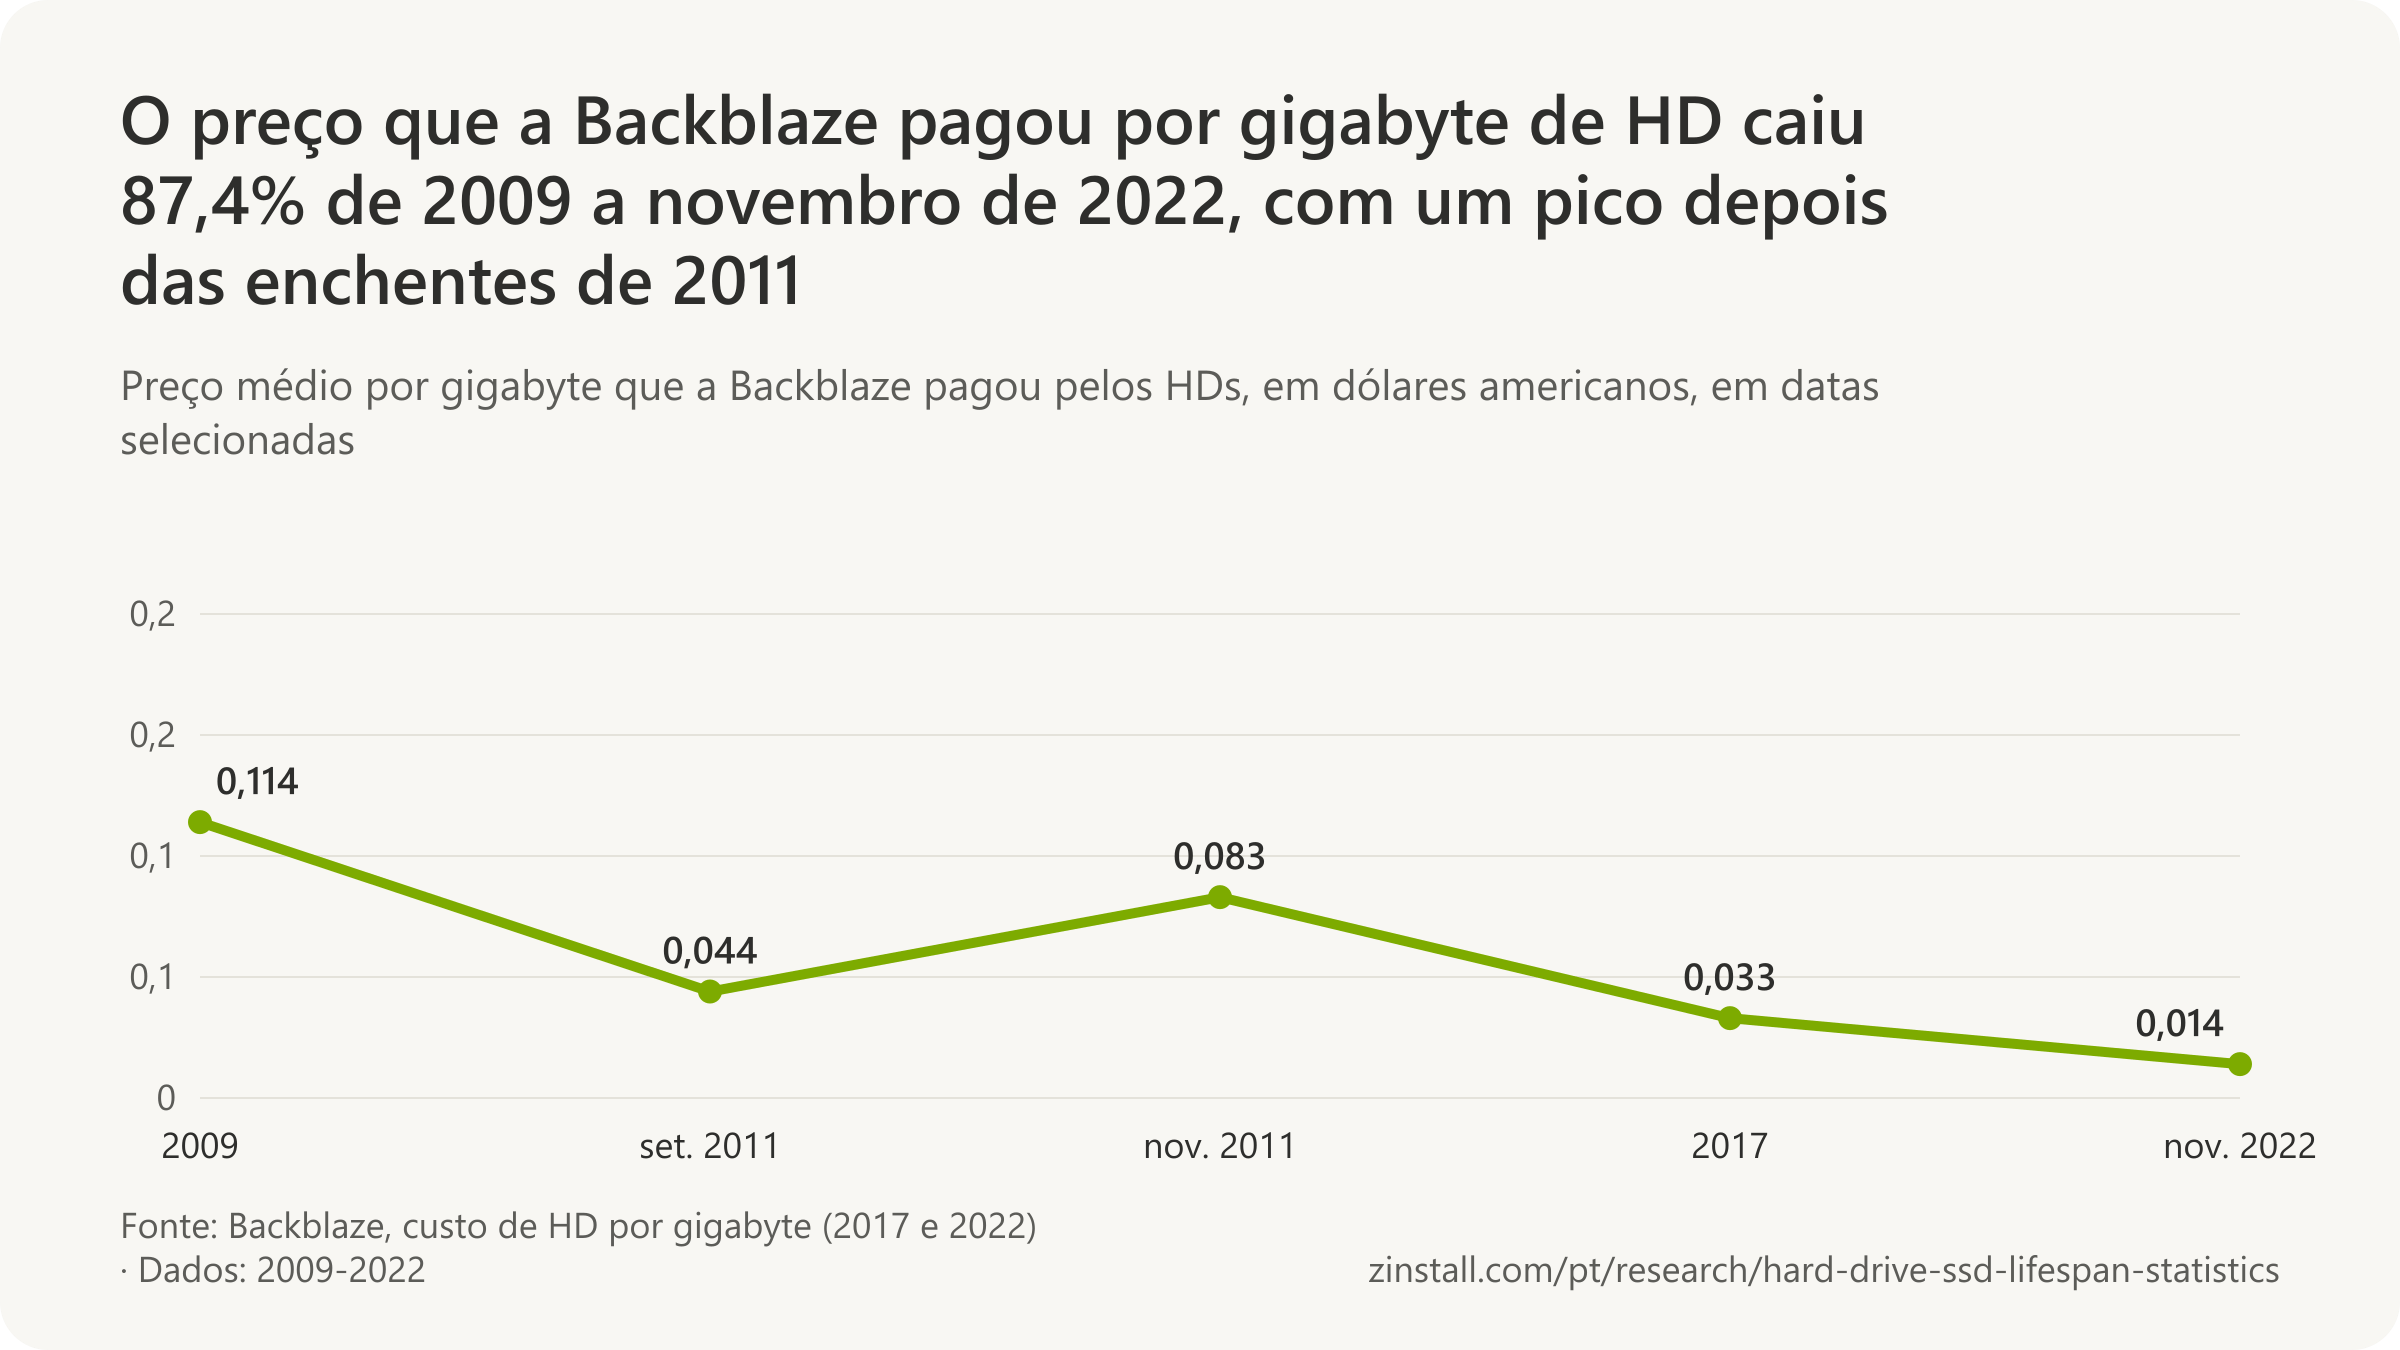
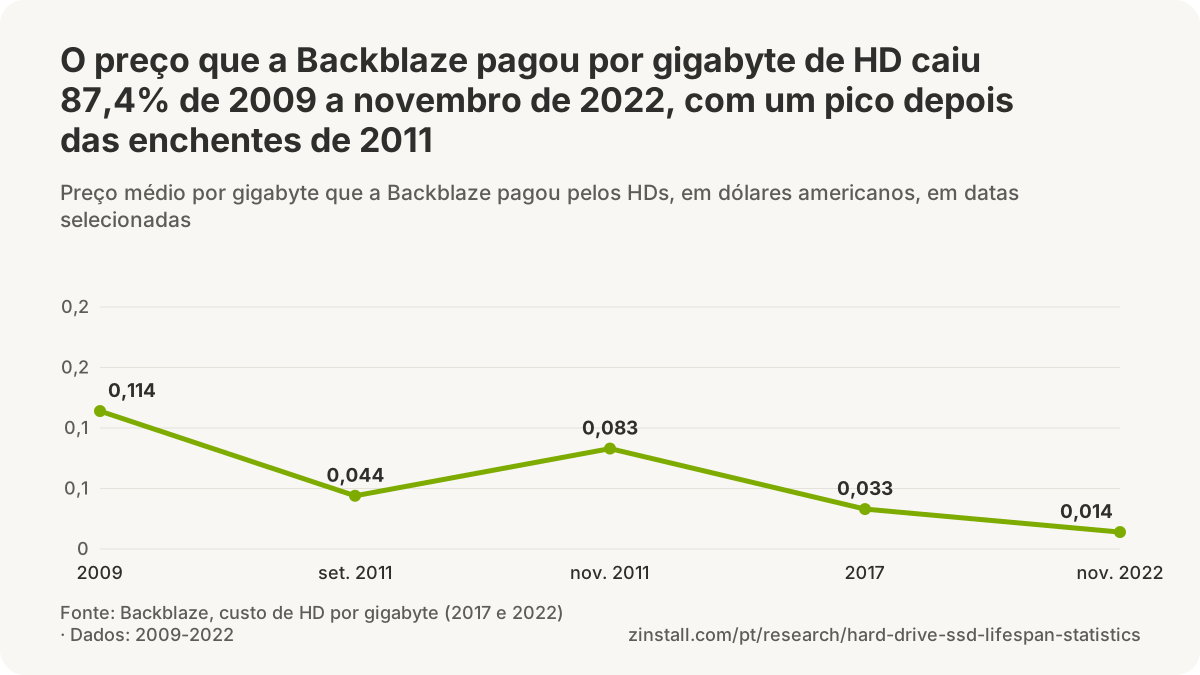

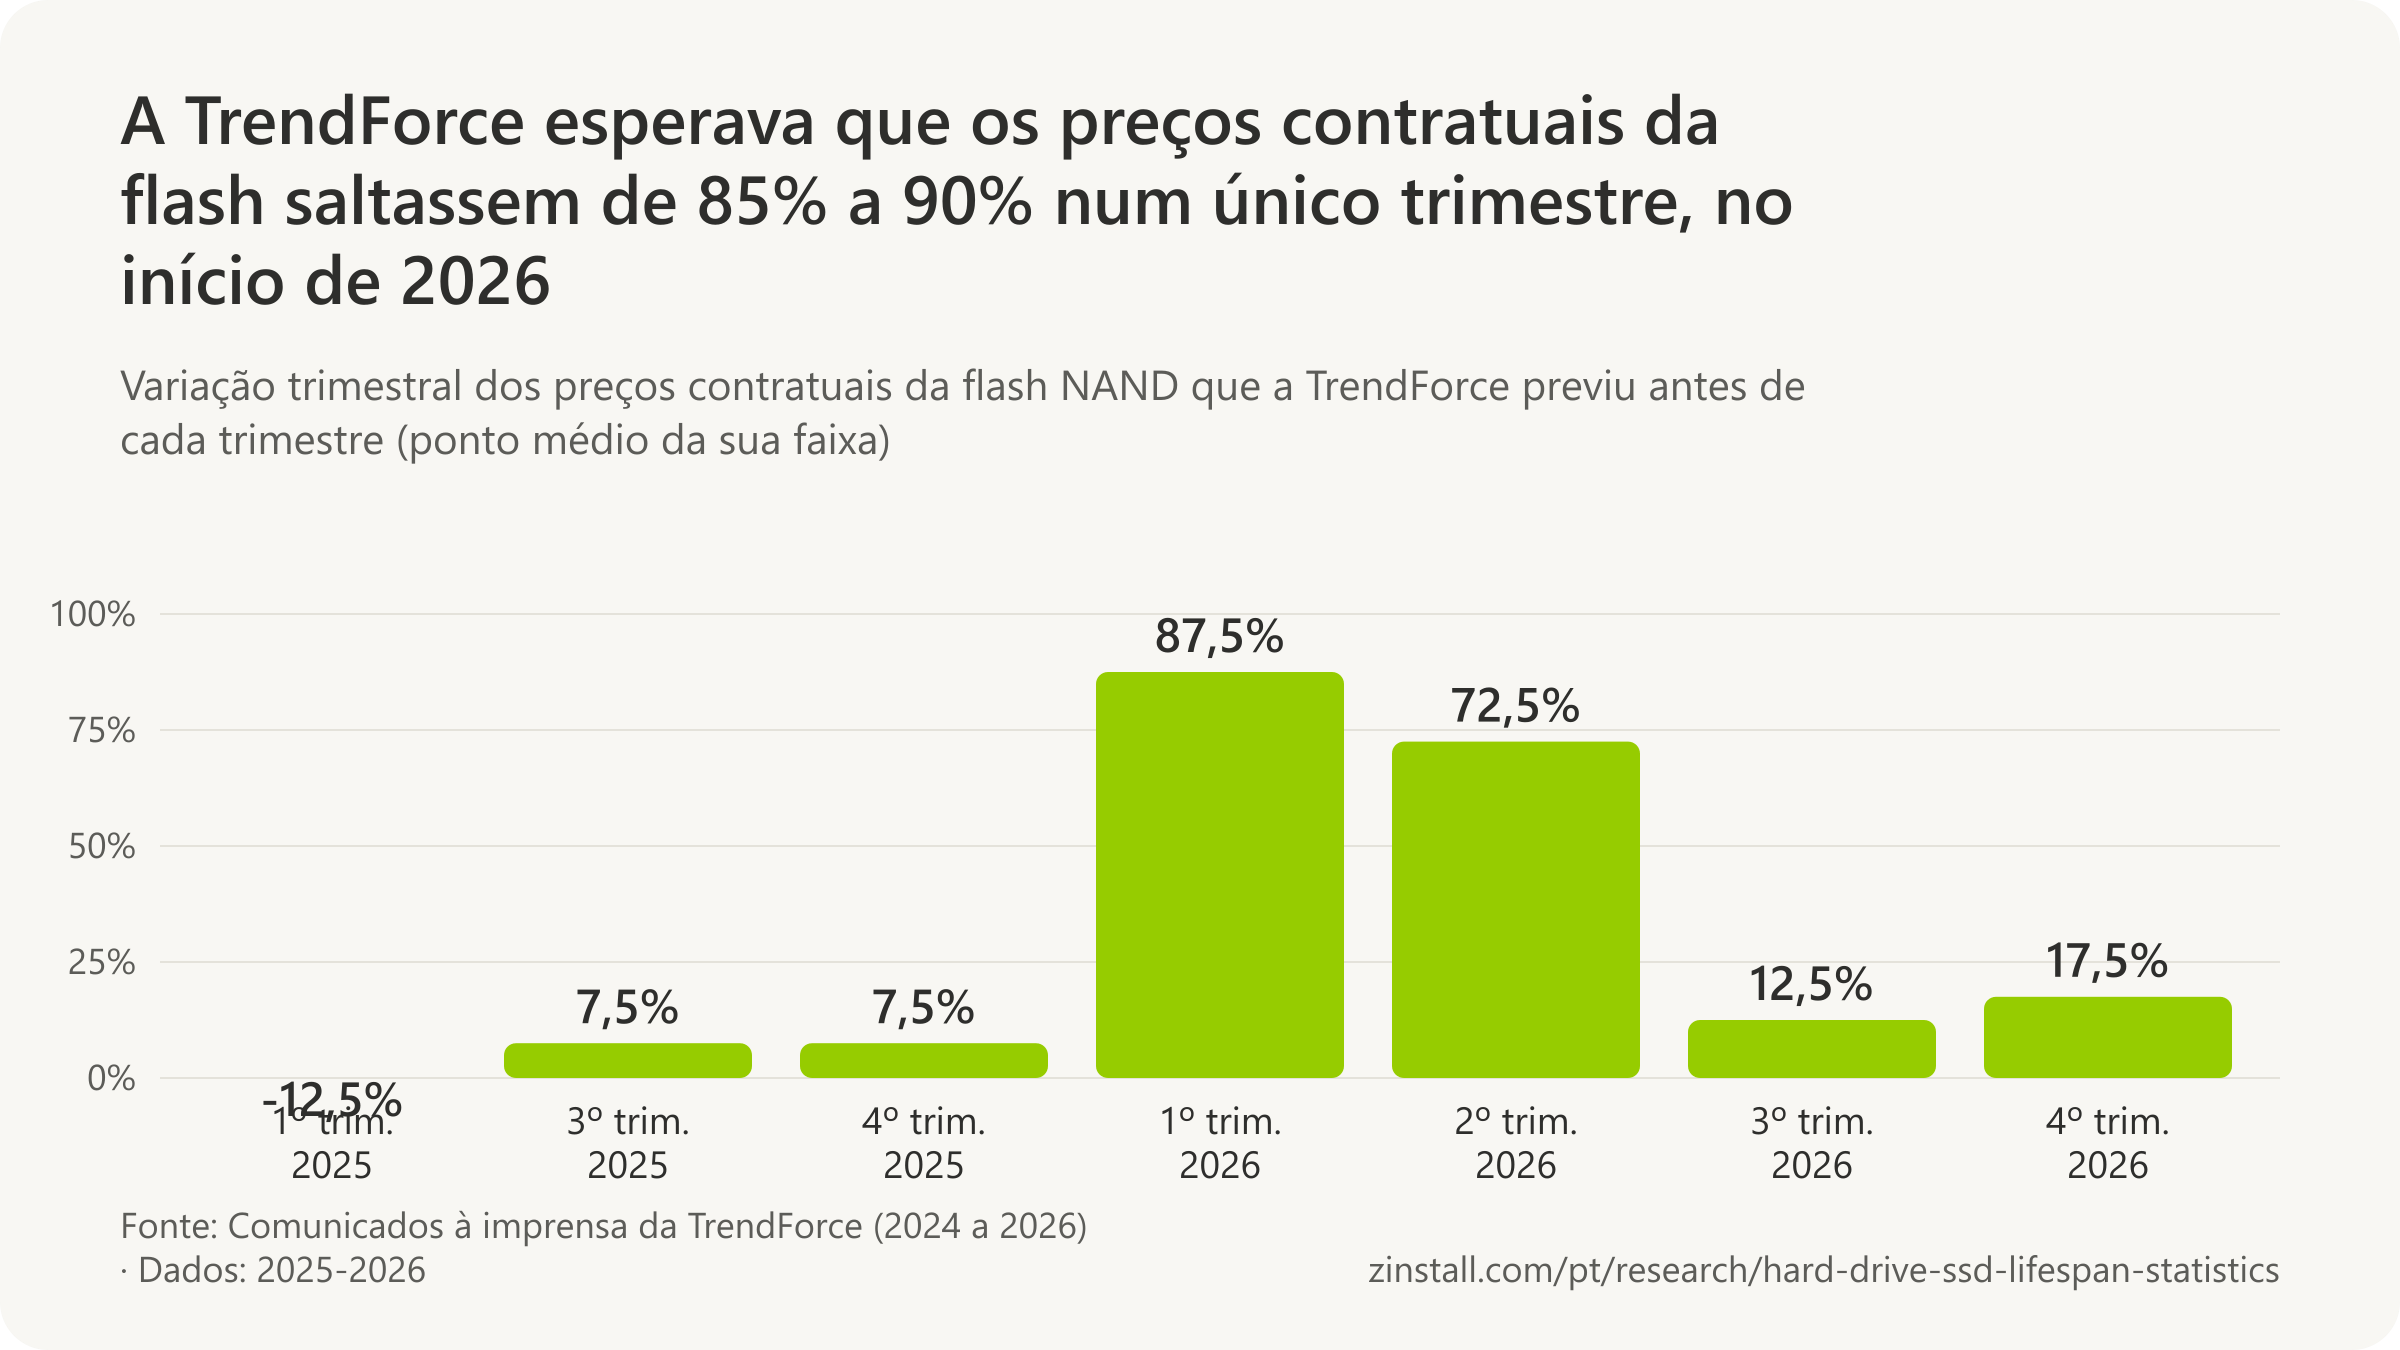
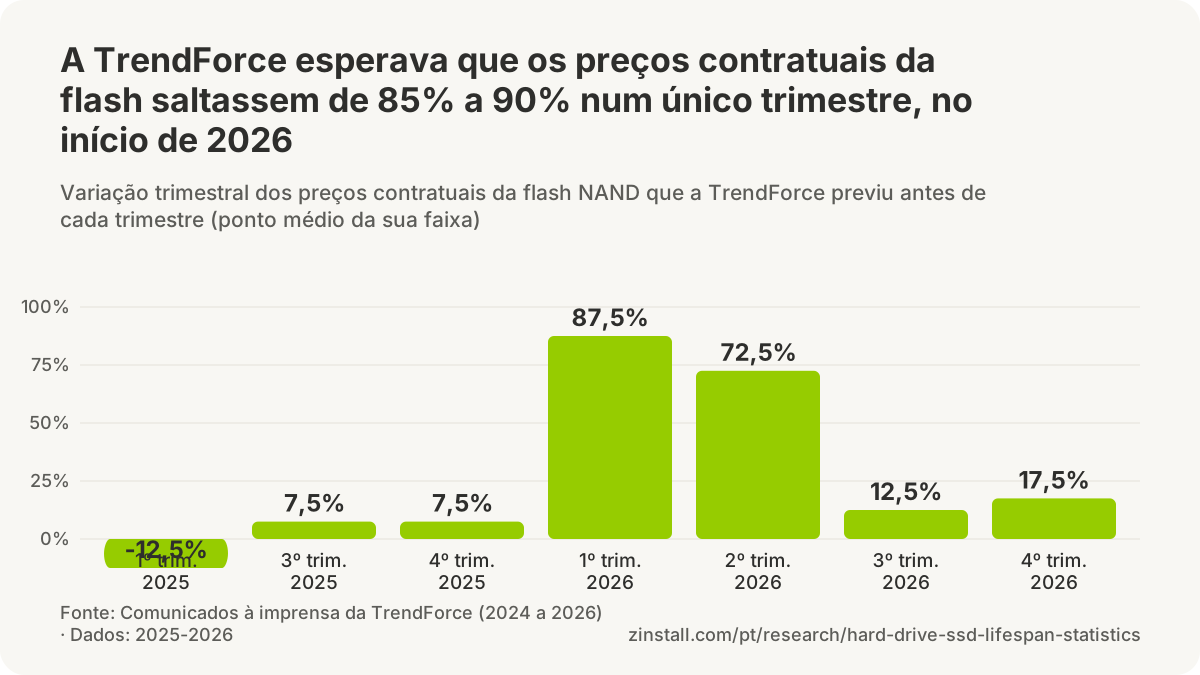
- 87,4% foi a queda do preço médio por gigabyte que a Backblaze pagou pelos HDs de 2009 a novembro de 2022, cerca de 0,52% ao mês (Backblaze, 2022).
- De 200% a 300% foi a alta dos preços dos HDs depois das enchentes de novembro de 2011 na Tailândia, como a Backblaze a viveu (Backblaze, 2015).
- 28,5 milhões de HDs foram remetidos pela Western Digital no trimestre encerrado em 30 de dezembro de 2011, depois que as enchentes na Tailândia inundaram a sua fábrica principal, contra 52,2 milhões um ano antes (Western Digital, 2012).
- US$ 199 milhões em encargos e despesas ligados às enchentes de 2011 na Tailândia foram contabilizados pela Western Digital no trimestre encerrado em 30 de dezembro de 2011, e ela só esperava recuperar a capacidade de fabricação anterior às enchentes no trimestre encerrado em setembro de 2012 (Western Digital, 2012).
- A Seagate obteve US$ 30 de receita por terabyte de capacidade em HDs remetida no ano fiscal de 2019, contra US$ 41 no ano fiscal de 2017; os seus relatórios posteriores reapresentam o ano fiscal de 2019 em US$ 28, numa nova base (formulário 10-K da Seagate, 2019).
- Cerca de US$ 195 a US$ 207 era o preço médio de venda de um HD da Seagate e da Western Digital no último trimestre de 2025, com os preços do setor cerca de 25% acima do nível de 1998 porque as unidades de data center dominam (estimativa da Coughlin Associates, 2026).
- US$ 0,015-0,016 por gigabyte (cerca de US$ 15-16 por terabyte) era o preço médio do armazenamento em HD em 2025, contra US$ 0,012-0,013, porque os fabricantes repassaram o custo da mudança para o HAMR, o que reduziu a vantagem de custo dos HDs sobre os SSDs (TrendForce, 2025).
- Mais de 52 semanas foi o prazo de entrega dos HDs nearline (de data center) em 2025, contra poucas semanas antes, porque a demanda de armazenamento para IA superou a oferta dos fabricantes, que não tinham ampliado a capacidade (TrendForce, 2025).
- De 20% a mais de 60% foi a alta dos preços contratuais dos wafers de flash NAND num único mês, novembro de 2025, em todas as categorias de produto (TrendForce, 2025).
- 29,3% da receita de flash NAND ficou com a Samsung no segundo trimestre de 2026 e 13,6% com a Kioxia, enquanto a receita dos cinco maiores fabricantes subiu 77% em um trimestre, para US$ 68,87 bilhões (TrendForce, 2026).
- Mais de 40% da demanda de flash NAND em bits vem dos servidores e quase 40% dos smartphones e notebooks juntos, e o mercado de flash enfrenta um déficit de oferta de 4-5% em 2026 (TrendForce, 2026).
- US$ 66 era o preço médio de venda por HD da Seagate no ano fiscal de 2012, alta de 22% sobre US$ 54, por causa da oferta limitada do setor depois das enchentes na Tailândia (formulário 10-K da Seagate, 2012).
Fabricantes de flash
Fontes: StorageNewsletter (2011-2024); Forbes (2023, 2025, 2026); Tom's Hardware; Western Digital Corporation (2010-2026); Seagate Technology (2010-2026); TrendForce (2016-2026); TRENDFOCUS; Avast (2017, 2019); Valve; Gartner, Inc.; Backblaze (2013, 2015, 2022); Hitachi Global Storage Technologies; HGST, a Western Digital company; Western Digital
De onde vêm as afirmações sobre a vida útil das unidades?
Os HDs duram apenas 3 a 5 anos, diz uma empresa de reparo de aparelhos aos leitores, sem citar nenhuma medição (Asurion, 2026).
- A taxa de falha de 3% muitas vezes atribuída ao Google vem do estudo de 2007 da Carnegie Mellon, atribuído por engano ao Google num blog de 2011.
- “Os HDs falham depois de 2,5 anos” transformou a idade média das unidades que falharam numa vida útil.
- Um fabricante de SSDs diz que os SSDs duram 8 anos e os HDs 4, juntando duas taxas de falha sem relação entre si.
- “Os SSDs são substituídos 25% menos vezes que os HDs” não está no estudo do Google que a frase cita.
- “Quase 50% dos HDs falham cedo demais” veio da contagem de um laboratório de recuperação que inclui só unidades que falharam.
| Página e afirmação | Número afirmado |
|---|---|
| Tom's Hardware: “21 pontos percentuais menor” (2026) | 1,36% |
| IBTimes: “SSDs sem energia perdem dados em uma semana” (2015) | uma semana |
| Ontrack: “dados de SSD sem energia seguros por pelo menos 10 anos” (2016) | pelo menos 10 anos |
| GamersNexus: “taxa de falha anual de 14% da Seagate” (2014) | 14% |
| Sandisk: “600 TBW a 20 GB por dia são 82,2 anos” (2025) | 82,2 anos |
| Enterprise Storage Forum: “a camada de óxido dura 342 anos” (2023) | 342 anos |
| XDA: “uma marca falha duas vezes mais” (2026) | duas vezes mais |
| Phiston: “vida mediana do HD de 6 anos e 9 meses” (2024) | 6 anos e 9 meses |
| Newegg: “de três a cinco anos” atribuído à Backblaze (2021) | 3 a 5 anos |
| Site japonês: “vida útil do HD de 10.000 horas, de 3 a 4 anos” (2026) | 10.000 horas (3 a 4 anos) |
Fontes: Asurion; Mobile Outfitters; Enterprise Storage Forum (2023a, 2023b); Kingston Technology; N-able; BGR; Tom's Hardware; International Business Times UK; Ontrack; GamersNexus; SanDisk; XDA Developers; Phiston Technologies; Newegg; Exidea
Mais estatísticas (72)
Os números mais citados para a vida útil das unidades não têm nenhuma medição por trás, ou vêm de um estudo real cuja medida mudou no caminho: uma idade média de unidades que falharam virou vida útil, uma classificação de população virou anos, os SSDs de uma empresa foram postos contra os HDs de outra. Cada número abaixo é o que diz uma página bem posicionada nas buscas ou muito citada, rastreado até a sua origem, ou até nenhuma; algumas reproduzem a sua fonte fielmente.
“HDs duram de 3 a 5 anos”
- A Asurion diz que os HDs duram apenas 3 a 5 anos, sem citar fonte; nenhum estudo medido dá essa faixa, e o parque de data centers da Backblaze tinha cerca de 90% das unidades ainda funcionando aos quatro anos (Asurion, 2026).
- A Secure Data Recovery resumiu “a maioria das fontes do setor”, sem nomear nenhuma, dizendo que os HDs externos duram de 3 a 5 anos, antes de relatar que as 3.453 unidades externas com falha da sua própria amostra tinham uma mediana de 190 dias de funcionamento (Secure Data Recovery, 2026).
- A SalvageData diz, sem citar nenhum estudo, que o HD médio dura de 3 a 5 anos; os dados medidos de sobrevivência que ela não cita (Backblaze, 2021) têm cerca de 90% das unidades de data center funcionando aos quatro anos e 65% aos seis (SalvageData, 2026).
- A Prosoft Engineering reproduziu o estudo de 2013 da Backblaze com 25.000 unidades dizendo que os HDs duram de três a cinco anos em média, mas o estudo relatou 78% das suas unidades de data center ainda vivas após quatro anos e não deu nenhuma vida útil de 3 a 5 anos (Prosoft Engineering, 2020).
- A Newegg reproduziu um estudo de 2013 da Backblaze dizendo que os HDs de consumo costumam durar de três a cinco anos, mas o estudo relatou 78% das suas unidades de data center ainda funcionando após quatro anos e não deu nenhuma vida útil de 3 a 5 anos (Newegg, 2021).
- A fabricante de SSDs KingSpec diz que um HD dura “entre 3 e 5 anos”, sem citar fonte; nenhum estudo medido dá essa faixa (KingSpec, 2022).
- A Ontrack diz, sem citar nada, que na realidade os HDs duram “cerca de 10 anos, no máximo”; os dados do parque da Backblaze têm unidades funcionando depois de 10 anos e não dão nenhum máximo (Ontrack, 2020).
- O IPVM resumiu a sua própria pesquisa de 2012 com integradores de vigilância numa vida útil média de HD de 3 a 4 anos, um consenso de opiniões e não uma medição, posto contra a projeção da Backblaze de cerca de seis anos (IPVM, 2013).
- O Enterprise Storage Forum diz que os HDs duram de quatro a sete anos, segundo o que “os fabricantes dizem”, sem nomear nenhum; os fabricantes de unidades publicam classificações de MTBF ou AFR e anos de garantia, não uma faixa de vida útil (Enterprise Storage Forum, 2023).
- A Ontrack descreveu a experiência dos seus engenheiros com sistemas de HD de bem mais de 30 anos que ainda dão boot e leem sem erros, um relato sem nenhuma contagem de unidades testadas ou que falharam (Ontrack, 2016).
- A vendedora de SSDs Microflash diz que a maioria dos SSDs dura de 5 a 10 anos e a maioria dos HDs de 3 a 5 anos, mais que “as suas garantias de fabricante de 3 a 5 anos”, sem citar nada para nenhuma das faixas (Microflash, 2026).
- A fabricante de software de backup Archiware respondeu à pergunta dizendo que o HD médio dura algo entre 3 e 5 anos, sem citar nenhum estudo, embora indique aos leitores as estatísticas da Backblaze mais abaixo (Archiware, 2021).
- A Datarecovery.com respondeu à pergunta “Um HD pode durar 100 anos?” dizendo que a maioria dos HDs tem uma vida útil esperada de três a cinco anos com uso regular, sem citar nenhuma medição, e acrescentando que ainda recebe unidades funcionando fabricadas nos anos 1990 (Datarecovery.com, 2025).
- A EaseUS resumiu a vida das unidades no seu site alemão dizendo que os HDs duram de 3 a 5 anos e um SSD 10 anos, sem citar nada; acrescenta que a maioria das marcas dá às unidades externas de 3 a 5 anos, sem nomear nenhuma (EaseUS, 2022).
- A empresa francesa de recuperação Chronodisk disse na televisão, sem citar nada, que 10% a 12% mais unidades falham a cada ano, o que daria 50% de chance de falha depois de três anos; mesmo 12% ao ano acumulam cerca de 32% em três anos, e os parques medidos da Backblaze perdem cerca de 1,4% ao ano (Chronodisk, 2026).
- O site japonês de análises HonNe (Exidea) dá como vida média de um HD 10.000 horas, de três a quatro anos a oito horas por dia, e acrescenta que as garantias de 3 a 4 anos dos fabricantes de PCs supõem que a unidade morra até lá, tudo sem fonte (HonNe, 2026).
- A fabricante de SSDs Crucial respondeu ao seu próprio FAQ dizendo que os SSDs duram de 5 a 10 anos em uso normal e os HDs de 3 a 5 anos, sem citar nada; as classificações da própria Crucial para os seus SSDs MX500, P3 Plus e T500 são garantias de cinco anos limitadas pelas gravações nominais, não vidas úteis (Crucial, 2026).
“SSDs duram de 5 a 10 anos”
- A Asurion diz que os SSDs têm “uma vida útil longa, de cerca de 10 anos ou mais”, sem citar fonte; os estudos de campo de SSDs medem taxas de substituição e de erros ao longo de quatro a seis anos, não uma vida útil de 10 anos (Asurion, 2026).
- A Newegg noticiou “algumas estimativas”, sem nomear nenhuma, segundo as quais os SSDs duram 10 anos com cargas de trabalho normais, contra uma estimativa mais antiga de cinco a seis anos (Newegg, 2021).
- A KingSpec diz que a vida útil média de um SSD NVMe é de 10 anos, sem citar nenhuma medição; nenhum estudo de campo relata uma vida útil média de NVMe (KingSpec, 2022).
- A N-able (publicado primeiro como SolarWinds MSP) apresentou “as estimativas atuais”, sem nomear nenhuma, como um “limite de idade” de cerca de 10 anos para os SSDs; o estudo do Google que ela cita em seguida acompanhou unidades por quatro a seis anos e não dá nenhum limite de idade (N-able, 2019).
- A Ontrack apresentou em 2020 “as estimativas mais recentes”, sem nomear nenhuma, como um “limite de idade” de cerca de 10 anos para os SSDs, numa frase quase idêntica à da SolarWinds MSP de 2019 (Ontrack, 2020).
- A SanDisk diz, sem citar nenhuma medição, que a maioria dos SSDs dura de 5 a 10 anos em uso normal, e muitas vezes mais; a faixa não descreve nenhum estudo de campo, e o compromisso da própria SanDisk para os seus SSDs WD Black e WD Blue é uma garantia de cinco anos limitada pelas gravações nominais (SanDisk, 2025).
- A Kingston diz, sem citar nada, que um SSD dura 8 anos em média, com uma taxa de falha anualizada de 0,9%, contra 4 anos e 1,7% de um HD; as duas taxas coincidem com números de 2023 da Backblaze para medidas diferentes (SSDs de boot em todo o tempo de serviço, HDs de data center só em 2023), e nenhuma fonte dá as vidas úteis de 8 e 4 anos (Kingston, 2026).
- SSDs 47% menos propensos a falhar e que duram o dobro dos HDs: foi assim que a Kingston leu a sua própria combinação, sem fonte, de uma taxa de falha de 0,9% e outra de 1,7%, taxas que vêm de medidas diferentes da Backblaze (Kingston, 2026).
- Um SSD que dura cerca de 8 anos com taxa de falha de 0,9%, contra uns 4 anos e 1,7% dos HDs: foi assim que a SalvageData repetiu a combinação, sem fonte, que a Kingston fez de duas medidas diferentes da Backblaze (SalvageData, 2026).
- A Phiston Technologies diz, sem citar nada, que um SSD típico dura 10 anos ou mais com os devidos cuidados, logo depois de um número sobre HDs com fonte (Phiston Technologies, 2024).
- O XDA deu como manchete que uma marca de HD falha duas vezes mais que outra, sobre uma análise revisada por pares de 443.156 unidades de data center da Backblaze, que encontrou taxas de falha ajustadas da HGST de cerca de 41% e da WD de cerca de 52% das da Seagate, com a Toshiba um pouco acima da Seagate (XDA, 2026).
- A maioria dos HDs durando algo entre 5 e 10 anos: foi assim que o XDA leu o conjunto de dados de 13 anos da Backblaze por trás do estudo com 443.156 unidades, uma faixa de vida útil que o estudo não dá; ele relata taxas de falha relativas por marca, idade, capacidade e temperatura (XDA, 2026).
- SSDs que duram de 5 a 10 anos e armazenamento flash que dura cerca de 10 anos: foi assim que o Enterprise Storage Forum apresentou a “expectativa de vida planejada” das unidades, sem citar fonte para nenhuma das faixas (Enterprise Storage Forum, 2023).
- Uma estimativa de fabricante de 5 a 7 anos de vida útil para um SSD, que o uso leve poderia estender para mais de 10 e o uso intenso reduzir para 3 a 5: foi assim que a PCWorld apresentou a vida dos SSDs, sem nomear nenhum fabricante nem estimativa (PCWorld, 2024).
- Um SSD moderno que dura 8 anos em média, com taxa de falha de 0,9%, contra 4 anos e 1,7% de um HD: foi assim que a Kingston apresentou o tema no seu blog alemão, a mesma combinação sem fonte do seu post em inglês (Kingston, 2026).
- Um SSD moderno que dura 8 anos em média, com taxa de falha de 0,9%, contra 4 anos e 1,7% de um HD: foi assim que a Kingston apresentou o tema no seu blog francês, a mesma combinação sem fonte do seu post em inglês (Kingston, 2026).
- Uma vida útil média de SSD de 8 anos, com taxa de falha de 0,9%, contra 4 anos e 1,7% de um HD: foi assim que a Kingston apresentou o tema no seu blog japonês, a mesma combinação sem fonte do seu post em inglês (Kingston, 2026).
Classificações transformadas em anos
- A SanDisk transformou uma classificação de resistência numa vida útil ao dizer que um SSD de 600 TBW dura 82,2 anos com 20GB de gravações por dia, embora o TBW seja o limite de gravação da garantia e os SSDs falhem por causas ligadas à controladora, ao firmware e à idade muito antes do desgaste (SanDisk, 2025).
- O MakeUseOf explicou que um MTBF de 1,5 milhão de horas não significa que uma unidade dura 171 anos, tratando corretamente o MTBF como uma taxa de falha de população (MakeUseOf, 2015).
- 1,5 milhão de horas de MTBF equivalem a cerca de 171 anos, mas significam uma taxa de falha anual de cerca de 0,58%: foi assim que a fabricante de SSDs OSCOO explicou a classificação, corretamente (OSCOO, 2026).
- 1,5 milhão de horas de MTBF “equivalentes a mais de 171 anos”: foi assim que o ITIGIC apresentou a classificação, antes de explicar que ninguém testa uma peça por 171 anos e que o número é uma previsão (ITIGIC, 2020).
- Um MTBF de HD de cerca de meio milhão de horas, aproximadamente 57 anos: foi assim que o Enterprise Storage Forum apresentou o dado, transformando uma classificação em anos, com o MTBF dos SSDs “relatado” em 2,5 milhões de horas e nenhuma fonte para nenhum dos dois (Enterprise Storage Forum, 2023).
- O Enterprise Storage Forum calculou a vida útil de um SSD dizendo que a sua camada de óxido dura 342 anos, a partir de 3.000 ciclos de gravação, uma capacidade de 1.000GB, uma amplificação de gravação de 5 e 1.750GB gravados por ano, uma conta de resistência nominal apresentada como vida útil (Enterprise Storage Forum, 2023).
- SSDs cerca de 20 vezes mais resistentes que os HDs, suportando 1.500G contra 70 a 80G: foi assim que a Kingston apresentou números de choque como “testes experimentais”, sem citar nenhum teste; esses números são classificações de choque em operação das fichas técnicas, medidas em condições de pulso definidas, e não testes de unidades em uso (Kingston, 2026).
Os números da Backblaze como outros os reproduziram
- Unidades que falham a 5,1% ao ano no primeiro 1,5 ano, a 1,4% no 1,5 ano seguinte e a 11,8% ao ano depois de três anos: foi assim que o IPVM reproduziu o post de 2013 da Backblaze sobre a vida útil de cerca de 25.000 unidades de linha de consumo no seu data center, no mesmo dia em que ele foi publicado (IPVM, 2013).
- A Phiston Technologies reproduziu a estimativa de 2021 da Backblaze como uma expectativa de vida mediana de HD de seis anos e nove meses, um número que a Backblaze extrapolou de seis anos de dados das suas unidades de data center e sobre o qual disse não ter dados para ter certeza (Phiston Technologies, 2024).
- O GamersNexus reproduziu o post de janeiro de 2014 da Backblaze dizendo que a Seagate tinha uma taxa de falha anual de 14% em todas as suas unidades, mas o gráfico do post põe perto de 14% apenas as unidades de 1,5TB da Seagate, enquanto as de 3TB estavam em 9,8% e as de 4TB em 3,8% (GamersNexus, 2014).
- Taxas de falha de todo o tempo de serviço que vão de cerca de meio por cento a quase 6% em 354.415 HDs: foi assim que o XDA reproduziu o Drive Stats do 2º trimestre de 2026 da Backblaze, cuja tabela de todo o tempo de serviço cobre 353.041 unidades, com uma AFR de todo o tempo de serviço de 1,41% em todo o parque, sendo a contagem de 354.415 a da tabela trimestral (XDA, 2026).
- “Quando os HDs falham, normalmente é em até 3 anos de operação”: foi assim que o TechSpot deu a manchete da análise da Backblaze de 17.155 unidades de data center com falha, cujo número é a idade média das unidades que tinham falhado (dois anos e seis meses), num parque em que cerca de 1,4% das unidades falhavam por ano (TechSpot, 2023).
- O Enterprise Storage Forum reproduziu a idade média das 17.155 unidades com falha da Backblaze dizendo que os HDs falham depois de dois anos e meio, em média, o que transforma uma idade na falha numa vida útil; é essa a redação que uma postagem do Facebook mostra nos resultados do Google (Enterprise Storage Forum, 2023).
- Uma vida útil de HD de dois anos e 10 meses: foi assim que a Network World reproduziu a amostra de 2023 da Secure Data Recovery, de 2.007 unidades com falha enviadas para recuperação, cujo número é o tempo médio de funcionamento das unidades que tinham falhado (Network World, 2023).
- O Tom's Hardware deu como manchete do relatório de 2025 da Backblaze uma taxa de falha anualizada de 1,36% em 2025 que seria “21 pontos percentuais menor que no ano anterior”, mas no relatório a taxa caiu de 1,55% em 2024, uma queda de 0,19 ponto (Tom's Hardware, 2026).
- Uma taxa de falha anualizada de 1,13% em 2025, ou uma unidade em cada 88: foi assim que o BGR noticiou o ano da Backblaze, mas 1,13% foi apenas o quarto trimestre; a taxa anual de 2025 da Backblaze é de 1,36% em 344.196 unidades, cerca de uma em cada 74 (BGR, 2026).
- HDs que duram cerca de quatro anos em média: foi assim que o Lifehacker leu a constatação da Backblaze de que cerca de 80% das suas unidades de data center sobreviveram a quatro anos, transformando uma parcela de sobrevivência numa vida média (Lifehacker, 2015).
- HDs que falham a 6,26% ao ano, contra 0,79% dos SSDs: foi assim que o Production Expert abriu o seu resumo da primeira comparação de SSDs da Backblaze, números que a própria Backblaze chamou de injustos porque os HDs de boot eram muito mais antigos que os SSDs; com idades iguais, as taxas eram próximas (Production Expert, 2021).
- SSDs que falham a 0,98% ao ano, contra 1,64% dos HDs: foi assim que a ULINK DA reproduziu a Backblaze via Blocks & Files, uma combinação da taxa de 2022 das unidades de boot SSD da Backblaze com uma tabela separada de HDs, e não uma comparação com idades iguais (ULINK DA, 2025).
- 78% das unidades vivendo mais de quatro anos e apenas 22% morrendo antes: foi assim que a ComputerWeekly.de reproduziu os dados de 2013 da Backblaze sobre unidades de consumo funcionando ininterruptamente no seu data center, uma reprodução fiel que ainda aparece bem posicionada nas buscas alemãs sobre vida útil (ComputerWeekly.de, 2014).
- Um alerta para desconfiar de qualquer unidade de backup com mais de três anos: foi assim que a W&V transformou em conselho a idade média de 17.155 unidades com falha da Backblaze (dois anos e seis meses), acrescentando que as unidades falham ainda mais rápido do que a Secure Data Recovery tinha constatado (W&V, 2023).
- Um risco de falha de 5,1% no primeiro ano de uma unidade, caindo para 1,4% no segundo e no terceiro anos: foi assim que o Tom's Guide France reproduziu as taxas de 2013 da Backblaze, que valiam para os primeiros 18 meses e para os 18 meses seguintes, acrescentando que 80% das unidades no mercado sobrevivem a quatro anos (Tom's Guide France, 2013).
- Uma vida mediana de HD de seis anos e nove meses, como a Backblaze estimou a partir das suas unidades de data center, com a ressalva de que os seus dados depois dos seis anos são escassos: foi assim que o @IT, da ITmedia, reproduziu a análise de 2021 em japonês, fielmente (@IT, 2022).
Estudos reproduzidos
- A N-able (primeiro como SolarWinds MSP) reproduziu o estudo de flash de 2016 do Google e da Universidade de Toronto dizendo que os SSDs são substituídos cerca de 25% menos vezes que os HDs, mas o estudo relata de 4% a 10% de unidades flash substituídas em quatro anos, contra 2% a 9% de HDs por ano em estudos anteriores, e nenhum número de 25% (N-able, 2019).
- SSDs substituídos cerca de 25% menos vezes que os HDs: foi assim que a Ontrack reproduziu o estudo de flash de 2016 do Google e da Universidade de Toronto, que relata de 4% a 10% de unidades flash substituídas em quatro anos, contra 2% a 9% de HDs por ano em estudos anteriores, e nenhum número de 25% (Ontrack, 2020).
- Cada 10 °C a mais tornando um HD cerca de 23% mais propenso a falhar: foi assim que o XDA apresentou a constatação do estudo, que acumula uma taxa de falha 2,1% maior por grau a mais de temperatura média nas unidades de data center da Backblaze até chegar a 23,1% (XDA, 2026).
- O Mobile Outfitters reproduziu os estudos de 2007 dizendo que o Google encontrou uma taxa de falha de 3% nos HDs, contra 0,88% dos fabricantes, mas os 3% (média ponderada de 3,01%) e a taxa de 0,88% da ficha técnica são constatações da Carnegie Mellon, enquanto o artigo do Google deu taxas por idade de 1,7% a 8,6% (Mobile Outfitters, 2011).
- Uma taxa de falha anualizada média de 3% ao longo de um a cinco anos: é assim que a Wikipedia resume o estudo de 2007 da Carnegie Mellon, corretamente, ao lado da faixa do Google de 2007, de 1,7% para unidades no primeiro ano a mais de 8,6% para unidades de três anos (Wikipedia, 2026).
- Cerca de 7% ao ano para unidades com mais de dois anos: foi assim que o Ask Leo! resumiu o artigo de 2007 do Google, uma leitura justa das suas taxas por idade (8,0% aos dois anos, 8,6% aos três, 5,9% aos quatro, 7,3% aos cinco) para as unidades dos data centers do Google (Ask Leo!, 2007).
- O BGR deu como manchete da amostra de 2026 da Secure Data Recovery que quase 50% dos HDs falham cedo demais, mas nela 49,8% das 5.106 unidades com falha enviadas para recuperação tinham funcionado menos de um ano, uma parcela das falhas, e não de todas as unidades (BGR, 2026).
- SSDs substituídos 25% menos vezes que os HDs comuns: foi assim que a EaseUS repetiu no seu site alemão a afirmação impossível de rastrear da SolarWinds MSP e da Ontrack, sem nenhuma fonte (EaseUS, 2022).
- 1,7% das 100.000 unidades do Google substituídas no primeiro ano, 8% no segundo e 8,6% no terceiro: foi assim que o Clubic reproduziu o estudo de 2007 do Google, fielmente (Clubic, 2007).
SSDs sem energia
- Um SSD desligado que não falha por “cerca de 5 a 6 anos”: foi assim que a KingSpec reescreveu a frase de 2016 da Ontrack de que a degradação dos dados não deveria ocorrer por pelo menos 10 anos, mudando o número e sem citar nada (KingSpec, 2022).
- A Ontrack disse em 2016, sem citar nada, que os dados num SSD sem energia não se degradam por pelo menos 10 anos em armazenamento ideal; o requisito do JEDEC para SSDs de consumo no fim da resistência nominal é de um ano com a energia desligada a 30 °C, e a própria Ontrack acrescenta que a flash TLC pode perder dados em meses (Ontrack, 2016).
- O IBTimes UK noticiou que os SSDs começam a perder dados se ficarem sem energia por apenas uma semana, a partir de uma apresentação no JEDEC de Alvin Cox, da Seagate, cujas tabelas tratam de unidades desgastadas guardadas no calor; Cox disse depois: “Tudo isso diz respeito ao fim de vida” (IBTimes UK, 2015).
- Um SSD desligado a 104 °F (40 °C) que pode perder dados depois de umas duas semanas: foi assim que a PCWorld reproduziu as tabelas do JEDEC de Alvin Cox, três dias depois do IBTimes, antes de a própria PCWorld noticiar que elas se aplicam apenas a unidades desgastadas (PCWorld, 2015).
- “Tudo isso diz respeito ao fim de vida”: foi assim que Alvin Cox, da Seagate, autor da apresentação no JEDEC por trás da afirmação de uma semana, se expressou à PCWorld, que noticiou que mesmo um SSD desgastado guardaria os dados por um ano armazenado a cerca de 30 °C, pelas tabelas originais (PCWorld, 2015).
Outras afirmações
- Metade das falhas de HD vindo de danos físicos, como quedas: foi assim que a Payam Data Recovery resumiu as 30.000 unidades do seu próprio laboratório (de 2020 a 2025), sem dar contagens, categorias nem método por trás da divisão 50-50 (Payam Data Recovery, 2025).
Fontes: Asurion; Secure Data Recovery Services; SalvageData Recovery Services (2026); Prosoft Engineering; Newegg; KingSpec; Ontrack (2016, 2020); IPVM; Enterprise Storage Forum (2023); Microflash; Archiware; Datarecovery.com; EaseUS; Chronodisk; Exidea; Crucial; N-able (2019); SanDisk; Kingston Technology (2026); Phiston Technologies; XDA Developers (2026); PCWorld (2015, 2024); MakeUseOf; OSCOO; ITIGIC; GamersNexus; TechSpot; Network World; Tom's Hardware; BGR; Lifehacker; Production Expert; ULINK Technology; ComputerWeekly.de; W&V; Tom's Guide France; @IT; Mobile Outfitters; Wikipedia; Ask Leo!; Clubic; International Business Times UK; Payam Data Recovery
Dados. Todas as 1.254 estatísticas desta página, cada uma com sua fonte, a citação literal e o localizador: CSV · JSON. Os gráficos e os números desta página podem ser reutilizados com um link para https://www.zinstall.com/pt/research/hard-drive-ssd-lifespan-statistics como fonte. Os créditos continuam sendo das organizações que publicaram os dados originais.
Dados de cada gráfico (CSV, 61 arquivos)
- Os HDs da Backblaze falharam a 1,36% em 2025, e entre 0,93% e 1,89% ao ano desde 2018
- Nos dados de 2025 da Backblaze, as falhas atingiram o pico de 4,25% ao ano aos 10 anos de idade; nos dados de 2013, o pico foi de 13,73% aos 3 anos
- Os parques de SSDs falharam ou foram substituídos a 0,2% a 1,2% ao ano nos estudos que publicaram uma taxa
- No quinto ano de serviço, as unidades de boot SSD da Backblaze falharam a 0,92%, contra 3,55% das suas unidades de boot HD
- As unidades da Western Digital foram as que menos falharam nos data centers da Backblaze, 0,60% ao ano ao longo do seu tempo de serviço
- De quase um quarto a quase dois quintos das unidades que falharam não deram nenhum sinal de alerta antes da falha, em todos os estudos que verificaram isso
- Nos dados de 2007 do Google, os HDs jovens falharam mais quando frios e os de três anos muito mais quando quentes
- Seis SSDs num teste de gravação até a morte de 2013-2015 gravaram de 700 TB a 2,4 petabytes antes de morrer
- Um MTBF de 1 milhão de horas significa que cerca de 0,88% das unidades falham por ano, não um século de vida
- Seis em cada dez HDs externos com falha enviados a um laboratório de recuperação dos EUA tinham morrido no primeiro ano de uso
- Um SSD de consumo desgastado guarda os dados por cerca de dois anos sem energia a 25 °C, mas por duas semanas a 55 °C
- Bugs de firmware desativaram SSDs numa contagem fixa de horas de funcionamento, de 1.700 a 70.000
- Recuperar uma unidade com falha física pode custar de US$ 1.500 a US$ 3.000 ou mais pelos preços publicados dos laboratórios dos EUA
- Estima-se que um em cada dez CDs prensados falhe em até 25 anos, pelos testes de envelhecimento acelerado da Biblioteca do Congresso
- 124 milhões de HDs foram remetidos no mundo em 2025, um quinto dos 651 milhões de 2010
- A taxa anual de falha de HDs da Backblaze caiu de mais de 6% em 2014 para menos de 2% ao ano a partir de 2016
- A taxa trimestral de falha de HDs da Backblaze variou de menos de 1% a mais de 2% de 2016 a meados de 2026
- Em todo o tempo de serviço, as unidades em uso da Backblaze falharam a 1,3% a 2,0% ao ano
- O parque de unidades da Backblaze cresceu de 27.000 HDs em 2013 para quase 350.000 em 2025
- No estudo de 2007 do Google, as unidades falharam a 1,7% no primeiro ano e a 8,6% aos três anos
- As substituições de unidades subiram com a idade no registro de cinco anos de um supercomputador, sem um trecho estável no meio
- Metade dos HDs com falha enviados a um laboratório de recuperação dos EUA tinha funcionado menos de um ano
- Os modelos de SSD corporativo da NetApp foram substituídos a 0,07% a quase 1,2% ao ano
- Os modelos de SSD NVMe da Alibaba foram substituídos a 0,26% a 2,34% ao ano
- Os SSDs SATA 3D-TLC da Alibaba falharam a mais de 3% ao ano, várias vezes a taxa dos seus modelos MLC
- Cerca de 5% das unidades da maioria dos modelos de SSD nos data centers do Google foram substituídas em até quatro anos, e cerca de 10% nos piores
- De um quinto a nove décimos das unidades flash do Google tiveram pelo menos um erro incorrigível, conforme o modelo
- Entre cerca de um terço e nove décimos das unidades flash do Google desenvolveram blocos defeituosos, conforme o modelo
- Os SSDs de classe de consumo dos data centers da Microsoft falharam a cerca de 0,4% a 1,0% ao ano, e o seu modelo corporativo a cerca de 0,14%
- As unidades de boot SSD da Backblaze falharam a menos de 1,3% ao ano de 2019 a 2022
- As unidades de boot HD da Backblaze falharam mais a cada ano a partir do ano 4, enquanto os seus SSDs ficaram perto de 1%
- Numa grande varejista francesa, os SSDs voltaram com defeito mais vezes que os HDs até 2013, e depois menos
- A taxa de falha da Seagate no parque da Backblaze caiu de mais de 10% em 2013 para menos de 2%, enquanto a da HGST subiu para cerca de 3% à medida que as suas unidades envelheciam
- Toshiba e Seagate fabricam cada uma cerca de um terço das unidades da Backblaze, a Western Digital cerca de um quarto e a HGST menos de um décimo
- Numa varejista francesa, as quatro marcas de HD ainda vendidas em 2016 voltaram com defeito a taxas de 0,82% a 1,26%
- Numa varejista francesa, as taxas de devolução de SSDs caíram abaixo de 0,5% em todas as marcas ainda vendidas em 2016, depois que a da OCZ passou de 5%
- O HD Seagate de 3 TB que falhou muito na Backblaze foi devolvido a uma varejista francesa a 3,36% no lançamento, e a menos de 1% em 2016
- Nos dados de 2022 da Backblaze, as unidades de 10 TB foram as que mais falharam e as de 6 TB e 16 TB as que menos falharam; capacidade e idade da unidade andam juntas
- Setores defeituosos e cabeças com defeito foram as falhas mais comuns nos HDs enviados a laboratórios de recuperação
- SSDs populares de 1 TB têm classificação de 220 a 800 TB gravados, cinco destes onze de 600 TB
- A resistência nominal de um SSD cresce com a capacidade: cada vez que a capacidade dobra, o TBW mais ou menos dobra
- Cada bit a mais por célula de flash reduz os ciclos de gravação nominais: de cerca de 100.000 na SLC para cerca de 1.000 na QLC
- A Lexar dá a mesma ordem: a SLC aguenta cerca de 100 vezes mais ciclos de gravação que a QLC
- No teste de gravação até a morte da c't, publicado em 2017, um Samsung 850 Pro gravou 9,1 petabytes, cerca de 60 vezes a sua classificação
- Os fabricantes classificam os HDs de desktop para até 120 TB de leituras e gravações por ano, as unidades padrão para NAS para 180 TB e as unidades para NAS Pro e as corporativas para 550 TB
- Os HDs de desktop têm em geral garantia de dois anos e as unidades para NAS de três; as corporativas, as para NAS Pro e as WD_BLACK, de cinco
- As unidades padrão para NAS e para vigilância têm classificação de 1 a 1,2 milhão de horas de MTBF, e as unidades para NAS Pro, para vigilância com IA e as corporativas de 2,5 milhões; as linhas de desktop não informam nenhuma
- As unidades externas têm garantia de um a cinco anos; a Seagate dá à mesma unidade um ano nas Américas e três na Ásia-Pacífico
- Cerca de 72.000 unidades foram enviadas para recuperação de dados no Japão em 2024, contra 85.000 em 2018
- As unidades externas foram cerca de um quinto das unidades enviadas para recuperação no Japão de 2018 a 2024
- Um SSD corporativo desgastado guarda os dados por cerca de dois anos sem energia a 25 °C e por duas semanas a 55 °C
- As remessas de HDs caíram todos os anos, menos um, de 2014 a 2023, e depois se mantiveram em cerca de 124 milhões
- A capacidade de HDs remetida subiu de 458 exabytes em 2013 para 1.621 em 2025, enquanto as vendas em unidades caíam
- A Seagate remeteu 789 exabytes de capacidade em HDs no ano fiscal de 2026, sete vezes o total do ano fiscal de 2011
- A receita da Seagate por terabyte de capacidade em HDs caiu de US$ 31 no ano fiscal de 2018 para US$ 14 no ano fiscal de 2025
- A Seagate e a Western Digital remeteram cada uma de 146 milhões a 249 milhões de HDs por ano até o ano fiscal de 2016, e depois deixaram de informar as unidades
- Os SSDs passaram de menos de um terço dos notebooks novos em 2016 para quase todos em 2024
- A Western Digital e a Seagate remetem cada uma cerca de 40% dos HDs do mundo, e a Toshiba cerca de 17%
- O maior HD passou de 1 TB em 2007 para 44 TB em 2026
- A TrendForce esperava que os preços contratuais da flash saltassem de 85% a 90% num único trimestre, no início de 2026
- O preço que a Backblaze pagou por gigabyte de HD caiu 87,4% de 2009 a novembro de 2022, com um pico depois das enchentes de 2011
Metodologia
O que incluímos. Os relatórios Drive Stats da própria Backblaze, suas planilhas e seus arquivos de dados; estudos de campo revisados por pares e do setor (Google, Carnegie Mellon, Microsoft, NetApp, Alibaba, Facebook, Tencent, EMC, Universidade de Toronto, Universidade de Essex e outros); as fichas técnicas, as páginas de garantia e os avisos de suporte dos fabricantes; as normas do JEDEC; os registros de devolução e de falha publicados por varejistas e montadoras de computadores (hardware.fr para a varejista francesa LDLC, Puget Systems); os dados de casos e os preços publicados por laboratórios de recuperação e associações do setor; os estudos de arquivos e de órgãos de normalização sobre discos e fitas; documentos regulatórios e números de analistas sobre remessas; autos judiciais; e as reproduções de tudo isso nas páginas bem posicionadas nas buscas sobre vida útil de unidades, rastreadas até a origem. Alguns números são cálculos desta página sobre números publicados (totais por fabricante somados a partir das tabelas de modelos da Backblaze, MTBF convertido em taxa anual, valores lidos no gráfico de um estudo), identificados como derivados, com o método em cada registro. Têm preferência as estatísticas oficiais, as publicações dos próprios serviços de medição, os documentos regulatórios e as transcrições das empresas e os relatórios revisados por pares ou de analistas; pesquisas de fornecedores e reportagens só entram quando não existe fonte melhor e são identificadas como tal no conjunto de dados.
Como cada número foi verificado. Cada registro traz a frase exata ou a célula de tabela da fonte (a citação) e o ponto em que ela aparece (o localizador). Um pesquisador conferiu cada um com o documento de origem; depois, um script baixou de novo todas as fontes em 4 de novembro de 2026 e procurou a citação em cada uma. Os registros que o script não conseguiu confirmar só são mantidos se a conferência do pesquisador foi completa, e ficam marcados para revisão humana no conjunto de dados. As reproduções (um veículo posterior que cita um número anterior) são registradas como reproduções, com o número original ao lado.
O que excluímos. Vidas úteis sem nenhuma medição por trás (elas aparecem apenas como registros de reprodução, rastreados); números cuja única fonte é uma página de compilação, uma postagem de fórum ou uma fazenda de conteúdo; a cópia de um estudo quando o original pôde ser lido (uma cópia de slides extraída por máquina de um estudo de 2017 fica retida até que o artigo seja conferido); e quaisquer dados próprios da Zinstall. Quando uma fonte apresenta um número apenas numa forma que não conseguimos confirmar (por exemplo, um gráfico sem tabela de dados), o registro é marcado como não verificado e não é exportado.
Arredondamento e cálculos derivados. Os números são reproduzidos como foram publicados. Quando um serviço de medição publica duas casas decimais, as frases e as células das tabelas mostram uma casa decimal, com arredondamento da metade para cima, e o conjunto de dados mantém o valor publicado. Nas frases curtas do topo da página e de cada seção, contagens grandes e valores em dinheiro podem ser arredondados para dois ou três algarismos significativos; o número exato aparece nas frases completas da seção e no conjunto de dados. Os números derivados (uma variação entre dois meses, uma participação calculada a partir de duas contagens) dizem que são derivados e indicam os dados de partida. O número em negrito em cada frase é um auxílio de leitura, não uma alteração.
Atualizações. As fontes são conferidas de novo e novos números são acrescentados a cada trimestre, e as séries mensais dos serviços de medição são completadas à medida que saem; a próxima atualização está prevista para fevereiro de 2027 (o relatório anual de 2026 da Backblaze) e, depois, cada relatório trimestral da Backblaze. Correções são bem-vindas pela página de contato.
Medidas. Cada número é dado na medida de quem o publicou. Uma taxa de falha anualizada conta as falhas por unidade-ano de funcionamento; uma taxa de substituição conta as unidades substituídas, o que inclui unidades retiradas antes de morrer; uma taxa de devolução conta as unidades devolvidas a uma varejista como defeituosas; as contagens de um laboratório de recuperação descrevem apenas as unidades enviadas a ele. MTBF, especificações de AFR, TBW e garantias são classificações dos fabricantes, não vidas medidas. As unidades da Backblaze, e as da maioria dos estudos de campo, funcionam ininterruptamente em data centers.
Cite esta página
Zinstall. “Quanto tempo duram SSDs e HDs? Estatísticas de vida útil e de taxa de falha”. https://www.zinstall.com/pt/research/hard-drive-ssd-lifespan-statistics. Atualizado em 2026-11-04.
Perguntas frequentes
Quanto tempo duram os HDs?
A maioria dura bem mais de quatro anos nos parques medidos: cerca de 90% dos HDs dos data centers da Backblaze ainda funcionavam aos quatro anos e 65% aos seis, segundo a análise de dezembro de 2021 da empresa, e a idade em que as falhas atingem o pico subiu de cerca de três anos nos dados de 2013 para mais de dez em 2025. Nenhum estudo mediu as unidades de PCs domésticos da mesma forma; “3 a 5 anos” não tem nenhuma medição por trás.
Quanto tempo dura um SSD?
Os parques de SSDs em data centers falharam ou foram substituídos a cerca de 0,2% a 1,2% ao ano, e quase nunca por desgaste: num data center do Google, quase 98% das falhas de SSD ocorreram antes que as unidades tivessem usado metade dos seus ciclos de gravação nominais. Em testes de gravação até a morte, SSDs de consumo gravaram de centenas de terabytes a petabytes antes de morrer, muito além das suas classificações.
Os SSDs duram mais que os HDs?
Onde uma mesma organização usou os dois com a mesma idade, sim. As unidades de boot SSD da Backblaze falharam a 0,92% ao ano no quinto ano de serviço, contra 3,55% das suas unidades de boot HD, e os SSDs dos notebooks da Intel falharam a 0,61% ao ano, contra 4,85% dos HDs de notebook que ela usava antes.
Qual é uma taxa de falha normal para um HD?
Nos data centers da Backblaze, 1,36% dos HDs falharam em 2025. Estudos de campo mais antigos encontraram taxas mais altas: cerca de 3% das unidades substituídas por ano, em média, nos sistemas que a Carnegie Mellon estudou em 2007, várias vezes os 0,58% a 0,88% que as fichas técnicas indicavam, e 3,16% em nove data centers da Microsoft.
Quanto tempo dura um HD externo?
Nenhum fabricante ou parque publica uma taxa de falha de unidades externas. Entre 3.453 HDs externos com falha enviados a um laboratório de recuperação dos EUA de 2023 a 2026, 60,8% tinham funcionado menos de um ano; quedas, picos de energia e calor estavam entre as principais causas. As garantias vão de um a cinco anos.
Por quanto tempo um SSD consegue guardar dados sem energia?
A norma do JEDEC exige que um SSD de consumo no fim da sua resistência nominal guarde os dados por um ano sem energia a 30 °C, e que um SSD corporativo os guarde por três meses a 40 °C. Uma unidade nova guarda os dados por muito mais tempo: a Crucial fala em vários anos. O calor encurta esse tempo.
Qual marca de HD é a mais confiável?
Depende mais do modelo que da marca. Nos data centers da Backblaze, as unidades da Western Digital falharam a 0,60% ao ano em todo o tempo de serviço até meados de 2026 e as da HGST a 1,96%, enquanto uma análise de 2026 dos mesmos dados que manteve constantes a idade e a capacidade encontrou a HGST falhando a cerca de 41% da taxa da Seagate.
Um MTBF de 1,5 milhão de horas significa que uma unidade dura 171 anos?
Não. O MTBF descreve uma população: 1,5 milhão de horas significa que cerca de 0,58% de um grande grupo de unidades funcionando ininterruptamente falham a cada ano. A Seagate diz que as classificações de MTBF não prometem décadas de funcionamento e que o MTBF que suas unidades atingem em campo costuma ficar entre 50% e 60% do número projetado.
Fontes: Backblaze (2021-2026); USENIX, Proceedings of the 18th USENIX Conference on File and Storage Technologies; USENIX, Proceedings of the 19th USENIX Conference on File and Storage Technologies; ACM / IEEE, Proceedings of the International Conference; The Tech Report; Intel Corporation, on Intel's own fleet and Intel's own SSD product; Carnegie Mellon University; Rutgers University, GoDaddy and Microsoft; Secure Data Recovery Services; JEDEC Solid State Technology Association; Crucial; University of Essex and Sungkyunkwan University; Seagate Technology
Pronto para proteger todo o seu computador?
Fontes
Todos os documentos de origem dos números desta página, listados pela organização que os publicou. A linha de fontes abaixo de cada seção liga cada organização ao seu documento, e o conjunto de dados traz a citação literal e o localizador de cada estatística.
Mostrar todas as 453 fontes
Carregando a lista de fontes. Ela também está publicada como arquivo: JSON.
reembolso Comprar